Honey, I Shrunk the Sample Covariance Matrix
1. Introduction
Markowitz가 평균–분산 최적화 MVO를 제시한 이후, 평균–분산 모형은 투자할 종목과 포트폴리오 비중을 결정하는 가장 체계적인 방법 가운데 하나로 사용되어 왔다.
평균–분산 최적화에는 두 가지 핵심 입력값이 필요하다.
첫 번째는 각 종목의 기대초과수익률이다. 이는 미래 가격 움직임을 예측하는 포트폴리오 매니저의 능력을 반영한다.
두 번째는 종목 수익률의 공분산행렬이다. 공분산행렬은 각 종목의 변동성과 종목 사이의 동조성을 나타내며, 포트폴리오의 위험을 통제하는 역할을 한다.
실제 자산운용에서는 이러한 최적화 문제에 여러 제약조건이 추가된다. 많은 포트폴리오 매니저는 공매도가 금지된 상태에서 운용하며, 일정한 비중을 가진 주가지수를 벤치마크로 사용한다. 따라서 매니저는 벤치마크보다 높은 수익률을 얻는 동시에 추적오차를 통제해야 한다.
표본 공분산행렬의 문제
주식수익률의 공분산행렬을 추정하는 일반적인 방법은 과거 수익률 자료를 수집하여 표본 공분산행렬을 계산하는 것이다.
그러나 투자대상 종목의 수가 많고 사용할 수 있는 과거 관측치의 수가 상대적으로 적으면 표본 공분산행렬에는 상당한 추정오차가 포함된다. 이는 실제 금융자료에서 흔히 발생하는 문제이다.
예를 들어 500개 종목의 위험을 추정하면서 최근 60개월의 수익률만 사용한다면, 추정해야 하는 공분산계수의 수에 비해 관측치가 크게 부족하다. 이 경우 표본 공분산행렬의 개별 원소를 정확하게 추정하기 어렵다.
특히 표본 공분산행렬에서 매우 크거나 매우 작게 나타난 값은 실제 공분산이 극단적이어서가 아니라, 추정오차가 크게 포함되어 있기 때문에 극단적으로 관측되었을 가능성이 높다.
문제는 MVO가 바로 이러한 극단적인 값에 가장 민감하게 반응한다는 점이다.
MVO는 높은 기대수익률과 낮은 위험을 얻을 수 있는 조합을 찾는다. 따라서 공분산행렬에 포함된 극단적인 값을 실제 정보로 받아들이고, 해당 값에 크게 의존하는 포트폴리오를 구성할 수 있다.
결과적으로 추정오차가 가장 큰 공분산계수에 가장 큰 투자비중이 부여되는 현상이 발생한다.
Michaud는 이러한 현상을 오차 극대화라고 설명하였다.
MVO는 입력값에 포함된 오차를 이용하여 지나치게 극단적인 포트폴리오를 만들어 낼 수 있고, 이는 포트폴리오의 실제 추적오차를 증가시키고, 포트폴리오 매니저가 가진 종목선택 능력이 실제 운용성과에 충분히 반영되지 못하게 한다.
기존 위험모형의 한계
표본 공분산행렬의 문제를 해결하기 위해 APT나 BARRA와 같은 기업들은 포트폴리오 최적화에 더 적합하다고 주장하는 별도의 공분산 추정방법을 제공해 왔다.
그러나 이러한 상업적 위험모형을 사용하면 자산운용사는 외부 업체에 지속해서 의존해야 하며, 이에 따른 비용을 부담해야 한다.
또한 구체적인 추정방식이 공개되지 않는 경우가 많아 모형의 작동 원리를 독립적으로 검토하거나 재현하기 어렵다는 한계가 있다.
따라서 누구나 확인하고 구현할 수 있으면서도 표본 공분산행렬보다 안정적인 공분산 추정방법이 필요하다.
Shrinkage의 기본 아이디어
이 논문은 표본 공분산행렬을 대체할 방법으로 shrinkage를 제안한다.
Shrinkage의 핵심은 표본 공분산행렬의 극단적인 추정값을 보다 중심적인 값으로 끌어당기는 것이다.
표본 공분산행렬에서 지나치게 큰 값에는 양의 추정오차가 많이 포함되어 있을 가능성이 있으므로 그 값을 낮춘다.
반대로 지나치게 작은 값에는 음의 추정오차가 많이 포함되어 있을 가능성이 있으므로 그 값을 높인다.
정리하자면 shrinkage는 표본 공분산행렬의 모든 정보를 버리지 않고 표본자료가 제공하는 정보를 유지하면서, 추정오차에 의해 지나치게 극단적으로 나타난 값을 보다 안정적인 방향으로 조정하는 방법이다.
Shrinkage에서 결정해야 하는 것
Shrinkage를 적용하려면 두 가지 중요한 문제를 해결해야 한다.
첫 번째는 표본 공분산행렬을 어느 방향으로 축소할 것인지이다. 표본 공분산행렬이 가까워져야 할 구조화된 공분산행렬을 shrinkage target이라고 한다.
두 번째는 표본 공분산행렬을 shrinkage target 방향으로 얼마나 강하게 이동시킬 것인지이다. 이를 shrinkage intensity 또는 shrinkage constant라고 한다.
Shrinkage 강도가 너무 작으면 표본 공분산행렬의 추정오차가 충분히 제거되지 않는다.
반대로 shrinkage 강도가 너무 크면 표본자료에 포함된 유용한 정보를 지나치게 버리고, 구조화된 모형에 과도하게 의존하게 된다.
따라서 핵심은 표본 공분산행렬과 구조화된 추정량 사이에서 적절한 절충점을 찾는 것이다.
이 논문은 shrinkage target으로 모든 종목 사이의 상관계수가 동일하다고 가정하는 constant-correlation model을 사용한다.
또한 추정된 공분산행렬과 실제 공분산행렬 사이의 기대거리를 최소화하도록 최적 shrinkage intensity를 결정하는 통계적 공식을 제시한다.
이 논문의 목적은 단순히 shrinkage가 유용하다고 주장하는 데 있지 않다.
먼저 표본 공분산행렬을 어느 대상 방향으로 축소해야 하는지에 대한 구체적인 shrinkage target을 제시한다.
다음으로 표본 공분산행렬과 shrinkage target을 어느 정도의 비율로 결합해야 하는지 결정하는 최적 shrinkage intensity의 추정공식을 제시한다.
마지막으로 실제 주식시장 자료를 이용한 표본 외 분석을 통해 shrinkage 공분산행렬의 성과를 표본 공분산행렬과 비교한다.
실증분석 결과 shrinkage 추정량은 벤치마크 대비 추적오차를 줄이고, 액티브 포트폴리오의 실현 정보비율을 높이는 것으로 나타난다.
중요한 점은 기존 포트폴리오 최적화 과정을 전면적으로 변경할 필요가 없다는 것이다.
기대수익률의 추정방법, 최적화 목적함수 및 포트폴리오 제약조건은 그대로 유지하고, 기존의 표본 공분산행렬을 shrinkage 공분산행렬로 교체하기만 하면 된다.
통계학에서 포트폴리오 관리로
초기 방법들은 투자대상 종목의 수가 과거 수익률 관측치의 수보다 많을 때 제대로 적용되기 어려웠다. 종목의 수가 크고 관측기간이 상대적으로 짧은 실제 포트폴리오 운용에서는 이러한 상황이 자주 발생한다.
Jagannathan과 Ma는 공매도 금지 제약조건을 적용한 평균–분산 최적화가 표본 공분산행렬에 일종의 shrinkage를 암묵적으로 적용하는 효과를 가진다는 점을 보였고, 이는 shrinkage가 포트폴리오 비중의 안정성을 높일 수 있음을 의미한다.
그러나 제약조건이 우연히 만들어 내는 암묵적인 shrinkage에 의존하기보다는, 공분산행렬을 명시적으로 조정하고 통계적으로 계산한 최적 shrinkage intensity를 적용하는 것이 더 체계적이다.
따라서 이 논문은 통계학에서 발전해 온 shrinkage 개념을 실제 액티브 포트폴리오 운용에 직접 적용하는 방법을 제시한다.
이후에는 먼저 벤치마크를 기준으로 한 포트폴리오 최적화 문제를 수학적으로 정의한다.
그다음 표본 공분산행렬과 구조화된 공분산행렬을 결합하는 shrinkage 원리를 설명하고, shrinkage target과 최적 shrinkage intensity를 구체적으로 제시한다.
마지막으로 실제 주식수익률 자료를 이용한 표본 외 분석을 통해 shrinkage 추정량이 포트폴리오의 추적오차, 정보비율 및 회전율에 미치는 영향을 살펴본다.
2. Formal Description of the Problem
이 장에서는 주식 포트폴리오 운용에서 포트폴리오 매니저가 해결해야 하는 최적화 문제를 수학적으로 정의한다.
논문은 다수의 개별 주식으로 구성된 주가지수를 벤치마크로 사용하는 경우를 다룬다. 벤치마크는 시가총액 가중지수처럼 총 $N$개의 주식으로 구성된 가중지수이며, 포트폴리오 매니저는 벤치마크에 포함된 모든 주식에 투자할 수 있다고 가정한다.
이 논문에서 초과수익률은 무위험수익률이 아니라 선택한 벤치마크의 수익률을 기준으로 정의한다. 따라서 매니저의 목적은 단순히 포트폴리오의 절대수익률을 높이는 것이 아니라, 벤치마크보다 높은 기대수익률을 얻으면서 벤치마크 대비 위험인 추적오차를 최소화하는 것이다.
2.1 포트폴리오 비중의 정의
먼저 다음 기호를 정의한다.
| 기호 | 의미 |
|---|---|
| $w_B$ | $N$개 주식으로 구성된 벤치마크 비중벡터 |
| $x$ | 벤치마크 대비 액티브 비중벡터 |
| $w_P$ | 실제 포트폴리오 비중벡터 |
| $y$ | 주식수익률 벡터 |
| $\mu$ | 주식의 기대수익률 벡터 |
| $\alpha$ | 벤치마크 대비 개별 주식의 기대초과수익률 벡터 |
| $\Sigma$ | 주식수익률의 공분산행렬 |
| $\mathbf{1}$ | 모든 원소가 1인 $N$차원 벡터 |
실제 포트폴리오 비중은 벤치마크 비중과 액티브 비중의 합으로 나타낸다.
\[w_P=w_B+x\]따라서 액티브 비중은 실제 포트폴리오와 벤치마크 비중의 차이이다.
\[x=w_P-w_B\]개별 주식 $i$에 대해 $x_i>0$이면 벤치마크보다 해당 주식을 더 많이 보유하는 비중확대를 의미한다.
반대로 $x_i<0$이면 벤치마크보다 해당 주식을 적게 보유하는 비중축소를 의미한다.
여기서 $x_i<0$이라고 해서 반드시 해당 주식을 공매도한 것은 아니다. 실제 포트폴리오 비중은 $w_{P,i}=w_{B,i}+x_i$이므로, 이 값이 0 이상이면 해당 주식을 벤치마크보다 적게 보유할 뿐이다.
주식수익률 벡터를 $y$라고 하면 기대수익률 벡터는 다음과 같다.
\[\mu=E(y)\]벤치마크의 기대수익률은 다음과 같다.
\[\mu_B=w_B^\top\mu\]각 주식의 벤치마크 대비 기대초과수익률은 해당 주식의 기대수익률에서 벤치마크 기대수익률을 차감한 값이다.
\[\alpha=\mu-\mu_B\mathbf{1}=\mu-\mathbf{1}w_B^\top\mu\]따라서 $\alpha_i$는 $i$번째 주식이 벤치마크보다 얼마나 높은 기대수익률을 가지는지를 나타낸다.
\[\alpha_i=\mu_i-\mu_B\]2.2 벤치마크와 포트폴리오의 기대수익률 및 분산
| 구분 | 기대수익률 | 분산 또는 위험 | 의미 |
|---|---|---|---|
| 벤치마크 포트폴리오 | $\mu_B = w_B^\top \mu$ | $\sigma_B^2 = w_B^\top \Sigma w_B$ | 벤치마크 포트폴리오의 기대수익률과 분산 |
| 실제 포트폴리오 | $\mu_P = w_P^\top \mu$ | $\sigma_P^2 = w_P^\top \Sigma w_P$ | 실제로 보유한 포트폴리오의 기대수익률과 분산 |
| 액티브 포트폴리오 | $\mu_E = x^\top \mu$ | $\sigma_E^2 = x^\top \Sigma x$ | 실제 포트폴리오와 벤치마크 간 수익률 차이의 기대값과 분산 |
| 추적오차 | - | $\sigma_E = \sqrt{x^\top \Sigma x}$ | 실제 포트폴리오 수익률과 벤치마크 수익률 차이의 표준편차 |
2.3 완전투자 조건
실제 포트폴리오는 전체 자금을 모두 투자해야 하므로 포트폴리오 비중의 합은 1이어야 한다.
\[w_P^\top\mathbf{1}=1\]벤치마크 비중의 합도 1이다.
\[w_B^\top\mathbf{1}=1\]한편 $w_P=w_B+x$이므로 완전투자 조건에 이를 대입하면 다음과 같다.
\[(w_B+x)^\top\mathbf{1}=1\]식을 전개하면 다음과 같다.
\[w_B^\top\mathbf{1}+x^\top\mathbf{1}=1\]벤치마크 비중의 합이 1이므로 다음 관계를 얻는다.
\[x^\top\mathbf{1}=0\]즉 액티브 비중의 합은 반드시 0이어야 한다.
특정 주식의 비중을 벤치마크보다 높이려면 다른 주식의 비중을 그만큼 낮춰야 한다. 따라서 액티브 포트폴리오는 양의 비중과 음의 비중을 동시에 가지는 롱–숏 포트폴리오의 형태로 나타난다.
다만 이것은 벤치마크 대비 상대적인 롱–숏 포지션이다. 실제 포트폴리오는 이후에 설명할 공매도 금지 조건에 따라 모든 종목의 최종 비중이 0 이상이어야 한다.
2.4 포트폴리오 기대수익률의 분해
실제 포트폴리오의 기대수익률에 $w_P=w_B+x$를 대입하면 다음과 같다.
\[\mu_P=(w_B+x)^\top\mu\]이를 전개하면 다음과 같다.
\[\mu_P=w_B^\top\mu+x^\top\mu\]각 항의 정의를 이용하면 실제 포트폴리오의 기대수익률은 다음과 같이 분해된다.
\[\mu_P=\mu_B+\mu_E\]즉 실제 포트폴리오의 기대수익률은 벤치마크의 기대수익률과 액티브 포트폴리오의 기대초과수익률을 합한 값이다.
또한 액티브 비중의 합이 0이므로 $x^\top\mu$와 $x^\top\alpha$는 같다.
\[x^\top\alpha=x^\top(\mu-\mu_B\mathbf{1})\]식을 전개하면 다음과 같다.
\[x^\top\alpha=x^\top\mu-\mu_Bx^\top\mathbf{1}\]$x^\top\mathbf{1}=0$이므로 다음 관계가 성립한다.
\[x^\top\alpha=x^\top\mu=\mu_E\]따라서 액티브 포트폴리오의 기대초과수익률은 다음 두 방식으로 동일하게 표현할 수 있다.
\[\mu_E=x^\top\mu=x^\top\alpha\]2.5 포트폴리오 분산의 분해
실제 포트폴리오의 분산에 $w_P=w_B+x$를 대입하면 다음과 같다.
\[\sigma_P^2=(w_B+x)^\top\Sigma(w_B+x)\]이를 전개하면 다음과 같다.
\[\sigma_P^2=w_B^\top\Sigma w_B+w_B^\top\Sigma x+x^\top\Sigma w_B+x^\top\Sigma x\]공분산행렬 $\Sigma$는 대칭행렬이므로 다음이 성립한다.
\[w_B^\top\Sigma x=x^\top\Sigma w_B\]따라서 실제 포트폴리오의 분산은 다음과 같이 정리된다.
\[\sigma_P^2=\sigma_B^2+2w_B^\top\Sigma x+\sigma_E^2\]첫 번째 항 $\sigma_B^2$는 벤치마크 자체의 위험이다.
두 번째 항 $2w_B^\top\Sigma x$는 벤치마크와 액티브 포트폴리오 사이의 공분산에 해당한다.
세 번째 항 $\sigma_E^2$는 액티브 포트폴리오의 추적오차 분산이다.
실제 포트폴리오의 전체 위험은 벤치마크 위험과 액티브 위험을 단순히 더한 값이 아니라는 점에 주의하자. 벤치마크와 액티브 포트폴리오 사이의 공분산도 함께 반영해야 한다.
이 논문은 벤치마크 대비 액티브 운용을 다루므로, 최적화의 직접적인 위험 측정치로 전체 포트폴리오 분산 $\sigma_P^2$가 아니라 추적오차 분산 $\sigma_E^2$를 사용한다.
2.6 공매도 금지 조건
액티브 비중 $x$에는 벤치마크 대비 기준이기 때문에 양수와 음수가 모두 포함될 수 있지만, 실제 포트폴리오에서는 공매도가 금지되어 있다고 가정한다.
따라서 실제 포트폴리오의 모든 비중은 0 이상이어야 한다.
\[w_P\geq0\]$w_P=w_B+x$를 대입하면 다음과 같다.
\[w_B+x\geq0\]이를 $x$에 대해 정리하면 다음과 같다.
\[x\geq-w_B\]이 조건은 매니저가 특정 주식을 벤치마크 비중보다 낮게 보유할 수는 있지만, 최대 비중축소는 해당 주식의 벤치마크 비중만큼으로 제한된다는 뜻이다.
예를 들어 특정 주식의 벤치마크 비중이 4%라면 해당 주식의 액티브 비중은 최소 $-4\%$이다.
\[w_{B,i}=0.04\Rightarrow x_i\geq-0.04\]이 경우 해당 주식의 실제 포트폴리오 비중은 0이 된다.
\[w_{P,i}=w_{B,i}+x_i=0.04-0.04=0\]그보다 더 낮은 액티브 비중은 실제 공매도를 의미하므로 허용되지 않는다.
Grinold and Kahn(2000)은 이러한 공매도 금지 조건이 액티브 포트폴리오의 성과를 제한할 수 있다고 설명한다.
특히 벤치마크가 시가총액 가중지수이고 종목의 수 $N$이 많으면 대부분의 종목이 매우 작은 벤치마크 비중을 가진다. 따라서 매니저가 부정적으로 전망하는 종목이 있더라도 비중을 줄일 수 있는 범위가 작다.
반면 대형주의 벤치마크 비중은 크기 때문에 해당 종목에 대해서는 상대적으로 큰 폭의 비중축소가 가능하다.
이러한 비대칭성은 매니저가 가진 부정적인 전망을 포트폴리오에 충분히 반영하지 못하게 할 수 있다.
2.7 종목별 최대 비중 조건
실제 자산운용에서는 특정 주식에 지나치게 큰 비중이 집중되는 것을 방지하기 위해 종목별 최대 비중을 설정하는 경우가 많다.
개별 종목의 최대 허용 비중을 $c$라고 하면 다음 조건이 적용된다.
\[w_P\leq c\mathbf{1}\]예를 들어 $c=0.10$이면 어떤 주식도 전체 포트폴리오에서 10%를 초과하여 보유할 수 없다.
$w_P=w_B+x$를 대입하면 다음과 같다.
\[w_B+x\leq c\mathbf{1}\]이를 액티브 비중 $x$에 대해 정리하면 다음과 같다.
\[x\leq c\mathbf{1}-w_B\]따라서 개별 주식의 액티브 비중에는 다음의 하한과 상한이 동시에 존재한다.
\[-w_B\leq x\leq c\mathbf{1}-w_B\]하한은 공매도 금지 조건에서 발생하고, 상한은 종목별 최대 보유비중 조건에서 발생한다.
2.8 포트폴리오 최적화 문제
앞에서 정의한 조건들을 이용하면 포트폴리오 매니저의 최적화 문제를 다음과 같이 나타낼 수 있다.
\[\begin{aligned}\min_x\quad &x^\top\Sigma x\\\text{subject to}\quad &x^\top\alpha\geq g\\&x^\top\mathbf{1}=0\\&x\geq-w_B\\&x\leq c\mathbf{1}-w_B\end{aligned}\qquad (1)\]목적함수는 다음과 같다.
\[x^\top\Sigma x\]이는 액티브 포트폴리오의 추적오차 분산이다. 따라서 매니저는 목표 기대초과수익률을 달성하면서 추적오차를 최소화한다.
첫 번째 제약조건은 액티브 포트폴리오의 기대초과수익률이 매니저가 정한 목표수익률 $g$ 이상이어야 한다는 조건이다.
\[x^\top\alpha\geq g\]$g$는 벤치마크 대비 목표 기대초과수익률이다. 논문에서는 전형적인 예로 연 300bp를 제시한다.
\[300\text{ bp}=3\%\]두 번째 제약조건은 액티브 비중의 합이 0이어야 한다는 완전투자 조건이다.
\[x^\top\mathbf{1}=0\]세 번째 제약조건은 실제 포트폴리오에서 공매도를 허용하지 않는다는 조건이다.
\[x\geq-w_B\]네 번째 제약조건은 개별 주식의 실제 포트폴리오 비중이 최대 허용 비중 $c$를 초과할 수 없다는 조건이다.
\[x\leq c\mathbf{1}-w_B\]2.9 최적화 문제의 입력값
포트폴리오 매니저는 목표 기대초과수익률 $g$와 종목별 최대 비중 $c$를 결정한다.
벤치마크 비중벡터 $w_B$는 주어진 시장지수로부터 관측할 수 있다.
따라서 최적화를 실행하기 위해 추가로 추정해야 하는 핵심 입력값은 다음 두 가지이다.
첫 번째는 개별 주식의 기대초과수익률 벡터 $\alpha$이다.
두 번째는 주식수익률의 공분산행렬 $\Sigma$이다.
모든 입력값을 이차계획법 기반의 최적화 프로그램에 입력하면 프로그램은 최적 액티브 비중벡터 $x$를 계산한다.
최종 포트폴리오 비중은 다음과 같이 얻는다.
\[w_P=w_B+x\]최적화 결과의 품질은 입력한 $\alpha$와 $\Sigma$의 추정 정확도에 크게 의존한다.
이 논문의 목적은 공분산행렬 $\Sigma$를 어떻게 안정적으로 추정할 것인지에 집중한다.
특히 추정오차가 큰 표본 공분산행렬을 그대로 사용하는 대신, 표본 공분산행렬과 구조화된 공분산행렬을 결합한 shrinkage 추정량을 제시한다.
3. Shrinkage Estimator of the Covariance Matrix
이 장에서는 실제 공분산행렬 $\Sigma$를 추정하기 위해 저자들이 제안하는 shrinkage 추정량을 설명한다.
Shrinkage의 핵심은 서로 반대되는 장단점을 가진 두 공분산 추정량을 결합하는 것이다.
첫 번째 추정량은 자료의 구조를 거의 제한하지 않는 표본 공분산행렬 $S$이다.
두 번째 추정량은 강한 구조를 가정하는 공분산행렬 $F$이다.
표본 공분산행렬은 실제 자료의 특성을 유연하게 반영하지만 추정오차가 크다. 반대로 구조화된 추정량은 추정오차가 작지만 잘못된 구조를 가정하여 편향될 수 있다.
Shrinkage는 두 추정량을 적절한 비율로 결합하여 추정오차와 편향 사이의 절충점을 찾는다.
3.1 Shrinkage Principle
표본 공분산행렬
먼저 주식수익률의 표본 공분산행렬 $S$를 생각하자.
$N$개 주식의 수익률을 $T$개 시점에서 관측했다면 표본 공분산행렬은 과거 수익률 자료를 이용하여 계산할 수 있다.
표본 공분산행렬의 가장 큰 장점은 계산이 간단하다는 것이다.
또한 적절한 표본 공분산 공식을 사용하면 표본 공분산행렬은 실제 공분산행렬 $\Sigma$의 unbiased 추정량이다.
\[E(S)=\Sigma\]unbiased는 동일한 표본추출을 여러 번 반복하여 표본 공분산행렬을 계산했을 때 그 평균이 실제 공분산행렬과 같다는 의미이다.
그러나 unbiased만으로 개별 표본에서 계산된 공분산행렬이 정확하다는 것이 보장되지는 않는다.
투자대상 종목의 수 $N$이 관측치의 수 $T$와 비슷하거나 더 크면 표본 공분산행렬에는 많은 추정오차가 포함된다.
\[N\approx T\quad\text{또는}\quad N>T\]이는 실제 금융자료에서 흔히 발생하는 상황이다.
예를 들어 500개 종목의 공분산행렬을 최근 60개월의 수익률로 추정한다고 하자.
공분산행렬에는 각 종목의 분산뿐 아니라 모든 종목 쌍 사이의 공분산도 포함된다.
- 각 종목의 분산: $500$개
- 서로 다른 두 종목 사이의 공분산: $\binom{500}{2}=124{,}750$개
공분산행렬은 대칭이므로 $\mathrm{Cov}(r_i,r_j)$와 $\mathrm{Cov}(r_j,r_i)$는 같은 값이다. 따라서 서로 다르게 추정해야 하는 원소의 수는 다음과 같다.
\[500+\binom{500}{2}= \frac{500(500+1)}{2}= 125{,}250\]그러나 이러한 125,250개의 분산과 공분산을 추정하는 데 사용되는 관측 기간은 최근 60개월뿐이다. 즉, 추정해야 하는 값의 수에 비해 관측 기간이 매우 짧기 때문에 표본 공분산행렬의 추정오차가 커질 수 있다.
| 특징 | 내용 |
|---|---|
| 구조 | 별도의 구조를 거의 가정하지 않음 |
| 장점 | 계산이 간단하고 unbiased임 |
| 단점 | 종목 수가 많을 때 추정오차가 큼 |
| 통계적 성격 | 편향은 작지만 분산이 큼 |
표본 공분산행렬은 자료에 매우 유연하게 적합되지만, 그만큼 표본에 포함된 우연한 변동과 잡음에도 민감하다.
구조화된 공분산 추정량
표본 공분산행렬의 대안으로 강한 구조를 가진 공분산 추정량을 사용할 수 있다.
대표적인 예는 Sharpe(1963)의 단일요인모형이다.
단일요인모형에서는 각 주식수익률이 하나의 공통요인과 개별 주식에 고유한 오차로 구성된다고 가정한다.
\[y_{it}=\alpha_i+\beta_i f_t+\varepsilon_{it}\]각 기호의 의미는 다음과 같다.
| 기호 | 의미 |
|---|---|
| $y_{it}$ | 시점 $t$에서 주식 $i$의 수익률 |
| $\alpha_i$ | 공통요인으로 설명되지 않는 주식 $i$의 평균적인 수익률 |
| $\beta_i$ | 공통요인 변화에 대한 주식 $i$의 민감도 |
| $f_t$ | 시점 $t$의 공통요인 수익률 |
| $\varepsilon_{it}$ | 공통요인으로 설명되지 않는 주식 $i$의 고유한 오차 |
예를 들어 공통요인을 시장수익률로 설정하면, $\beta_i$는 시장수익률이 변할 때 주식 $i$의 수익률이 얼마나 민감하게 반응하는지를 나타낸다.
단일요인모형에서는 서로 다른 주식의 잔차가 서로 상관되지 않는다고 가정한다.
\[\mathrm{Cov}(\varepsilon_i,\varepsilon_j)=0 \qquad (i\neq j)\]따라서 서로 다른 두 주식의 공분산은 공통요인을 통해 다음과 같이 표현된다.
\[\mathrm{Cov}(y_i,y_j)= \beta_i\beta_j\sigma_f^2\]여기서 $\sigma_f^2$는 공통요인 $f$의 분산이다.
각 주식의 분산은 다음과 같다.
\[\mathrm{Var}(y_i)= \beta_i^2\sigma_f^2+\sigma_{\varepsilon_i}^2\]여기서 $\sigma_{\varepsilon_i}^2$는 주식 $i$의 잔차분산으로, 공통요인으로 설명되지 않는 개별 주식 고유의 위험을 나타낸다.
이러한 구조를 이용하면 모든 종목 사이의 공분산을 각각 직접 추정할 필요가 없다. 각 주식의 요인 민감도 $\beta_i$, 잔차분산 $\sigma_{\varepsilon_i}^2$, 공통요인의 분산 $\sigma_f^2$만 추정하면 되므로 추정해야 하는 모수의 수가 크게 줄어든다.
그 결과 구조화된 공분산 추정량은 일반적으로 표본 공분산행렬보다 추정오차가 작다.
그러나 실제 주식수익률의 공분산구조가 가정한 단일요인모형과 다르다면, 구조화된 추정량은 실제 공분산행렬을 체계적으로 잘못 추정할 수 있다.
즉 구조화된 추정량에는 모형설정 오류가 발생할 수 있다.
| 특징 | 내용 |
|---|---|
| 구조 | 소수의 모수로 강한 구조를 가정함 |
| 장점 | 추정오차가 작고 안정적임 |
| 단점 | 구조가 잘못되면 편향이 커짐 |
| 통계적 성격 | 분산은 작지만 편향될 수 있음 |
편향과 추정오차의 절충
표본 공분산행렬 $S$는 실제 자료를 유연하게 반영하므로 편향이 작지만 추정오차가 크다.
구조화된 추정량 $F$는 추정해야 하는 모수가 적어 추정오차는 작지만, 모형의 구조가 실제 공분산행렬과 다르면 편향이 발생한다.
| 추정량 | 편향 | 추정분산 | 특징 |
|---|---|---|---|
| 표본 공분산행렬 $S$ | 낮음 | 높음 | 유연하지만 불안정함 |
| 구조화된 추정량 $F$ | 높을 수 있음 | 낮음 | 안정적이지만 모형설정 오류가 존재할 수 있음 |
좋은 공분산 추정량을 만들기 위해서는 두 극단 가운데 하나를 선택하는 것이 아니라, 편향과 추정분산 사이에서 적절한 절충점을 찾아야 한다.
\[\text{추정오차}=\text{분산에 의한 오차}+\text{편향에 의한 오차}\]Shrinkage는 이러한 bias–variance trade-off를 이용하는 방법이다.
다요인 위험모형
실무에서 일반적으로 사용되는 공분산 추정방법은 다요인모형이다.
다요인모형은 Sharpe의 단일요인모형보다 여러 개의 요인을 사용한다.
요인의 수가 증가하면 모형이 실제 주식수익률의 공분산구조를 더 유연하게 표현할 수 있으므로 편향이 감소할 수 있다.
그러나 추정해야 하는 모수의 수도 증가하므로 추정오차는 커진다.
\[\text{요인 수 증가}\Rightarrow\text{모형 유연성 증가}\Rightarrow\text{편향 감소}\] \[\text{요인 수 증가}\Rightarrow\text{추정 모수 증가}\Rightarrow\text{추정오차 증가}\]따라서 다요인모형에서도 어떤 요인을 선택하고 몇 개의 요인을 포함할 것인지 결정해야 한다.
Shrinkage 추정량
이 논문은 요인의 종류와 개수를 선택하는 방식과 다른 접근법을 제시한다.
먼저 구조를 거의 가정하지 않는 표본 공분산행렬을 $S$라고 하자.
강한 구조를 가진 공분산 추정량을 $F$라고 하자.
저자들은 두 추정량의 convex linear combination을 계산한다.
\[\hat{\Sigma}(\delta)=\delta F+(1-\delta)S\]여기서 shrinkage constant $\delta$는 다음 범위의 값을 가진다.
\[0\leq\delta\leq1\]$\delta$는 구조화된 추정량 $F$에 부여하는 비중이다.
반대로 $1-\delta$는 표본 공분산행렬 $S$에 부여하는 비중이다.
$\delta=0$이면 shrinkage를 전혀 적용하지 않고 표본 공분산행렬만 사용한다.
$\delta=1$이면 표본 공분산행렬을 전혀 사용하지 않고 구조화된 추정량만 사용한다.
$0<\delta<1$이면 두 추정량의 정보를 함께 이용한다.
\[0<\delta<1\Rightarrow\hat{\Sigma}(\delta)=\delta F+(1-\delta)S\]이처럼 표본 공분산행렬 $S$를 구조화된 추정량 $F$의 방향으로 이동시키는 것을 shrinkage라고 한다.
구조화된 추정량 $F$를 shrinkage target이라고 하고, 이동하는 정도를 결정하는 $\delta$를 shrinkage constant 또는 shrinkage intensity라고 한다.
각 공분산 원소의 관점에서 보면 shrinkage 추정량은 다음과 같다.
\[\hat{\sigma}_{ij}^{\mathrm{Shrink}}=\delta f_{ij}+(1-\delta)s_{ij}\]표본 공분산 $s_{ij}$가 target의 값 $f_{ij}$보다 크면 shrinkage를 적용한 값은 아래로 내려간다.
\[s_{ij}>f_{ij}\Rightarrow f_{ij}<\hat{\sigma}_{ij}^{\mathrm{Shrink}}<s_{ij}\]반대로 표본 공분산 $s_{ij}$가 target의 값 $f_{ij}$보다 작으면 shrinkage를 적용한 값은 위로 올라간다.
\[s_{ij}<f_{ij}\Rightarrow s_{ij}<\hat{\sigma}_{ij}^{\mathrm{Shrink}}<f_{ij}\]따라서 shrinkage는 표본 공분산행렬의 극단적인 원소들을 구조화된 중심값 방향으로 끌어당긴다.
Shrinkage의 장점은 서로 다른 종류의 오차를 가진 두 추정량을 결합하면 둘 중 하나만 사용했을 때보다 더 좋은 추정량을 얻을 수 있다는 데 있다.
표본 공분산행렬에는 모형설정에 따른 편향은 거의 없지만 표본의 우연한 변동이 크게 반영되고 구조화된 추정량에는 표본의 우연한 변동이 적게 반영되지만 모형구조가 실제와 다를 수 있다.
두 추정량을 적절히 결합하면 표본 공분산행렬의 추정오차를 줄이면서 구조화된 추정량의 편향에 지나치게 의존하지 않을 수 있다.
저자들은 이를 와인 두 병만 마시거나 스테이크 두 개만 먹는 극단보다, 와인 한 병과 스테이크 한 개를 선택하는 절충이 더 낫다는 비유로 설명한다.
3.2 Shrinkage Target
좋은 shrinkage target은 두 가지 조건을 동시에 만족해야 한다.
첫째, 추정해야 하는 자유모수의 수가 적어야 한다.
\[\text{자유모수 감소}\Rightarrow\text{추정오차 감소}\]둘째, 실제 공분산행렬의 중요한 특징을 반영할 수 있어야 한다.
구조가 지나치게 단순하면 추정오차는 작아지지만 실제 공분산행렬과 크게 달라져 편향이 커질 수 있다.
반대로 구조가 지나치게 복잡하면 실제 공분산행렬을 유연하게 표현할 수 있지만 표본 공분산행렬과 마찬가지로 추정오차가 커질 수 있다.
따라서 target은 단순하면서도 주식수익률 공분산의 핵심적인 특성을 보존해야 한다.
Ledoit and Wolf(2003)는 Sharpe의 단일요인모형을 shrinkage target으로 제시하였다.
이 논문에서는 그보다 구현이 간단한 constant-correlation model을 shrinkage target으로 사용한다.
저자들의 경험에 따르면 constant-correlation model은 단일요인모형과 비슷한 성과를 보이면서 계산은 더 간단하다는 결론을 도출했다.
Constant-correlation model
Constant-correlation model은 모든 주식 쌍의 상관계수가 동일하다고 가정한다.
\[\rho_{ij}=\bar{\rho}\quad\text{for all }i\neq j\]실제로 모든 주식의 상관계수가 정확히 같다는 뜻은 아니다.
이 가정은 개별 주식 쌍에서 불안정하게 추정된 상관계수를 그대로 사용하지 않고, 전체 주식 쌍에서 계산한 평균적인 상관관계를 이용하겠다는 구조화 가정이다.
표본 공분산행렬의 원소를 $s_{ij}$라고 하자.
$i$번째 주식과 $j$번째 주식의 표본상관계수는 다음과 같다.
\[r_{ij}=\frac{s_{ij}}{\sqrt{s_{ii}s_{jj}}}\]모든 서로 다른 주식 쌍의 표본상관계수를 평균하여 공통 상관계수를 추정한다.
\[\bar{r}=\frac{2}{N(N-1)}\sum_{i=1}^{N-1}\sum_{j=i+1}^{N}r_{ij}\]여기서 서로 다른 주식 쌍의 수는 다음과 같다.
\[\frac{N(N-1)}{2}\]Constant-correlation shrinkage target $F$의 대각원소에는 각 주식의 표본분산을 그대로 사용한다.
\[f_{ii}=s_{ii}\]비대각원소에는 평균 표본상관계수와 두 주식의 표본표준편차를 이용한다.
\[f_{ij}=\bar{r}\sqrt{s_{ii}s_{jj}}\quad\text{for }i\neq j\]따라서 shrinkage target $F$는 다음과 같은 구조를 가진다.
\[F=\begin{pmatrix}s_{11}&\bar{r}\sqrt{s_{11}s_{22}}&\cdots&\bar{r}\sqrt{s_{11}s_{NN}}\\\bar{r}\sqrt{s_{22}s_{11}}&s_{22}&\cdots&\bar{r}\sqrt{s_{22}s_{NN}}\\\vdots&\vdots&\ddots&\vdots\\\bar{r}\sqrt{s_{NN}s_{11}}&\bar{r}\sqrt{s_{NN}s_{22}}&\cdots&s_{NN}\end{pmatrix}\]이 target은 개별 주식의 분산 차이는 그대로 유지한다.
변동성이 높은 주식과 낮은 주식의 차이를 제거하지 않는다는 뜻이다.
반면 주식 쌍마다 다르게 추정된 표본상관계수는 공통 평균상관계수 $\bar{r}$로 대체한다.
따라서 constant-correlation target은 다음 두 정보를 사용한다.
| 정보 | target에서의 처리 |
|---|---|
| 개별 주식의 분산 | 표본분산을 그대로 사용 |
| 주식 사이의 상관계수 | 모든 주식 쌍에 평균 상관계수를 사용 |
Target 방향으로의 이동
표본 공분산행렬 $S$의 대각원소와 constant-correlation target $F$의 대각원소는 같다.
\[f_{ii}=s_{ii}\]따라서 이 모형에서 shrinkage는 주로 비대각 공분산 원소를 조정한다.
각 비대각원소의 shrinkage 추정값은 다음과 같다.
\[\hat{\sigma}_{ij}^{\mathrm{Shrink}}=\delta\bar{r}\sqrt{s_{ii}s_{jj}}+(1-\delta)s_{ij}\]표본상관계수 형태로 나타내면 다음과 같다.
\[\hat{\rho}_{ij}^{\mathrm{Shrink}}=\delta\bar{r}+(1-\delta)r_{ij}\]따라서 개별 주식 쌍의 표본상관계수는 전체 평균상관계수 방향으로 이동한다.
\[r_{ij}\longrightarrow\delta\bar{r}+(1-\delta)r_{ij}\]모든 상관계수를 평균값으로 완전히 대체하는 것은 아니다.
$\delta$가 1보다 작으면 개별 주식 쌍의 표본정보도 일정 부분 유지된다.
이 target은 동일한 자산군에 속한 다수의 주식을 분석할 때 적합하다.
다만 주식과 채권처럼 서로 다른 자산군을 하나의 공분산행렬에서 다루는 경우에는 모든 자산 쌍의 상관계수가 같다는 가정이 적절하지 않을 수 있다.
이 경우에는 자산군의 특성을 반영하는 다른 shrinkage target을 사용해야 한다는 점을 명시하자.
3.3 Shrinkage Constant
Shrinkage target $F$가 정해졌더라도 표본 공분산행렬을 target 방향으로 얼마나 이동시킬 것인지 결정해야 한다.
Shrinkage 추정량은 다음과 같다.
\[\hat{\Sigma}(\delta)=\delta F+(1-\delta)S\]$0$과 $1$ 사이의 어떤 $\delta$를 사용하더라도 표본 공분산행렬과 target 사이의 절충된 추정량을 얻을 수 있는데, 가능한 $\delta$의 값은 무한히 많다.
\[\delta\in[0,1]\]따라서 임의의 값을 선택하기보다는 공분산행렬의 추정오차를 가장 작게 만드는 최적의 shrinkage constant를 구해야 한다.
최적 shrinkage constant를 $\delta^{\ast}$라고 하자.
$\delta^{\ast}$는 shrinkage 추정량과 실제 공분산행렬 $\Sigma$ 사이의 기대거리를 최소화하는 값이다.
\[\delta^{\ast}=\underset{0\leq\delta\leq1}{\mathrm{arg\,min}}\,E\left[\left\|\delta F+(1-\delta)S-\Sigma\right\|_F^2\right]\]여기서 $|\cdot|_F$는 Frobenius norm이다.
$N\times N$ 행렬 $Z$의 Frobenius norm 제곱은 모든 원소의 제곱을 더한 값이다.
\[\|Z\|_F^2=\sum_{i=1}^{N}\sum_{j=1}^{N}z_{ij}^2\]따라서 최적 shrinkage constant는 추정된 공분산행렬의 모든 원소가 실제 공분산행렬의 원소와 얼마나 다른지를 종합적으로 측정하여 그 기대값을 최소화한다.
실제 공분산행렬 $\Sigma$는 관측할 수 없으므로 $\delta^{\ast}$ 자체도 직접 계산할 수 없다.
저자들은 표본자료를 이용하여 최적값을 추정하는 공식 $\hat{\delta}^{\ast}$를 제시한다.
\[\hat{\delta}^{\ast}=\max\left(0,\min\left(\frac{\hat{\kappa}}{T},1\right)\right)\]여기서 $T$는 수익률 관측치의 수이고, $\hat{\kappa}$는 표본자료로 계산한 통계량이다.
최솟값과 최댓값을 이용하는 이유는 표본오차로 인해 계산된 값이 0보다 작거나 1보다 커지는 경우를 방지하기 위해서이다.
\[\frac{\hat{\kappa}}{T}<0\Rightarrow\hat{\delta}^{\ast}=0\] \[0\leq\frac{\hat{\kappa}}{T}\leq1\Rightarrow\hat{\delta}^{\ast}=\frac{\hat{\kappa}}{T}\] \[\frac{\hat{\kappa}}{T}>1\Rightarrow\hat{\delta}^{\ast}=1\]Shrinkage constant의 직관
표본 공분산행렬의 추정오차가 크다면 구조화된 target에 더 큰 비중을 부여해야 한다.
\[\text{표본 추정오차 증가}\Rightarrow\hat{\delta}^{\ast}\text{ 증가}\]반대로 표본 공분산행렬이 충분히 정확하다면 표본자료에 더 큰 비중을 부여해야 한다.
\[\text{표본 추정오차 감소}\Rightarrow\hat{\delta}^{\ast}\text{ 감소}\]일반적으로 관측치 $T$가 적고 종목 수 $N$이 많을수록 표본 공분산행렬의 추정오차가 커지므로 shrinkage의 필요성도 커진다.
\[\frac{N}{T}\text{ 증가}\Rightarrow\text{표본 공분산 추정의 불안정성 증가}\]다만 최적 shrinkage intensity는 단순히 $N/T$만으로 정해지는 것은 아니다.
표본 공분산행렬의 추정분산, shrinkage target과 표본 공분산행렬 사이의 관계, target의 모형설정 오류를 함께 고려하여 결정된다.
최종 shrinkage 추정량
표본자료로 추정한 최적 shrinkage constant $\hat{\delta}^{\ast}$를 이용하면 실제 포트폴리오 최적화에 사용할 공분산 추정량은 다음과 같다.
\[\widehat{\Sigma}_{\mathrm{Shrink}} = \widehat{\delta}^{\ast}F + \left(1-\widehat{\delta}^{\ast}\right)S \qquad (2)\]이 식은 표본 공분산행렬과 constant-correlation target을 최적 비율로 결합한다.
각 원소는 다음과 같이 계산된다.
\[\hat{\sigma}_{ij}^{\mathrm{Shrink}}=\hat{\delta}^{\ast}f_{ij}+(1-\hat{\delta}^{\ast})s_{ij}\]대각원소에서는 $f_{ii}=s_{ii}$이므로 다음이 성립한다.
\[\hat{\sigma}_{ii}^{\mathrm{Shrink}}=\hat{\delta}^{\ast}s_{ii}+(1-\hat{\delta}^{\ast})s_{ii}=s_{ii}\]따라서 이 논문의 constant-correlation shrinkage에서는 개별 주식의 표본분산이 그대로 유지된다.
비대각원소는 다음과 같다.
\[\hat{\sigma}_{ij}^{\mathrm{Shrink}}=\hat{\delta}^{\ast}\bar{r}\sqrt{s_{ii}s_{jj}}+(1-\hat{\delta}^{\ast})s_{ij}\]즉 주식 사이의 표본 공분산을 평균 상관관계가 내재된 공분산 방향으로 조정한다.
Shrinkage intensity가 클수록 constant-correlation target의 영향이 커진다.
\[\hat{\delta}^{\ast}\uparrow\Rightarrow\hat{\Sigma}_{\mathrm{Shrink}}\text{가 }F\text{에 가까워짐}\]Shrinkage intensity가 작을수록 표본 공분산행렬의 영향이 커진다.
\[\hat{\delta}^{\ast}\downarrow\Rightarrow\hat{\Sigma}_{\mathrm{Shrink}}\text{가 }S\text{에 가까워짐}\]3.4 Shrinkage 추정량의 의미
Shrinkage는 표본 공분산행렬과 constant-correlation model이 각각 불완전하다는 점을 인정하고, 서로 다른 장점을 결합하여 전체 추정오차를 줄이는 방법이다.
표본 공분산행렬은 실제 자료의 세부적인 공분산구조를 반영한다.
그러나 자료가 부족하면 이러한 세부적인 차이 가운데 상당 부분이 실제 정보가 아니라 표본오차일 수 있다.
Constant-correlation target은 개별 주식 쌍의 세부적인 차이를 제거하여 안정성을 높인다.
그러나 모든 상관계수가 같다는 가정은 실제 시장을 지나치게 단순화한다.
Shrinkage 추정량은 표본의 세부정보를 일부 유지하면서, 신뢰하기 어려운 극단적인 추정값을 안정적인 중심값 방향으로 조정한다.
\[\text{Shrinkage}=\text{표본정보의 유연성}+\text{구조화 모형의 안정성}\]이렇게 얻은 $\hat{\Sigma}_{\mathrm{Shrink}}$는 제2장에서 정의한 포트폴리오 최적화 문제의 $\Sigma$를 대신하여 사용된다.
\[\min_x x^\top\hat{\Sigma}_{\mathrm{Shrink}}x\]제약조건은 기존과 동일하기에 포트폴리오 최적화의 목적함수, 기대초과수익률 추정치, 벤치마크 비중 및 제약조건은 변경하지 않는다.
기존에 사용하던 표본 공분산행렬 $S$만 shrinkage 공분산행렬 $\hat{\Sigma}_{\mathrm{Shrink}}$로 교체한다.
\[S\longrightarrow\hat{\Sigma}_{\mathrm{Shrink}}\]이러한 단순한 교체를 통해 표본 공분산행렬의 추정오차에 최적화기가 과도하게 반응하는 현상을 완화하고, 보다 안정적인 액티브 포트폴리오 비중을 구하는 것이 이 논문의 핵심이다.
4. Empirical Study
이 장에서는 과거 미국 주식시장 자료를 이용하여 constant-correlation shrinkage 추정량의 표본 외 성과를 평가한다.
여기서 중요한 것은 실제 포트폴리오를 구성한 이후 미래에 실현되는 초과수익률과 추적오차를 얼마나 잘 통제하는지가 핵심이다.
따라서 저자들은 각 시점에서 과거 자료만 이용하여 공분산행렬과 포트폴리오 비중을 계산한 뒤, 다음 달에 실제로 실현된 수익률을 이용하여 성과를 평가한다.
4.1 자료와 벤치마크 구성
실증분석에는 DataStream에서 제공하는 미국 주식의 월별 자료로 평가기간은 1983년 2월부터 2002년 12월까지이며, 총 239개의 월별 수익률을 사용한다.
각 월초에는 시가총액을 기준으로 가장 큰 $N$개의 주식을 선택한다. 선택된 종목들의 시가총액 비중을 이용하여 가치가중 벤치마크를 구성한다.
개별 종목 $i$의 벤치마크 비중은 다음과 같이 생각할 수 있다.
\[w_{B,i}= \frac{\text{종목 }i\text{의 시가총액}} {\sum_{j=1}^{N}\text{종목 }j\text{의 시가총액}}\]월말에는 각 종목의 실제 수익률을 관측하고, 월초에 결정한 비중을 이용하여 벤치마크 수익률을 계산한다.
\[r_{B,t}=w_{B,t}^{\top}y_t\]여기서 $w_{B,t}$는 $t$월 초의 벤치마크 비중벡터이고, $y_t$는 해당 월에 실현된 개별 주식수익률 벡터이다.
이 과정을 2002년 12월까지 매월 반복한다.
따라서 벤치마크를 구성하는 종목과 각 종목의 비중은 고정되어 있지 않다. 시가총액 순위와 시장가치가 변함에 따라 매월 갱신된다.
실증분석에서는 다음과 같은 다섯 가지 벤치마크 규모를 사용한다.
\[N\in\{30,50,100,225,500\}\]이 범위는 DJIA, Xetra DAX, DJ STOXX 50, FTSE 100, NASDAQ-100, NIKKEI 225, S&P 500과 같이 실제로 널리 사용되는 주요 주가지수의 종목 수를 포괄한다.
Table 1. 벤치마크 수익률의 요약통계량
| 구분 | $N=30$ | $N=50$ | $N=100$ | $N=225$ | $N=500$ |
|---|---|---|---|---|---|
| 평균 | 13.63 | 13.50 | 13.29 | 13.45 | 13.42 |
| 표준편차 | 15.12 | 15.02 | 14.76 | 14.56 | 14.52 |
표의 평균과 표준편차는 연율화된 값이며, 단위는 퍼센트이다.
Table 1을 보면 벤치마크의 평균수익률은 종목 수와 관계없이 약 13% 수준으로 유사하다. 반면 표준편차는 $N$이 증가할수록 15.12에서 14.52로 소폭 감소한다.
벤치마크 규모를 여러 수준으로 설정하는 이유는 공분산행렬의 차원이 커질 때 각 위험모형의 성과가 어떻게 달라지는지를 확인하기 위해서이다.
종목 수 $N$이 커질수록 공분산행렬에 포함되는 분산과 공분산의 수는 빠르게 증가한다.
공분산행렬에는 각 종목의 분산 $N$개와 서로 다른 종목 쌍의 공분산 $\binom{N}{2}$개가 포함된다. 따라서 서로 다르게 추정해야 하는 원소의 수는 다음과 같다.
\[N+\binom{N}{2}= \frac{N(N+1)}{2}\]예를 들어 $N=30$이면 추정해야 하는 원소는 465개이다.
\[\frac{30\times31}{2}=465\]반면 $N=500$이면 추정해야 하는 원소는 125,250개로 증가한다.
\[\frac{500\times501}{2}=125{,}250\]그러나 공분산행렬 추정에 사용하는 과거 관측치는 60개월로 고정되어 있다.
따라서 $N$이 증가할수록 제한된 관측치로 더 많은 분산과 공분산을 추정해야 하므로 표본 공분산행렬의 추정문제가 더욱 어려워진다.
4.2 액티브 매니저의 전망 구성
위험모형의 성능을 평가하려면 개별 주식의 기대초과수익률에 관한 전망이 필요하다.
저자들은 일정한 예측능력을 가진 가상의 액티브 매니저를 모방하기 위해 기대초과수익률 전망을 인위적으로 생성한다.
먼저 실제로 실현된 초과수익률에 무작위 잡음을 추가하여 원시 전망을 만든다.
그다음 원시 전망을 변환하여 MVO에 입력할 최종 기대초과수익률 전망벡터 $\hat{\alpha}$를 구성한다.
이 과정은 전망의 품질이 벤치마크 종목 수에 따라 달라지는 문제를 방지하도록 설계된다.
제약조건이 없고 실제 공분산행렬 $\Sigma$를 정확히 알고 있는 이상적인 투자자가 달성할 수 있는 사전적 연율화 정보비율은 벤치마크 규모와 관계없이 약 1.5가 되도록 조정한다.
\[\mathrm{IR}_{\mathrm{ex\,ante}}\approx1.5\]여기서 제약조건이 없는 투자자는 액티브 비중 $x$의 하한과 상한에 구속되지 않는 투자자를 의미한다.
또한 실제 공분산행렬을 알고 있다는 조건은 현실적인 가정이 아니다. 이는 각 위험모형을 동일한 예측능력 아래에서 비교하기 위한 실험적 기준이다.
원시 전망을 만들 때 미래의 실현수익률을 이용하는 것은 실제 투자전략을 제시하기 위한 것이 아니다. 일정한 수준의 종목선택 능력을 가진 가상의 매니저를 반복적으로 생성하고, 동일한 전망 아래에서 공분산 추정방법만 바꾸어 성과를 비교하기 위한 실험설계이다.
구체적인 전망 생성방법은 논문의 Appendix C에 제시된다.
4.3 표본 외 평가 절차
위험모형은 실제 투자시점 이후에 실현되는 성과를 기준으로 평가한다.
각 월의 평가절차는 다음과 같다.
1단계: 월초의 입력값 준비
각 월초에는 다음 입력값을 이차계획 최적화기에 제공한다.
- 벤치마크 비중벡터 $w_B$
- 기대초과수익률 전망벡터 $\hat{\alpha}$
- 추정된 공분산행렬 $\hat{\Sigma}$
- 목표 기대초과수익률 $g$
- 개별 종목의 최대 허용 비중 $c$
개별 주식의 최대 포트폴리오 비중은 10%로 설정한다.
\[c=0.1\]벤치마크 대비 목표 기대초과수익률은 연 300bp로 설정한다.
\[g=300\text{ bp}=3\%\]2단계: 공분산행렬 추정
각 월초의 공분산행렬은 현재 벤치마크에 포함된 종목들의 과거 60개월 수익률을 이용하여 추정한다.
\[T=60\]즉 $t$월의 포트폴리오를 구성할 때에는 $t$월의 수익률을 사용하지 않고, 그 이전 60개월의 자료만 사용한다.
이러한 방식은 실제 투자자가 당시 이용할 수 있었던 정보만 사용한다는 표본 외 평가의 원칙을 따른다.
3단계: 최적 액티브 비중 계산
최적화기는 다음 문제를 풀어 액티브 비중벡터 $x_t$를 계산한다.
\[\min_{x_t}x_t^\top\hat{\Sigma}_t x_t\]다음 제약조건을 만족해야 한다.
\[x_t^\top\hat{\alpha}_t\geq g\] \[x_t^\top\mathbf{1}=0\] \[x_t\geq-w_{B,t}\] \[x_t\leq c\mathbf{1}-w_{B,t}\]목적함수는 추정된 추적오차 분산이다.
\[\widehat{\sigma}_{E,t}^2=x_t^\top\hat{\Sigma}_t x_t\]최적화기는 목표 기대초과수익률을 달성하는 포트폴리오 가운데 추정 추적오차가 가장 작은 포트폴리오를 선택한다.
최종 포트폴리오 비중은 다음과 같다.
\[w_{P,t}=w_{B,t}+x_t\]4단계: 월말의 실현 초과수익률 계산
월말에는 실제 주식수익률 벡터 $y_t$를 관측한다.
액티브 포트폴리오의 실현 초과수익률은 다음과 같다.
\[e_t=x_t^\top y_t\]이 값은 실제 포트폴리오 수익률과 벤치마크 수익률의 차이와 같다.
\[e_t=r_{P,t}-r_{B,t}\]5단계: 전체 표본 외 수익률 수집
표본 외 기간은 1983년 2월부터 2002년 12월까지이다.
따라서 각 실험에서 총 239개의 월별 실현 초과수익률을 얻는다.
\[t=1,2,\ldots,239\]6단계: 사후적 정보비율 계산
239개의 월별 실현 초과수익률로부터 표본평균을 계산한다.
\[\bar{e}=\frac{1}{239}\sum_{t=1}^{239}e_t\]표본표준편차는 다음과 같다.
\[s_e=\sqrt{\frac{1}{238}\sum_{t=1}^{239}(e_t-\bar{e})^2}\]월별 자료를 이용한 사후적 정보비율을 연율화하면 다음과 같다.
\[\widehat{\mathrm{IR}}_{\mathrm{ex\,post}}=\sqrt{12}\frac{\bar{e}}{s_e}\]분자의 $\bar{e}$는 평균적으로 얼마나 높은 초과수익률을 실현했는지를 나타낸다.
분모의 $s_e$는 초과수익률이 얼마나 불안정하게 변했는지를 나타내며, 실현 추적오차에 해당한다.
따라서 정보비율이 높다는 것은 동일한 추적오차를 감수하면서 더 높은 초과수익률을 얻었거나, 동일한 초과수익률을 더 낮은 추적오차로 달성했다는 의미이다.
7단계: 실험 반복
기대초과수익률 전망 $\hat{\alpha}$에는 무작위 잡음이 포함되어 있으므로 한 번의 실험 결과만으로 위험모형을 평가하면 우연의 영향을 크게 받을 수 있다.
따라서 전체 표본 외 평가를 50회 반복한다.
\[R=50\]각 반복에서 새로운 무작위 전망을 생성하고, 239개월 동안 포트폴리오를 다시 구성한다.
마지막에는 50회 반복에서 얻은 성과지표의 평균 요약통계량을 보고한다.
이러한 반복실험은 평균적으로 안정적인 성과를 제공하는 위험모형을 찾기 위한 것이다.
4.4 비교하는 공분산 추정방법
실증분석에서는 총 네 가지 공분산 추정방법을 비교한다.
| 표시 | 공분산 추정방법 |
|---|---|
| Sample | 표본 공분산행렬 |
| Shrink-CC | Constant-correlation target을 이용한 shrinkage 추정량 |
| Shrink-SF | 단일요인모형 target을 이용한 shrinkage 추정량 |
| PC-5 | 첫 5개의 주성분을 이용한 통계적 다요인모형 |
Sample
표본 공분산행렬은 계산이 간단하고 가장 널리 알려진 추정량이다.
Jagannathan and Ma(2003)는 공매도 금지 제약조건이 표본 공분산행렬에 암묵적인 shrinkage를 적용하는 것과 유사한 효과를 가질 수 있음을 보였다.
제약조건이 존재하는 이 실험에서도 표본 공분산행렬이 어느 정도 합리적인 결과를 낼 가능성이 있으나, 표본 공분산행렬 자체의 추정오차가 사라지는 것은 아니다.
Shrink-CC
Shrink-CC는 이 논문에서 제안한 방법이다.
표본 공분산행렬을 모든 종목 쌍의 상관계수가 동일하다고 가정하는 constant-correlation target 방향으로 축소한다.
\[\widehat{\Sigma}_{\mathrm{Shrink\text{-}CC}} = \widehat{\delta}_{\mathrm{CC}}^{\ast}F_{\mathrm{CC}} + \left(1-\widehat{\delta}_{\mathrm{CC}}^{\ast}\right)S\]Shrink-SF
Shrink-SF는 Ledoit and Wolf(2003)가 제시한 방법이다.
Shrinkage의 기본 원리는 Shrink-CC와 같지만, shrinkage target으로 Sharpe(1963)의 단일요인모형 공분산행렬을 사용한다.
\[\widehat{\Sigma}_{\mathrm{Shrink\text{-}SF}} = \widehat{\delta}_{\mathrm{SF}}^{\ast}F_{\mathrm{SF}} + \left(1-\widehat{\delta}_{\mathrm{SF}}^{\ast}\right)S\]따라서 Shrink-CC와 Shrink-SF의 차이는 target의 구조에 있다.
PC-5
다요인모형은 실무에서 공분산행렬을 추정하는 표준적인 방법이다.
산업요인, 거시경제요인 또는 기업 특성요인을 사용할 수도 있지만, 이러한 요인들은 주식수익률 이외의 추가 자료를 요구한다.
이 논문에서는 과거 주식수익률만으로 계산할 수 있는 통계적 요인을 사용한다.
구체적으로 수익률 자료의 첫 5개 주성분을 공통요인으로 사용하는 공분산 추정량을 구성한다.
\[K_{\mathrm{PC}}=5\]이 방법을 PC-5라고 부른다.
4.5 실현 초과수익률과 정보비율
Table 2에는 50회 반복실험에서 얻은 실현 초과수익률의 평균 요약통계량이 제시된다.
모든 위험모형에 대해 사전적으로 설정한 목표 기대초과수익률은 연 300bp, 즉 3%로 동일하다. 표본 외 평가기간은 1983년 2월부터 2002년 12월까지이며, 총 239개의 월별 초과수익률을 사용한다.
표의 IR, Mean, SD는 각각 실현 정보비율, 평균 실현 초과수익률, 실현 초과수익률의 표준편차를 나타낸다. 모든 값은 연율화되어 있다.
Table 2. 실현 초과수익률의 평균 요약통계량
| 벤치마크 규모 | 공분산 추정량 | IR | Mean | SD |
|---|---|---|---|---|
| $N=30$ | Sample | 0.97 | 2.18 | 2.26 |
| $N=30$ | Shrink-CC | 1.24 | 2.50 | 2.03 |
| $N=30$ | Shrink-SF | 1.18 | 2.39 | 2.04 |
| $N=30$ | PC-5 | 1.17 | 2.45 | 2.10 |
| $N=50$ | Sample | 0.79 | 1.92 | 2.44 |
| $N=50$ | Shrink-CC | 1.14 | 2.21 | 1.95 |
| $N=50$ | Shrink-SF | 1.08 | 2.13 | 1.98 |
| $N=50$ | PC-5 | 1.11 | 2.18 | 1.96 |
| $N=100$ | Sample | 0.59 | 1.71 | 2.93 |
| $N=100$ | Shrink-CC | 0.91 | 1.87 | 2.06 |
| $N=100$ | Shrink-SF | 0.89 | 1.86 | 2.10 |
| $N=100$ | PC-5 | 0.91 | 1.87 | 2.07 |
| $N=225$ | Sample | 0.37 | 2.37 | 6.45 |
| $N=225$ | Shrink-CC | 0.54 | 2.53 | 4.97 |
| $N=225$ | Shrink-SF | 0.57 | 2.37 | 4.30 |
| $N=225$ | PC-5 | 0.55 | 2.42 | 4.46 |
| $N=500$ | Sample | 0.20 | 1.92 | 8.53 |
| $N=500$ | Shrink-CC | 0.30 | 1.82 | 5.77 |
| $N=500$ | Shrink-SF | 0.33 | 1.74 | 5.13 |
| $N=500$ | PC-5 | 0.31 | 1.59 | 5.05 |
여기서 각 공분산 추정량의 의미는 다음과 같다.
| 추정량 | 의미 |
|---|---|
| Sample | 표본 공분산행렬 |
| Shrink-CC | 표본 공분산행렬과 constant-correlation target을 결합한 shrinkage 추정량 |
| Shrink-SF | Ledoit and Wolf(2003)의 shrinkage 추정량 |
| PC-5 | 처음 다섯 개의 주성분을 이용한 공분산 추정량 |
정보비율
정보비율은 평균 실현 초과수익률을 초과수익률의 표준편차로 나눈 값이다.
\[\mathrm{IR}=\frac{\mathrm{Mean}}{\mathrm{SD}}\]모든 벤치마크 규모에서 Shrink-CC는 Sample보다 높은 평균 실현 정보비율을 기록한다.
예를 들어 $N=30$에서는 정보비율이 0.97에서 1.24로 증가하고, $N=500$에서는 0.20에서 0.30으로 증가한다.
이는 shrinkage가 표본 공분산행렬의 추정오차를 줄여 액티브 매니저의 전망을 더욱 효율적으로 포트폴리오에 반영한다는 것을 보여준다.
평균 초과수익률
대부분의 벤치마크 규모에서 Shrink-CC는 Sample보다 높은 평균 실현 초과수익률을 기록한다.
목표 기대초과수익률은 모든 위험모형에서 동일하게 연 3%로 설정되어 있다. 따라서 실현 초과수익률의 차이는 서로 다른 공분산 추정량이 동일한 기대수익률 전망을 서로 다른 포트폴리오 비중으로 변환하기 때문에 발생한다.
다만 $N=500$에서는 Sample의 평균 초과수익률이 1.92이고 Shrink-CC는 1.82로, Shrink-CC가 더 낮다. 따라서 shrinkage의 장점은 평균수익률을 항상 높이는 데 있다기보다 실현 위험을 더 안정적으로 통제하는 데 있다고 볼 수 있다.
초과수익률의 표준편차
모든 벤치마크 규모에서 Shrink-CC는 Sample보다 낮은 초과수익률의 표준편차를 기록한다.
예를 들어 $N=30$에서는 표준편차가 2.26에서 2.03으로 감소하고, $N=500$에서는 8.53에서 5.77로 크게 감소한다.
초과수익률의 표준편차는 실제 포트폴리오 수익률과 벤치마크 수익률 차이의 변동성이므로 실현 추적오차에 해당한다.
따라서 Shrink-CC의 높은 정보비율은 평균 초과수익률의 증가뿐 아니라 실현 추적오차를 더 안정적으로 통제한 결과이기도 하다.
벤치마크 규모의 영향
평균 실현 정보비율은 벤치마크의 종목 수 $N$이 증가할수록 전반적으로 감소한다.
\[N\uparrow\quad\Rightarrow\quad\overline{\mathrm{IR}}_{\mathrm{ex\ post}}\downarrow\]종목 수가 증가하면 공분산행렬의 차원은 커지지만 추정에 사용하는 과거 관측치는 60개월로 유지된다.
따라서 제한된 자료로 더 많은 분산과 공분산을 추정해야 하므로 공분산행렬의 추정이 어려워지고, 최적화 결과도 추정오차에 더 민감해질 수 있다.
특히 Sample의 표준편차는 $N=30$에서 2.26이지만 $N=500$에서는 8.53까지 증가한다. 반면 shrinkage 추정량들은 같은 조건에서도 표준편차의 증가를 상대적으로 억제한다.
또한 long-only 조건에서는 벤치마크 비중이 매우 작은 종목의 비중을 큰 폭으로 축소하기 어렵다는 제약도 강해질 수 있다.
다만 논문의 실증결과는 벤치마크 규모가 커질수록 정보비율이 감소한다는 현상을 보여주는 것이며, 그 감소 원인을 하나의 요인으로 완전히 분해한 것은 아니다.
4.6 Figure 1의 정보비율 분포
Figure 1은 목표 기대초과수익률을 300bp로 설정했을 때, 다섯 가지 벤치마크 규모에 대해 Sample과 Shrink-CC가 기록한 실현 정보비율의 분포를 상자그림으로 나타낸 것이다.
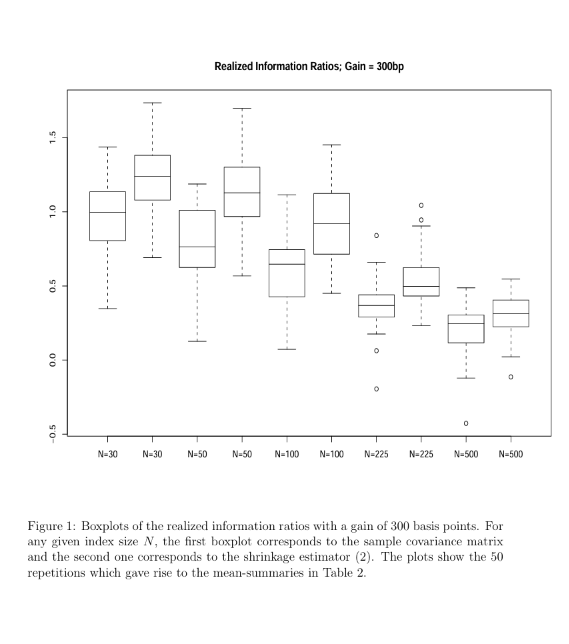 Figure 1. 목표 기대초과수익률이 300bp일 때의 실현 정보비율 분포. 각 벤치마크 규모에서 첫 번째 상자는 Sample, 두 번째 상자는 Shrink-CC를 나타낸다.
각 벤치마크 규모 $N$에 대해 두 개의 상자그림이 제시된다. 첫 번째는 표본 공분산행렬인 Sample이고, 두 번째는 constant-correlation shrinkage 추정량인 Shrink-CC이다. 각 상자그림은 50회 반복실험에서 얻은 실현 정보비율의 분포를 요약한다.
Figure 1에서 Shrink-CC의 상자그림은 대부분 Sample보다 높은 위치에 있다. 중앙값과 사분위 범위를 기준으로 보더라도 Shrink-CC가 전반적으로 더 높은 정보비율을 기록한다. 이는 Table 2에서 확인한 평균 정보비율 비교와 일치한다.
또한 벤치마크 종목 수 $N$이 증가할수록 두 방법의 정보비율이 모두 낮아지는 경향이 나타난다. 특히 $N=225$와 $N=500$에서는 $N=30$과 $N=50$보다 상자그림 전체가 아래쪽으로 이동한다.
이는 종목 수가 증가하면서 공분산행렬의 차원이 커지는 반면, 공분산 추정에 사용하는 관측기간은 60개월로 유지되기 때문이다. 따라서 벤치마크 규모가 커질수록 공분산 추정이 어려워지고 최적화 결과가 추정오차에 더 민감해질 수 있다.
상자그림의 높이와 수염은 같은 공분산 추정방법과 같은 벤치마크 규모를 사용하더라도 실현 정보비율에 변동이 존재한다는 사실을 보여준다. 일부 실험에서는 분포에서 크게 벗어난 이상치도 나타난다.
이러한 변동은 각 반복실험에서 생성되는 기대초과수익률 전망에 무작위 잡음이 포함되기 때문이다. 따라서 액티브 운용의 실현성과는 종목선택 능력과 위험모형의 품질뿐 아니라 무작위적인 요인의 영향도 받는다.
4.7 다른 위험모형과의 비교
다음으로 Shrink-CC를 Shrink-SF 및 PC-5와 비교한다.
Shrink-CC와 Shrink-SF
종목 수가 100개 이하인 경우 Shrink-CC가 Shrink-SF보다 다소 좋은 성과를 보인다.
\[N\leq100\Rightarrow\mathrm{Shrink\text{-}CC}\text{가 다소 우수}\]반면 종목 수가 225개 이상인 경우에는 Shrink-SF가 Shrink-CC보다 다소 좋은 성과를 보인다.
\[N\geq225\Rightarrow\mathrm{Shrink\text{-}SF}\text{가 다소 우수}\]따라서 constant-correlation target이 모든 벤치마크 규모에서 단일요인 target을 지배하는 것은 아니다.
두 shrinkage 방법 모두 표본 공분산행렬의 추정오차를 줄이는 효과를 가지지만, 벤치마크 규모에 따라 target의 상대적 적합성이 달라질 수 있다.
Shrink-CC와 PC-5
종목 수가 50개 이하인 경우 Shrink-CC가 PC-5보다 다소 좋은 성과를 보인다.
\[N\leq50\Rightarrow\mathrm{Shrink\text{-}CC}\text{가 다소 우수}\]종목 수가 100개 이상인 경우 Shrink-CC와 PC-5의 성과는 대체로 비슷하다.
\[N\geq100\Rightarrow\mathrm{Shrink\text{-}CC}\approx\mathrm{PC\text{-}5}\]이 결과는 구현이 비교적 간단한 constant-correlation shrinkage 추정량이 실무의 대표적인 다요인 위험모형과 경쟁할 수 있음을 보여준다.
4.8 포트폴리오 회전율
Table 3에는 각 공분산 추정량으로 구성한 포트폴리오의 월평균 회전율이 제시된다. 각 수치는 50회 반복실험에서 얻은 회전율의 평균이다.
회전율은 기존 포트폴리오를 새로운 목표비중으로 조정하기 위해 거래해야 하는 비중의 크기를 나타낸다. 회전율이 높을수록 포트폴리오 비중이 자주 또는 큰 폭으로 변경된다는 의미이다.
본 실험의 회전율에는 다음과 같은 변화가 함께 반영된다.
- 액티브 전망과 공분산 추정량의 변화로 최적 비중이 달라지는 경우
- 벤치마크의 구성종목과 시가총액 비중이 매월 달라지는 경우
Table 3. 월평균 포트폴리오 회전율
| 공분산 추정량 | $N=30$ | $N=50$ | $N=100$ | $N=225$ | $N=500$ |
|---|---|---|---|---|---|
| Sample | 0.39 | 0.50 | 0.66 | 0.80 | 0.85 |
| Shrink-CC | 0.33 | 0.39 | 0.50 | 0.65 | 0.75 |
| Shrink-SF | 0.34 | 0.41 | 0.52 | 0.66 | 0.76 |
| PC-5 | 0.33 | 0.39 | 0.50 | 0.64 | 0.73 |
Table 3의 핵심 결과는 Sample이 모든 벤치마크 규모에서 가장 높은 회전율을 기록한다는 것이다.
예를 들어 $N=30$에서 Sample의 회전율은 0.39이지만 Shrink-CC는 0.33이다. $N=500$에서는 Sample의 회전율이 0.85까지 증가하는 반면, Shrink-CC는 0.75를 기록한다.
이는 표본 공분산행렬이 새로운 자료에 민감하게 반응하여 매월 추정된 공분산구조가 크게 달라지고, 그에 따라 최적 포트폴리오 비중도 불안정하게 변하기 때문이다.
반면 Shrink-CC, Shrink-SF, PC-5는 공분산 추정량에 일정한 구조를 부여한다. 따라서 새로운 자료가 추가되더라도 추정량과 최적 비중이 상대적으로 안정적으로 유지된다.
나머지 세 구조화된 추정량의 회전율은 서로 비슷하다. 특히 PC-5는 $N=225$와 $N=500$에서 각각 0.64와 0.73으로 가장 낮은 회전율을 기록한다.
또한 모든 방법에서 벤치마크 종목 수 $N$이 증가할수록 회전율이 높아진다. 종목 수가 많아질수록 최적화해야 하는 비중의 수가 증가하고, 벤치마크 구성과 공분산 추정치의 변화가 포트폴리오 전체에 더 큰 비중조정을 발생시킬 수 있기 때문이다.
실증분석에서 관측된 회전율은 실제 액티브 매니저가 선호하기에는 전반적으로 높은 수준이다. 그러나 이 결과만으로 해당 위험모형이 실무에 적합하지 않다고 결론 내릴 수는 없다.
본 실험의 최적화 문제에는 회전율을 제한하거나 거래비용을 반영하는 조건이 포함되어 있지 않기 때문이다. 필요한 경우 다음과 같은 회전율 제약조건을 추가할 수 있다.
\[\mathrm{Turnover}(w_{P,t},w_{P,t-1}) \leq \mathrm{TO}_{\max}\]또는 목적함수에 거래비용에 대한 페널티를 추가할 수 있다.
\[\min_{x_t} \left[ x_t^\top\widehat{\Sigma}_t x_t + \gamma\,\mathrm{TC}(w_{P,t},w_{P,t-1}) \right]\]여기서 $\gamma$는 추적오차와 거래비용 사이의 상대적 중요도를 조절하는 계수이다. $\gamma$가 클수록 거래비용과 회전율을 더욱 강하게 억제한다.
따라서 Table 3은 shrinkage와 요인모형이 실현 위험뿐 아니라 포트폴리오 비중의 불안정성도 완화할 수 있음을 보여준다.
4.9 추가 제약조건에 관한 논의
Remark 1. 현실적인 추가 제약조건
실제 액티브 매니저는 long-only 조건과 종목별 최대 비중 이외에도 여러 제약조건을 적용한다.
예를 들어 시가총액 중립조건, 회전율 제한, 섹터 중립조건 및 벤치마크 대비 배당수익률 중립조건이 존재할 수 있다.
제약조건이 추가될수록 포트폴리오가 매니저의 기대수익률 전망을 자유롭게 반영할 수 있는 범위는 줄어든다.
따라서 일반적으로 추가 제약조건은 실현 정보비율을 낮출 수 있다.
그러나 제약조건이 많아지더라도 우수한 위험모형의 필요성이 사라지는 것은 아니다.
포트폴리오 매니저는 제한된 투자 가능영역 안에서도 위험을 정확히 추정해야 하므로, 표본 공분산행렬보다 안정적인 공분산 추정량을 사용하는 것이 여전히 유리하다.
Remark 2. 추적오차 효율성과 평균–분산 효율성
추적오차를 기준으로 효율적인 포트폴리오가 반드시 절대적인 평균–분산 기준에서도 효율적인 것은 아니다.
추적오차 최적화는 벤치마크와 포트폴리오 수익률의 차이를 기준으로 위험을 측정한다.
\[\sigma_E^2=(w_P-w_B)^\top\Sigma(w_P-w_B)\]반면 일반적인 평균–분산 최적화는 포트폴리오 전체의 분산을 위험으로 측정한다.
\[\sigma_P^2=w_P^\top\Sigma w_P\]따라서 벤치마크와 비슷하게 움직이는 포트폴리오는 추적오차가 작을 수 있지만, 포트폴리오 자체의 절대위험이 작다는 보장은 없다.
이 때문에 추적오차 효율적 투자선은 일반적인 평균–분산 효율적 투자선보다 아래쪽과 오른쪽에 위치할 수 있다.
즉 같은 절대위험에서 기대수익률이 더 낮거나, 같은 기대수익률에서 절대위험이 더 높을 수 있다.
Jorion(2003)은 제2장의 최적화 문제에 포트폴리오 전체 분산에 대한 제약조건을 추가하면 평균–분산 효율성을 개선할 수 있음을 보였다.
예를 들어 다음 조건을 추가할 수 있다.
\[w_P^\top\Sigma w_P\leq\sigma_{\max}^2\]실무에서는 실제 공분산행렬 $\Sigma$를 알 수 없으므로 추정량 $\hat{\Sigma}$를 사용해야 한다.
\[w_P^\top\hat{\Sigma}w_P\leq\sigma_{\max}^2\]따라서 포트폴리오 전체 위험에 대한 제약조건을 추가하는 경우에도 정확하고 안정적인 공분산 추정량이 필요하다.
4.10 실증분석의 정리
실증분석의 결과는 다음과 같이 정리할 수 있다.
Constant-correlation shrinkage 추정량은 표본 공분산행렬보다 모든 벤치마크 규모에서 높은 평균 실현 정보비율을 기록하였다.
대부분의 경우 더 높은 평균 초과수익률을 기록했으며, 모든 경우에서 더 낮은 실현 추적오차를 기록하였다.
표본 공분산행렬은 네 가지 위험모형 가운데 가장 높은 포트폴리오 회전율을 발생시켰다.
Shrink-CC는 Shrink-SF 및 PC-5와 비교했을 때 벤치마크 규모에 따라 상대적 성과가 달라졌지만, 전반적으로 비슷하거나 경쟁력 있는 성과를 보였다.
따라서 구현이 간단한 constant-correlation shrinkage 추정량은 표본 공분산행렬보다 안정적이며, 복잡한 요인모형을 대체하거나 보완할 수 있는 실용적인 위험모형으로 볼 수 있다.
5. Conclusion
이 논문은 액티브 포트폴리오 관리의 평균–분산 최적화에서 전통적으로 사용되는 표본 공분산행렬을 대체할 수 있는 새로운 위험모형을 제안하였다.
표본 공분산행렬은 투자대상 종목의 수가 과거 수익률 관측치의 수와 비슷하거나 더 큰 경우에는 상당한 추정오차를 포함한다.
MVO는 추정오차로 인해 극단적으로 나타난 공분산계수를 이용하여 가장 큰 투자비중을 결정할 수 있고 그 결과 포트폴리오 비중이 불안정해지고, 실현 추적오차와 회전율이 증가하며, 액티브 매니저가 가진 종목선택 능력이 실제 운용성과에 충분히 반영되지 않을 수 있다.
이 논문은 이러한 문제를 해결하기 위해 표본 공분산행렬과 constant-correlation target을 결합한다.
\[\widehat{\Sigma}_{\mathrm{Shrink}} = \widehat{\delta}^{\ast}F + \left(1-\widehat{\delta}^{\ast}\right)S\]Shrinkage 추정량은 표본 공분산행렬 $S$는 실제 자료의 세부적인 공분산구조를 유연하게 반영하지만 추정오차가 크고 구조화된 target $F$는 모든 주식 쌍의 상관계수가 동일하다고 가정하여 추정오차를 줄이지만, 실제 공분산구조를 지나치게 단순화할 수 있다는 두 극단을 적절하게 결합하여 표본정보의 유연성과 구조화된 추정량의 안정성을 함께 이용한다.
최적 shrinkage intensity $\hat{\delta}^{\ast}$는 shrinkage 추정량과 실제 공분산행렬 사이의 기대거리를 최소화하도록 자료로부터 계산한다.
따라서 추정오차를 최소화하는 결합비율을 통계적으로 추정한다.
실증분석에서는 1983년 2월부터 2002년 12월까지의 미국 주식 월별 자료를 사용하여 shrinkage 추정량의 표본 외 성과를 평가하였다.
Constant-correlation shrinkage 추정량은 표본 공분산행렬보다 높은 실현 정보비율과 낮은 실현 추적오차를 기록하였다.
벤치마크 대비 연 300bp의 기대초과수익률을 목표로 설정했을 때, 실현 정보비율의 대표적인 개선폭은 약 50%에 이르렀다.
또한 표본 공분산행렬은 비교한 위험모형 중 가장 높은 포트폴리오 회전율을 발생시켰고 이는 shrinkage가 실제 포트폴리오 비중의 안정성을 높이는 데에도 도움이 된다는 것을 보여준다.
이 방법의 중요한 장점은 기존 포트폴리오 최적화 절차를 크게 변경할 필요가 없다는 것이다.
기대초과수익률 전망 $\hat{\alpha}$, 목표수익률 $g$, 벤치마크 비중 $w_B$ 및 포트폴리오 제약조건은 그대로 유지할 수 있다.
기존에 사용하던 표본 공분산행렬만 shrinkage 추정량으로 교체하면 된다.
\[S\longrightarrow\hat{\Sigma}_{\mathrm{Shrink}}\]따라서 기본적인 평균–분산 최적화뿐 아니라 재표본 효율적 투자선과 같은 고급 포트폴리오 최적화 방법에도 shrinkage 공분산행렬을 적용할 수 있다.
표본에서 극단적으로 추정된 공분산계수가 실제로도 극단적이라고 확신할 수 없다면, 해당 계수에 포트폴리오 전체의 성과를 좌우할 정도로 큰 비중을 걸어서는 안 된다.
결국 이 논문의 핵심 메시지를 정리하자면
핵심 정리
표본 공분산행렬은 추정오차가 지나치게 크기 때문에 MVO에 그대로 사용하기 어렵다.
표본 공분산행렬과 단순한 구조화된 target을 최적 비율로 결합하는 것만으로도 실현 추적오차를 줄이고, 정보비율과 포트폴리오의 안정성을 개선할 수 있다.
따라서 액티브 포트폴리오 최적화에서는 표본 공분산행렬을 그대로 사용하는 대신 shrinkage 공분산행렬을 사용하는 것이 더 합리적이다.
Appendix A. Shrinkage Target의 계산
Appendix A에서는 constant-correlation shrinkage target $F$를 실제로 어떻게 구성하는지 설명한다.
주식 $i$의 시점 $t$ 수익률을 $y_{it}$라고 하자.
\[1\leq i\leq N,\qquad 1\leq t\leq T\]여기서 $N$은 종목 수이고, $T$는 수익률 관측기간의 수이다.
주식 $i$의 표본평균 수익률은 다음과 같다.
\[\bar y_i=\frac{1}{T}\sum_{t=1}^{T}y_{it}\]모집단 공분산행렬을 $\Sigma$, 표본 공분산행렬을 $S$라고 하자.
| 기호 | 의미 |
|---|---|
| $\Sigma$ | 실제 공분산행렬 |
| $S$ | 자료로 계산한 표본 공분산행렬 |
| $\sigma_{ij}$ | $\Sigma$의 $(i,j)$번째 원소 |
| $s_{ij}$ | $S$의 $(i,j)$번째 원소 |
두 주식 $i$와 $j$ 사이의 모집단 상관계수와 표본상관계수는 각각 다음과 같다.
\[\rho_{ij}=\frac{\sigma_{ij}}{\sqrt{\sigma_{ii}\sigma_{jj}}}\] \[r_{ij}=\frac{s_{ij}}{\sqrt{s_{ii}s_{jj}}}\]여기서 $\sigma_{ii}$와 $s_{ii}$는 주식 $i$의 모집단분산과 표본분산이다.
constant-correlation 모형은 모든 주식 쌍이 서로 다른 상관계수를 갖는 대신, 하나의 공통 상관계수를 가진다고 가정한다.
먼저 모든 서로 다른 종목 쌍의 모집단 상관계수를 평균하면 다음과 같다.
\[\bar\rho=\frac{2}{N(N-1)}\sum_{i=1}^{N-1}\sum_{j=i+1}^{N}\rho_{ij}\]그러나 실제 모집단 상관계수는 알 수 없으므로 표본상관계수의 평균을 사용한다.
\[\bar r=\frac{2}{N(N-1)}\sum_{i=1}^{N-1}\sum_{j=i+1}^{N}r_{ij}\]$\bar r$은 모든 종목 쌍의 표본상관계수를 평균한 값이다.
모집단 constant-correlation 행렬
모집단 수준의 constant-correlation 행렬을 $\Phi$라고 하자.
대각원소는 실제 분산을 그대로 사용한다.
\[\phi_{ii}=\sigma_{ii}\]비대각원소는 모든 종목 쌍의 상관계수를 평균상관계수 $\bar\rho$로 통일한다.
\[\phi_{ij}=\bar\rho\sqrt{\sigma_{ii}\sigma_{jj}} \qquad(i\neq j)\]표본 shrinkage target
실제 계산에 사용하는 shrinkage target을 $F$라고 하자.
대각원소에는 각 주식의 표본분산을 그대로 사용한다.
\[f_{ii}=s_{ii}\]비대각원소에는 평균 표본상관계수 $\bar r$을 사용한다.
\[f_{ij}=\bar r\sqrt{s_{ii}s_{jj}} \qquad(i\neq j)\]따라서 target $F$는 각 주식의 서로 다른 변동성은 유지하면서, 모든 주식 쌍의 상관계수를 동일한 값 $\bar r$로 단순화한 공분산행렬이다.
표본 공분산행렬 $S$는 모든 공분산을 개별적으로 추정하지만, target $F$는 평균상관계수 하나와 $N$개의 표본분산만 이용한다. 따라서 $F$는 $S$보다 구조가 강하고 추정오차가 작다.
반면 실제 종목 사이의 상관관계가 모두 동일하지는 않으므로, $F$에는 모형설정 오류가 존재할 수 있다.
Appendix B. 최적 Shrinkage Intensity의 계산
Appendix B에서는 표본 공분산행렬 $S$와 구조화된 target $F$를 어떤 비율로 결합해야 하는지 설명한다.
Shrinkage 공분산행렬은 다음과 같다.
\[\widehat{\Sigma}_{\mathrm{Shrink}}(\delta)=\delta F+(1-\delta)S\]여기서 $\delta$는 shrinkage intensity이다.
| Shrinkage intensity | 의미 |
|---|---|
| $\delta=0$ | 표본 공분산행렬 $S$만 사용 |
| $\delta=1$ | 구조화된 target $F$만 사용 |
| $0<\delta<1$ | $S$와 $F$를 함께 사용 |
문제는 $\delta$를 임의로 선택하는 것이 아니라, 실제 공분산행렬 $\Sigma$를 가장 정확하게 추정하도록 선택해야 한다는 것이다.
Frobenius norm
두 행렬 사이의 거리를 측정하기 위해 Frobenius norm을 사용한다.
$N\times N$ 행렬 $Z$의 Frobenius norm의 제곱은 다음과 같다.
\[\lVert Z\rVert_F^2=\sum_{i=1}^{N}\sum_{j=1}^{N}z_{ij}^2\]즉 두 행렬의 대응하는 원소 사이의 차이를 각각 제곱하여 모두 더한 값이다.
Shrinkage 추정량과 실제 공분산행렬 사이의 손실함수는 다음과 같다.
\[L(\delta)=\left\lVert\delta F+(1-\delta)S-\Sigma\right\rVert_F^2\]하지만 $S$와 $F$는 표본자료에 따라 달라지는 확률적인 추정량이므로 손실의 기댓값을 최소화한다.
\[R(\delta)=E[L(\delta)]\]최적 shrinkage intensity는 다음 문제의 해이다.
\[\delta^{\ast}=\underset{0\leq\delta\leq1}{\mathrm{arg\,min}}\;E\left[\left\lVert\delta F+(1-\delta)S-\Sigma\right\rVert_F^2\right]\]최적 Shrinkage Intensity의 구조
관측기간 $T$가 충분히 클 때 최적 shrinkage intensity는 대략 다음과 같이 표현된다.
\[\delta^{\ast}\approx\frac{\kappa}{T}\]여기서 $\kappa$는 다음과 같다.
\[\kappa=\frac{\pi-\rho}{\gamma}\]각 기호의 의미는 다음과 같다.
| 기호 | 의미 |
|---|---|
| $\pi$ | 표본 공분산행렬 $S$에 포함된 전체 추정오차의 크기 |
| $\rho$ | target $F$와 표본 공분산행렬 $S$가 공유하는 추정오차 |
| $\gamma$ | target이 실제 공분산행렬과 다른 정도 |
| $T$ | 공분산행렬 추정에 사용한 관측치의 수 |
각 항은 이론적으로 다음과 같이 정의된다.
\[\pi=\sum_{i=1}^{N}\sum_{j=1}^{N}\mathrm{AsyVar}\left(\sqrt{T}s_{ij}\right)\] \[\rho=\sum_{i=1}^{N}\sum_{j=1}^{N}\mathrm{AsyCov}\left(\sqrt{T}f_{ij},\sqrt{T}s_{ij}\right)\] \[\gamma=\sum_{i=1}^{N}\sum_{j=1}^{N}\left(\phi_{ij}-\sigma_{ij}\right)^2\]$\pi$가 크다는 것은 표본 공분산행렬의 추정오차가 크다는 의미이므로 target 방향으로 더 많이 shrink할 필요가 있다.
반대로 $\gamma$가 크다는 것은 constant-correlation target이 실제 공분산구조와 크게 다르다는 의미이므로 target에 주는 비중을 줄여야 한다.
또한 다른 조건이 같다면 관측치 $T$가 많아질수록 표본 공분산행렬을 더 신뢰할 수 있으므로 shrinkage intensity는 작아진다.
실제 자료를 이용한 추정
$\pi$, $\rho$, $\gamma$는 실제 값을 알 수 없으므로 표본자료로 추정한다.
먼저 $\pi$의 추정량은 다음과 같다.
\[\widehat{\pi}=\sum_{i=1}^{N}\sum_{j=1}^{N}\widehat{\pi}_{ij}\] \[\widehat{\pi}_{i,j} = \frac{1}{T} \sum_{t=1}^{T} \left[ \left(y_{i,t}-\bar y_i\right) \left(y_{j,t}-\bar y_j\right) - s_{i,j} \right]^2\]$\widehat{\pi}{i,j}$는 시점별 공분산 계산값이 표본 공분산 $s{i,j}$ 주변에서 얼마나 변하는지를 측정한다.
Target과 표본 공분산행렬이 공유하는 추정오차를 계산하기 위해 다음 값을 정의한다.
\[\widehat{\vartheta}_{ii,\,ij} = \frac{1}{T} \sum_{t=1}^{T} \left[ \left(y_{i,t}-\bar y_i\right)^2-s_{i,i} \right] \left[ \left(y_{i,t}-\bar y_i\right) \left(y_{j,t}-\bar y_j\right) - s_{i,j} \right]\] \[\widehat{\vartheta}_{jj,\,ij} = \frac{1}{T} \sum_{t=1}^{T} \left[ \left(y_{j,t}-\bar y_j\right)^2-s_{j,j} \right] \left[ \left(y_{i,t}-\bar y_i\right) \left(y_{j,t}-\bar y_j\right) - s_{i,j} \right]\]이를 이용한 $\rho$의 추정량은 다음과 같다.
\[\widehat{\rho} = \sum_{i=1}^{N}\widehat{\pi}_{i,i} + \sum_{i=1}^{N} \sum_{\substack{j=1\\j\neq i}}^{N} \frac{\bar r}{2} \left( \sqrt{\frac{s_{j,j}}{s_{i,i}}}\, \widehat{\vartheta}_{ii,\,ij} + \sqrt{\frac{s_{i,i}}{s_{j,j}}}\, \widehat{\vartheta}_{jj,\,ij} \right)\]Target과 표본 공분산행렬 사이의 제곱거리로 $\gamma$를 추정한다.
\[\widehat{\gamma} = \sum_{i=1}^{N} \sum_{j=1}^{N} \left(f_{i,j}-s_{i,j}\right)^2\]따라서 $\kappa$의 추정량은 다음과 같다.
\[\widehat{\kappa} = \frac{\widehat{\pi}-\widehat{\rho}} {\widehat{\gamma}}\]최종 shrinkage intensity는 다음과 같이 계산한다.
\[\widehat{\delta}^{\ast} = \max\left( 0,\, \min\left( \frac{\widehat{\kappa}}{T},\,1 \right) \right)\]$\widehat{\kappa}/T$가 0보다 작으면 0으로, 1보다 크면 1로 제한한다. 이는 shrinkage intensity가 항상 0과 1 사이에 있도록 만들기 위한 것이다.
최종 shrinkage 공분산행렬은 다음과 같다.
\[\widehat{\Sigma}_{\mathrm{Shrink}} = \widehat{\delta}^{\ast}F + \left(1-\widehat{\delta}^{\ast}\right)S\]Appendix C. 기대초과수익률 전망의 생성
Appendix C에서는 실증분석에 사용할 기대초과수익률 전망 $\widehat{\alpha}_{it}$을 어떻게 생성했는지 설명한다.
이 논문의 목적은 동일한 전망이 주어졌을 때 공분산 추정방법에 따라 포트폴리오 성과가 어떻게 달라지는지를 비교하는 것이다.
따라서 연구자는 실제 초과수익률에 무작위 잡음을 추가하여 일정한 예측능력을 가진 액티브 매니저를 모의한다.
1단계: Raw forecast 생성
주식 $i$의 시점 $t$ 초과수익률을 $e_{it}$라고 하자.
\[e_{it}=y_{it}-r_{B,t}\]여기서 $y_{it}$는 주식 $i$의 수익률이고, $r_{B,t}$는 벤치마크 수익률이다.
실현 초과수익률에 무작위 잡음 $u_{it}$을 더하여 raw forecast를 생성한다.
\[\mathrm{raw}_{it}=e_{it}+u_{it}\]잡음 $u_{it}$은 평균이 0인 정규분포를 따르며, 종목 사이와 시점 사이에서 서로 독립적으로 생성된다.
잡음이 작으면 raw forecast가 실제 초과수익률과 강하게 연결되므로 예측능력이 높다. 반대로 잡음이 크면 예측능력이 낮아진다.
이 과정은 정해진 수준의 예측능력을 가진 가상의 액티브 매니저를 만들기 위한 실험장치이다.
2단계: Information Coefficient 설정
Information coefficient는 전망과 실제 초과수익률 사이의 예측관계를 나타내는 값이다.
Fundamental Law of Active Management에 따르면 사전적 정보비율은 대략 다음과 같이 표현된다.
\[\mathrm{IR}\approx\mathrm{IC}\sqrt{\mathrm{Breadth}}\]여기서 breadth는 1년 동안 수행하는 독립적인 액티브 투자판단의 수를 나타낸다.
이 실험에서는 매월 $N$개 종목에 대해 독립적인 전망을 생성하므로 breadth는 다음과 같다.
\[\mathrm{Breadth}=12N\]논문은 제약이 없는 경우의 사전적 정보비율을 모든 벤치마크 규모에서 약 1.5로 고정한다.
따라서 IC는 다음과 같이 설정된다.
\[\mathrm{IC}=\frac{1.5}{\sqrt{12N}}\]벤치마크 규모별 IC의 예시는 다음과 같다.
| 벤치마크 규모 | IC |
|---|---|
| $N=30$ | 0.0791 |
| $N=100$ | 0.0433 |
| $N=500$ | 0.0194 |
$N$이 증가하면 독립적인 투자판단의 수가 많아진다. 따라서 전체 사전적 정보비율을 1.5로 유지하기 위해 각 개별 전망에 요구되는 IC는 작아진다.
3단계: Raw forecast의 표준화
주식마다 raw forecast의 평균과 변동성이 다르므로 이를 표준화한다.
주식 $i$의 raw forecast 표본평균과 표본표준편차를 각각 $\overline{\mathrm{raw}}i$와 $s{\mathrm{raw},i}$라고 하자.
표준화된 score는 다음과 같다.
\[\mathrm{score}_{i,t} = \frac{ \mathrm{raw}_{i,t}-\overline{\mathrm{raw}_{i}} }{ s_{\mathrm{raw},\,i} }\]Score가 양수이면 해당 주식이 평균보다 높은 초과수익률을 기록할 것으로 전망한다는 의미이고, 음수이면 평균보다 낮을 것으로 전망한다는 의미이다.
4단계: 최종 기대초과수익률 전망 생성
표준화된 score에 해당 주식의 변동성과 IC를 곱하여 최종 기대초과수익률 전망을 만든다.
\[\widehat{\alpha}_{it}=s_{e,i}\cdot\mathrm{IC}\cdot\mathrm{score}_{it}\]여기서 $s_{e,i}$는 주식 $i$의 실현 초과수익률 표준편차이다.
| 구성요소 | 역할 |
|---|---|
| $s_{e,i}$ | 주식별 초과수익률 변동성 반영 |
| $\mathrm{IC}$ | 액티브 매니저의 예측능력 반영 |
| $\mathrm{score}_{it}$ | 해당 시점의 전망 방향과 상대적 강도 반영 |
전체 전망 생성과정은 다음과 같이 정리할 수 있다.
\[e_{it}\longrightarrow\mathrm{raw}_{it}\longrightarrow\mathrm{score}_{it}\longrightarrow\widehat{\alpha}_{it}\]생성된 $\widehat{\alpha}_{it}$은 매월 포트폴리오 최적화 문제의 기대초과수익률 전망으로 사용된다.
\[x_t^\top\widehat{\alpha}_t\geq g\]여기서 $g=300\mathrm{bp}$는 포트폴리오가 달성하도록 설정한 연간 목표 기대초과수익률이다.
사전적 정보비율 1.5와 목표 기대초과수익률 300bp는 서로 다른 역할을 한다.
- 사전적 정보비율 1.5는 생성한 전망의 품질을 통제한다.
- 목표 기대초과수익률 300bp는 최적화된 포트폴리오가 달성해야 하는 기대수익률 조건이다.
사전적 정보비율과 실현 정보비율의 차이
실제 실현 정보비율은 사전적으로 설정한 1.5와 일치하지 않을 수 있다.
그 이유는 다음과 같다.
첫째, 실제 포트폴리오에는 long-only 제약과 개별 종목의 최대 비중 제약이 존재한다.
둘째, 포트폴리오 최적화에서는 실제 공분산행렬 $\Sigma$가 아니라 추정된 공분산행렬 $\widehat{\Sigma}$를 사용한다.
셋째, 무작위 잡음 $u_{it}$으로 인해 표본에서 실현되는 전망의 정확도가 매번 달라진다.
따라서 연구자는 전망 생성과 전체 실증분석을 50회 반복하고, 정보비율과 초과수익률 등의 평균 요약통계량을 보고한다.
Reference
- Ledoit, O., & Wolf, M. (2003). Honey, I Shrunk the Sample Covariance Matrix. Working Paper.
이 글은 위 논문의 내용을 학습 목적으로 번역하고 정리한 글이다. 일부 문장은 이해를 돕기 위해 의역하거나 설명을 추가했으며, 표와 그림의 수치는 원문을 바탕으로 재구성하였다.