Optimization Theory : Line Search Methods
이번 글에서는 Optimization Theory — Line Search Algorithms 를 순서대로 번역하고, 각 방법의 작동 이유와 한계를 정리한다. 이전의 최적성 조건에서 최적해의 성질을 배웠다면, 이번에는 최적해를 실제 계산으로 찾아가는 방법에 집중한다.
탐색법의 전체 흐름은 구간을 줄이는 방법 → 함수 모양을 보간하는 방법 → 도함수의 영점을 찾는 방법이다. 처음 두 부류는 함수값만으로 수행할 수 있지만, 뒤로 갈수록 미분 정보를 적극적으로 사용한다. 미분 정보를 더 쓰면 빠를 수 있지만 그만큼 초기점과 함수의 형태에 민감해진다.
1. Introduction (p.1–2)
강의의 제목은 Line Search Algorithms이며, 일변수 함수의 국소 최솟점을 찾는 반복적인 수치 알고리즘을 다룬다.
2. General Idea of Line Search Methods (p.3)
함수 f가 실수에서 실수로 가는 함수이고, 작은 정수 K에 대해 초기값 x0, …, x(K−1)이 주어져 있다고 하자. 이후의 근삿값을 다음의 일반적인 반복 규칙으로 만든다.
목표는 이 수열의 극한이 함수 f의 국소 최솟점 x*가 되게 하는 것이다.
반복 함수 F는 f의 함수값이나 1계 도함수 f′, 필요하다면 2계 도함수 f″를 이용해 설계한다. 단순히 수열이 수렴하기만 하면 되는 것은 아니다. 그 수렴점이 실제 최솟점인가를 추가로 판단해야 한다.
3. Methods Based on Interval Reduction (p.4–5)
3.1 Idea and Unimodality (p.4)
Unimodal 함수는 고려하는 구간 안에서 한 번의 최솟값 구조를 갖는 함수다. 함수가 [a,b]에서 unimodal이고 최솟점을 x*라 하자. 내부의 두 시험점을 왼쪽에서 오른쪽으로 xa, xb 순서로 놓는다.
함수값 f(xa), f(xb)의 대소를 비교하면 최솟점이 반드시 포함되는 쪽을 남길 수 있다. 구간 축소에서 중요한 것은 정확한 최솟점을 한 번에 구하는 것이 아니라, 최솟점을 버리지 않으면서 후보 구간을 줄이는 것이다.
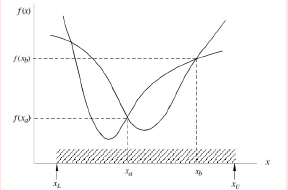
Figure 1. 두 내부점의 함수값을 비교해 탐색 범위를 줄이는 그래프.
3.2 Interval Reduction Rules (p.5)
슬라이드의 세 경우는 다음과 같다.
첫째 경우에는 오른쪽 끝을, 둘째 경우에는 왼쪽 끝을 버린다. 같을 때는 중앙 구간을 남긴다. 이를 반복하면 최솟점을 포함하는 구간을 원하는 만큼 좁힐 수 있다. 이러한 보장의 출발점은 unimodality 가정이다.
4. Golden-Section Search (p.6–8)
4.1 Original Algorithm (p.6)
Golden-section search는 시험점의 위치를 황금비에서 나온 상수 K로 정한다.
슬라이드 첫 알고리즘의 입력은 a, b, 함수 f, 양의 허용오차 ε이다. 매 반복마다 시험점 두 곳의 함수값을 비교하고 다음처럼 구간을 바꾼다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
Input: a, b, f, ε > 0
xL = a; xU = b
K = (sqrt(5) - 1) / 2
while xU - xL > ε:
    xa = xU - K * (xU - xL)
    xb = xL + K * (xU - xL)
    fa = f(xa); fb = f(xb)
    if fa < fb:
        xU = xb
    elif fa > fb:
        xL = xa
    else:
        xL = xa; xU = xb
x_star = (xU + xL) / 2
반복 후에는 남은 구간의 중점을 x*의 근사값으로 돌려준다.
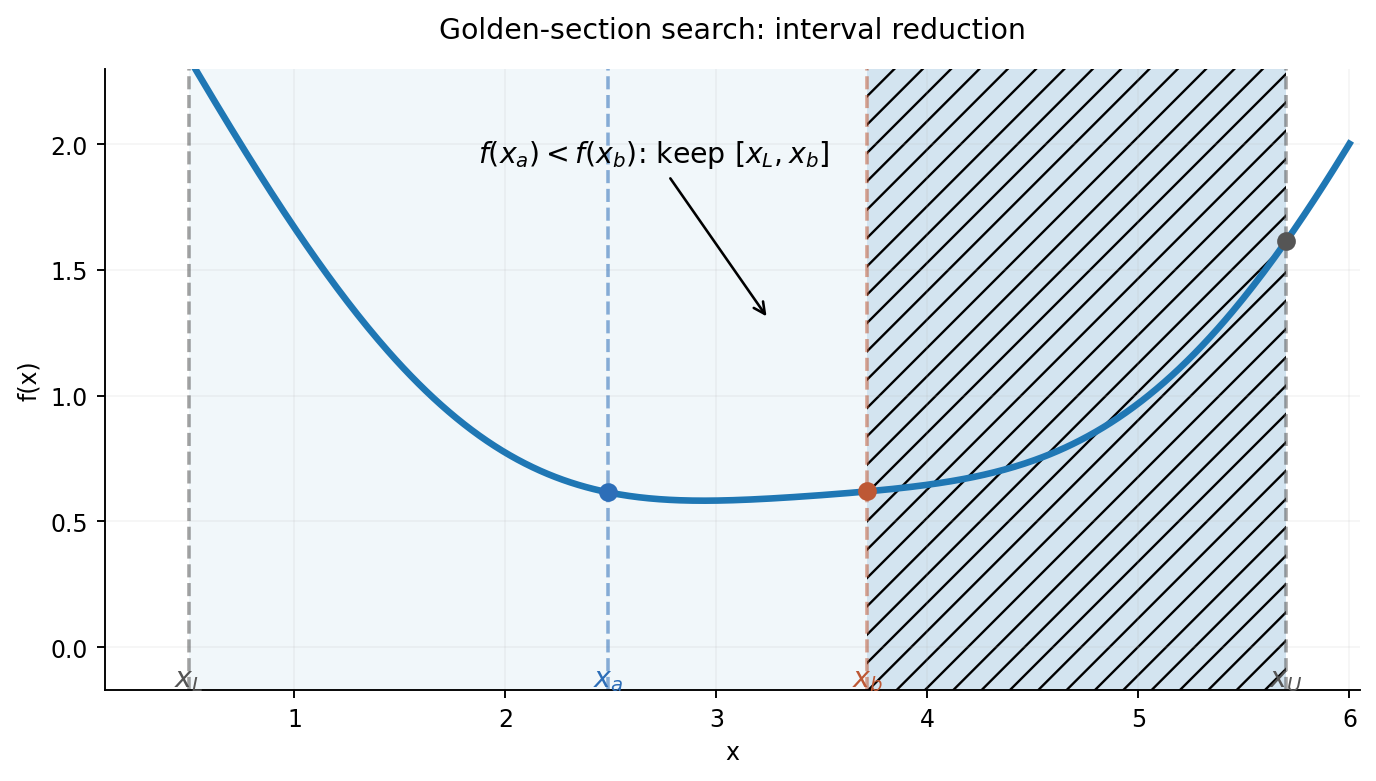
Figure 2. 반복에 따라 [xL, xU]가 축소되는 과정의 설명용 시각화.
4.2 Improved Algorithm — Reusing Function Values (p.7)
앞선 알고리즘에서는 매번 f(xa)와 f(xb)를 새로 계산한다. 그러나 황금비의 특별한 성질 때문에 구간을 줄인 뒤에는 기존의 시험점 중 하나를 그대로 재사용할 수 있다. 처음 두 번의 함수값 평가를 제외하면 반복당 새 함수값 평가는 한 번만 필요하다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
Input: a, b, f, ε > 0
xL = a; xU = b
K = (sqrt(5) - 1) / 2
xa = xU - K * (xU - xL)
xb = xL + K * (xU - xL)
fa = f(xa); fb = f(xb)
while xU - xL > ε:
    if fa <= fb:
        xU = xb
        xb = xa
        xa = xU - K * (xU - xL)
        fb = fa
        fa = f(xa)
    else:
        xL = xa
        xa = xb
        xb = xL + K * (xU - xL)
        fa = fb
        fb = f(xb)
x_star = (xU + xL) / 2
함수 평가가 비싼 경우라면 이 차이가 상당히 크다.
4.3 Theorem — Convergence and Error Bound (p.8)
함수 f가 [a,b]에서 unimodal이라면 탐색 구간의 양 끝점 수열은 그 구간의 전역 최솟점으로 수렴한다. n회 반복 후 얻은 구간 중점은 실제 최솟점에서 다음보다 멀리 떨어질 수 없다.
구간 길이가 매회 K배로 줄어드는 구조이므로 수렴 속도는 선형(linear)이다.
Remark — Multiple Local Minima. [a,b] 안에 유한 개의 국소 최솟점이 있으면 이 방법은 그중 하나에 수렴할 수 있으며, 전역 최솟값을 보장하려면 먼저 unimodal인 여러 부분 구간으로 나누어야 한다. 양 끝점이 국소 최솟점 후보가 될 수 있다는 내용도 원문에 포함된다.
5. Quadratic Interpolation (p.9–14)
5.1 Idea — Fitting Three Function Values (p.9)
세 점 a<c<b에서 측정한 함수값 f(a), f(c), f(b)를 정확히 지나는 유일한 2차 다항식 p를 만든다. p(a)=f(a), p(c)=f(c), p(b)=f(b)이다. 함수 f와 p의 모양이 비슷하다면 p의 최솟점 x_bar가 f의 최솟점을 가리키는 실마리가 된다. 보간이 충분히 정확하지 않으면 x_bar와 기존 점을 사용해 구간을 좁히고 반복한다.
5.2 Algorithm — Parabolic Minimizer (p.10)
초기 세 점은 반드시 다음 관계를 만족하도록 찾는다.
보간 다항식의 최솟점은 다음 명시식으로 계산한다.
Step 1에서 이런 초기점들을 찾고, Step 2에서 이전 x_star를 b+ε로, x_bar를 c로 초기화한다. 이후 다음 갱신을 반복한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
x_star = b + ε
x_bar = c
while abs(x_star - x_bar) > ε:
    x_star = x_bar
    x_bar = ((b*b-c*c)*f(a) + (c*c-a*a)*f(b)
             + (a*a-b*b)*f(c)) / (
             2*((b-c)*f(a)+(c-a)*f(b)+(a-b)*f(c)))
    if x_bar > c:
        d = x_bar
    else:
        d = c
        c = x_bar
    if f(c) < f(d):
        b = d
    else:
        a = c
        c = d
x_star = x_bar
이것은 슬라이드의 구간 갱신 구조를 옮긴 의사코드다. 실제 프로그래밍에서는 분모가 0에 가까운 상황, 보간 꼭짓점이 구간 밖으로 빠지는 경우를 별도로 처리해야 한다.
5.3 Finding an Initial Interval — Davies, Swann and Campey (p.11)
보간 자체보다 먼저 필요한 것은 가운데 점의 함수값이 양 끝보다 작은 초기 구간이다. 원문은 Davies–Swann–Campey 방법을 소개한다. 초기점 x0, 양의 거리 δ0, 축소비율 K(0<K<1), 작은 ε(ε≪δ0)를 입력으로 받는다.
- x0, x0−δ, x0+δ의 함수값을 비교한다.
- x0가 양쪽보다 낮다면 세 점을 즉시 채택한다.
- 그렇지 않다면 함수값이 내려가는 쪽의 방향 d(±1)를 고른다.
- 선택한 방향으로 점차 탐색 거리를 두 배로 늘려 최솟점 부근을 감싸는 세 점을 확보한다.
- 원하는 구간을 못 찾았다면 원래 탐색폭 δ0을 K배로 줄여 다시 시도한다.
원문 의사코드에서의 조건과 순서를 보존한 요약은 다음과 같다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
Input: x0, f, δ0 > 0, K in (0, 1), ε << δ0
flag = 1
while δ0 > ε and flag:
    δ = δ0
    if f(x0) < f(x0-δ) and f(x0) < f(x0+δ):
        a = x0-δ; b = x0+δ; c = x0
        flag = 0
    else:
        if f(x0-δ) < f(x0+δ): d = -1
        else: d = 1
        # Search in the downhill direction; enlarge the step.
        # The PDF algorithm uses f1, f2 and δ doubling here.
        # After bracketing, update (a, c, b).
        # If unbounded search fails: δ0 = K*δ0
위 코드는 원문 알고리즘의 이해를 위한 부분 의사코드다. 슬라이드에 인쇄된 방향 및 거리 갱신은 구현 전에 다시 확인할 필요가 있어, 생략된 내부 루프를 그대로 실행 가능한 Python 코드인 것처럼 제시하지 않았다.
5.4 Example — Doubling Steps for d = 1 (p.12)
슬라이드의 그림은 탐색 방향 d=1일 때 내부 반복이 어떻게 동작하는지 보여준다. 초기점에서 점차 오른쪽으로 탐색하며 δ, 2δ, 4δ, 8δ처럼 이동 크기를 키우고, 함수가 감소한 뒤 증가하는 구조를 찾아 최솟점을 감싸는 구간을 만든다.
그림의 핵심: 초기에 작은 간격으로만 이동하면 최솟점에 도달하기 전에 계산을 많이 할 수 있다. 감소 방향이 확인되면 탐색폭을 빠르게 늘려 적절한 시작 구간을 찾는다.
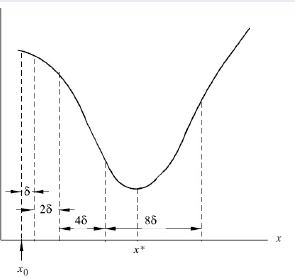
Figure 3. 슬라이드 p.12 — d=1일 때 δ, 2δ, 4δ, 8δ로 탐색폭을 늘리는 과정.
5.5 Convergence Warning and Safeguards (p.13)
중요: Quadratic interpolation은 반드시 최솟점으로 수렴하지 않는다. 연속된 두 근삿값의 차이가 ε보다 작아져도 실제 극솟점에서 멀리 떨어져 있을 수 있다. 종료조건은 곧 최적성 증명이 아니다.
원문은 이를 막기 위한 두 가지 보완을 설명한다.
- x_star의 양옆 x_star−ε와 x_star+ε의 함수값을 확인한다. 이들 중 하나가 x_star보다 낮으면 해당 방향에 맞춰 구간의 한 끝점을 갱신한다.
- 같은 이웃점 비교를 하되 최솟점 조건이 의심되면 [a,x_star] 또는 [x_star,b]에서 Golden-section search 한 단계를 수행해 새로운 c를 얻고, 그 뒤 다시 2차 보간을 계속한다.
이는 보간법의 빠른 속도와 구간 축소법의 안정성을 결합하는 발상이다.
5.6 Convergence Rate (p.14)
f가 네 번 연속 미분 가능한 C4 함수라는 적절한 조건 아래에서, 이 방법의 점근적 수렴은 약 1.32차의 초선형(superlinear)으로 소개된다. Golden-section search의 선형 수렴보다 빠르다.
원문은 실제로도 최솟점에서 멀리 종료하지 않도록 안전장치를 더한 quadratic interpolation이 Golden-section보다 상당히 빠른 경우가 많다고 설명한다.
6. Cubic Interpolation (p.15–18)
6.1 Idea — Values and Derivatives at Two Points (p.15)
Cubic interpolation은 두 점 a<b에서 네 개의 정보를 사용한다. 함수값 f(a), f(b)뿐 아니라 1계 도함수 f′(a), f′(b)까지 맞추는 유일한 3차 다항식 p를 만든다. 보간된 3차 함수는 보통 국소 최댓점과 최솟점을 하나씩 갖는다.
원문은 탐색할 최솟점이 구간 안에 있도록 다음 조건을 둔다.
보간 다항식의 최솟점이 실제 함수의 최솟점과 충분히 가깝지 않다면 [a,x_bar] 또는 [x_bar,b]로 구간을 갱신하고 반복한다.
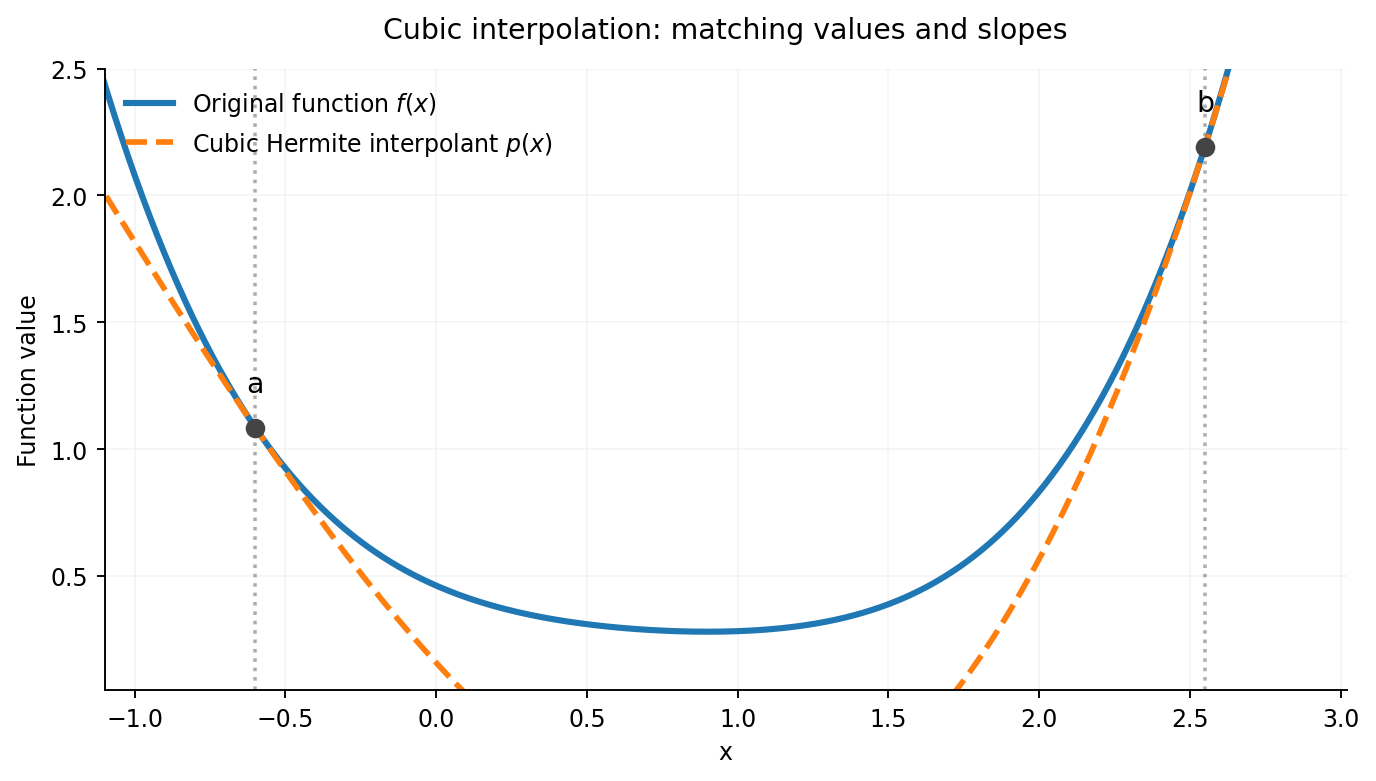
Figure 4. 양 끝점에서의 함수값과 도함수를 함께 맞추는 3차 보간 그래프.
6.2 Algorithm — Cubic Interpolation Formula (p.16)
초기 구간을 구하고, 이전 값 x_star와 새 보간 최솟점 x_bar의 차이가 ε 이하가 될 때까지 갱신한다. 중간 계산 변수 z와 w를 다음과 같이 정의한다.
원문 알고리즘은 다음과 같은 구조다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
Input: a, b, f, f_prime, ε > 0
x_star = b + ε
x_bar = a - ε
while abs(x_star - x_bar) > ε:
    x_star = x_bar
    z = 3*(f(a)-f(b))/(b-a) + f_prime(a) + f_prime(b)
    w = sqrt(z*z - f_prime(a)*f_prime(b))
    x_bar = b - (f_prime(b)+w-z) * (b-a) / (
                   f_prime(b)-f_prime(a)+2*w)
    if f_prime(x_bar) >= 0 or f(x_bar) >= f(a):
        b = x_bar
    else:
        a = x_bar
x_star = x_bar
실제 코드에서는 제곱근 내부가 음수가 되는지, 분모가 0에 가까운지, 새 점이 구간 안에 있는지 검사해야 한다. 이런 보완은 원문 의사코드에 명시된 별도 단계는 아니다.
6.3 Finding an Initial Interval (p.17)
슬라이드는 초기점 x0에서 오른쪽 방향으로 탐색한다는 가정을 분명하게 밝힌다. 탐색 구간은 처음 x0와 x0+δ를 비교하여 결정하고, 함수가 여전히 감소하면서 오른쪽 끝에서의 도함수도 음수라면 거리를 두 배로 늘린다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
Input: x0, f, f_prime, δ0 > 0, K in (0,1), ε << δ0
flag = 1
while δ0 > ε and flag:
    δ = δ0
    f1 = f(x0)
    f2 = f(x0 + δ)
    ff = f_prime(x0 + δ)
    while f2 < f1 and ff < 0 and δ is finite:
        δ = 2*δ
        f1 = f2
        f2 = f(x0 + δ)
        ff = f_prime(x0 + δ)
    if δ is finite:
        a = x0 + δ/2
        b = x0 + δ
        flag = 0
    else:
        δ0 = K*δ0
두 번째 조건은 오른쪽 끝의 기울기를 확인하여 감소 구간을 계속 따라갈지를 판단한다는 점에서 quadratic 초기 구간 탐색과 차이가 있다.
6.4 Theorem — Convergence of Cubic Interpolation (p.18)
원문의 정리는 다음과 같다. 어떤 a<b에 대해 f′(a)<0이고, f′(b)≥0 또는 f(b)≥f(a)이며, f′가 [a,b]에서 연속이면, cubic interpolation으로 생성한 근삿값 수열 x_star(k)는 f의 어떤 정지점(stationary point)으로 수렴한다.
여기서 결론은 정지점이다. 정지점에는 극솟점 이외의 점도 포함될 수 있다. 수렴과 최솟값 판정은 분리해야 한다.
7. Derivative-Based Methods (p.19–22)
7.1 Finding Zeros of the Derivative (p.19)
여기서는 함수 f의 최솟값을 직접 찾는 대신, 1계 도함수 f′의 영점을 찾는다. 도함수의 그래프와 교차점을 이용하는 접근법이다.
주의할 점은 도함수의 영점이 모두 최솟점은 아니라는 것이다. 극댓점이나 안장형 정지점도 조건을 만족할 수 있다. 일반적인 방정식의 영점 탐색법인 Newton’s method와 Secant method를 f′에 적용하는 것이 이 절의 기본 아이디어다.
7.2 Newton’s Method (p.20)
Newton 방법에서는 g=f′를 두고, g의 그래프에서 접선을 그어 x축과 만나는 점을 다음 추정치로 사용한다. 이때 g′=f″이다. 따라서 갱신식은 다음과 같다.
1
2
3
4
5
6
Input: x0, ε > 0
x_star = x0
repeat:
    previous = x_star
    x_star = previous - f_prime(previous)/f_second(previous)
until abs(previous - x_star) < ε
2계 도함수까지 필요하지만, 근방에서 조건이 좋다면 빠르게 수렴한다. f″가 0인 지점에서는 갱신이 정의되지 않으며, 초기점이 나쁘면 엉뚱한 정지점으로 갈 수 있다.
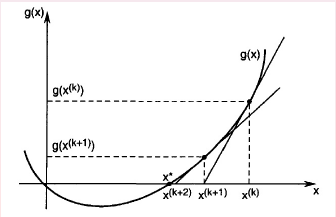
Figure 5. 도함수 g=f′의 접선과 x축 교점으로 새 값을 만드는 Newton 방법.
7.3 Secant Method (p.21)
Secant 방법은 접선을 직접 계산하는 대신, 이전 두 점을 잇는 할선(secant)의 기울기로 도함수의 변화를 근사한다. 즉, f″를 계산할 필요가 없다.
1
2
3
4
5
6
7
Input: x0, x1 with x0 != x1, ε > 0
repeat:
    x_star = x1 - (x1-x0)*f_prime(x1) / (
                          f_prime(x1)-f_prime(x0))
    x0 = x1
    x1 = x_star
until abs(x0-x1) < ε
분모가 0이 되면 계산이 불가능하고, secant 방법도 모든 초기점에서 수렴을 보장하지는 않는다.
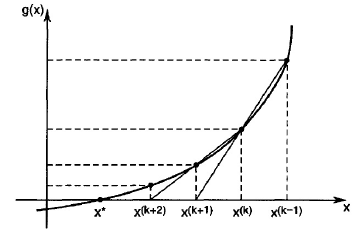
Figure 6. 두 점의 할선을 이용해 도함수의 영점을 갱신하는 Secant 방법.
7.4 Convergence of Derivative-Based Methods (p.22)
원문은 도함수 영점 탐색 기반 방법들이 일반적으로는 수렴하지 않을 수 있다고 경고한다. 슬라이드에서는 최솟점으로의 수렴을 보장하기 위해 f′가 변곡점 없이 증가해야 한다는 조건을 강조한다.
다만 적절한 근방에서 수렴하는 경우, 구간 축소법보다 점근적으로 훨씬 빠르다.
- Newton method: f′의 단순근에 대해서는 2차(quadratic) 수렴.
- Secant method: f′의 단순근에 대해서는 약 1.618차의 초선형 수렴.
- Multiple roots: 원문은 두 방법 모두 선형(linear) 수렴으로 느려진다고 설명한다.
이 결론은 빠른 방법일수록 항상 좋은 방법이라는 뜻은 아니다. 실제 계산에서는 초기점 선정, 도함수의 특성, 잘못된 정지점에 수렴할 가능성까지 함께 고려해야 한다.
8. Comparison of Line Search Methods
| Method | Main information used | Main strength | Main limitation |
|---|---|---|---|
| Interval reduction | Function values | Robust interval shrinking | Requires unimodal region |
| Golden-section | Function values | Reuses evaluations, predictable rate | Linear convergence |
| Quadratic interpolation | Three function values | Fast local approximation | May stop away from minimum |
| Cubic interpolation | Values and derivatives at two points | Exploits slope information | Needs derivative and safeguards |
| Newton | First and second derivatives | Quadratic local convergence | Sensitive to starting point and f″ |
| Secant | First derivative at two points | No explicit second derivative | Not globally reliable |
흐름을 정리하자면 함수 모양을 거의 모르는 상태에서는 구간을 안전하게 줄이고, 값이 충분히 모이면 다항식 보간으로 속도를 높이며, 도함수 정보를 신뢰할 수 있으면 정지점 방정식을 더 빠르게 해결할 수 있다는 것이다.
Reference — Piotr Więcek, Optimization Theory: Line Search Algorithms, Wrocław University of Science and Technology, 21 October 2026, slides 1–22.