Optimization Theory : Gradient Methods 1
이번 글은 Gradient Methods: Part I 를 순서대로 공부한 내용이다. 이전 글의 Line Search가 1차원에서 이동할 길이를 찾았다면, 이번에는 다변수 공간에서 어느 방향으로, 얼마나 이동할지를 결정한다.
흐름은 반복식 → 하강 방향 → Steepest Descent / Newton → Stepsize → 수렴 정리 → 수렴 속도 비교다.
1. General Idea of Gradient Methods (p.3–4)
1.1 Iterative Optimization (p.3)
제약조건 없는 다변수 함수 f의 국소 최솟점을 찾고자 한다. 사용자가 초기점 x₀를 선택하면 다음 점 x₁, x₂, …를 반복 계산하여 최솟점 x*에 접근한다.
각 단계에서 새 점은 현재 점을 이용해 결정한다.
업데이트 규칙 F는 함수값, 그래디언트, 경우에 따라 헤세 행렬을 이용한다. 바람직한 알고리즘은 다음 두 성질을 가져야 한다.
- Every iteration decreases f: 새로운 점으로 이동하면 목적함수 값이 감소해야 한다.
- Sufficient decrease: 감소가 너무 작아 최솟점에 도달하기 전에 실질적으로 정체되어서는 안 된다.
1.2 General Gradient Update (p.4)
모든 Gradient Method의 공통 형태는 다음과 같다.
여기서 각 기호는 다음을 뜻한다.
| Symbol | Meaning |
|---|---|
| xₖ | 현재 반복점 |
| ∇f(xₖ) | 현재 위치의 그래디언트 |
| Dₖ | n×n 하강 방향을 선택하는 행렬 |
| αₖ > 0 | 한 번에 얼마나 이동할지 조절하는 보폭(stepsize) |
Dₖ는 방향을, αₖ는 거리를 조절한다. 이 둘을 구분하는 것이 이번 강의의 핵심이다.
2. Descent Direction Selection (p.5–9)
2.1 General Rule for a Descent Direction (p.5)
Theorem — Positive Definite Direction Matrix
D가 대칭 양의 정부호(symmetric positive definite)이고 현재 그래디언트가 0이 아니라면, 충분히 작은 양수 α에 대해 반드시 함수값을 감소시킬 수 있다.
왜 그럴까? 이동 방향을 d = −D∇f(x)로 두면 방향도함수는 다음과 같다.
양의 정부호 행렬에서는 0이 아닌 벡터 v에 대해 vᵀDv > 0이므로, 음의 부호를 붙인 방향도함수는 음수다. 따라서 충분히 작은 걸음을 내디디면 함수값이 낮아진다.
주의: D가 양의 정부호인 것만으로 임의의 큰 α가 안전하다는 뜻은 아니다. Stepsize를 적절히 선택해야 한다.
2.2 Steepest Descent Method (p.6)
가장 간단한 양의 정부호 행렬은 단위행렬 I다. 모든 반복에서 Dₖ = I로 두는 방법이 Steepest Descent Method, 즉 최급강하법이다.
그래디언트는 함수가 가장 빠르게 증가하는 방향이므로, 음의 그래디언트는 현재 점에서 가장 빠르게 감소하는 방향이다. 단, 이 말은 한 점에서의 국소적인 방향도함수 기준이지 전 구간에서 최적 경로를 보장한다는 뜻은 아니다.
2.3 Why Does Steepest Descent Zigzag? (p.7)
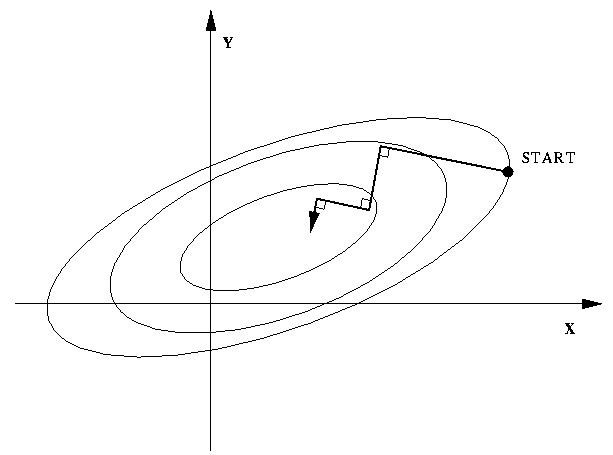
Figure 1 — 타원형 등고선에서 이동 경로가 지그재그가 된다.
최급강하법이 가장 가파른 방향을 선택하는데도 느린 이유는 무엇일까? 등고선이 가늘고 긴 타원일 때 현재 위치에서의 음의 그래디언트가 계곡의 긴 방향보다는 가로지르는 방향을 향하기 쉽다. 그러면 한쪽 벽에서 반대편 벽으로 이동하는 현상이 반복된다.
매번 현재 위치에서만 가장 빠른 감소 방향을 고르므로, 최종 최솟점까지의 경로가 가장 짧거나 반복 횟수가 최소인 것은 아니다. 이것이 다른 방향 선택법이 필요한 이유다.
2.4 Newton’s Method — Direction Matrix (p.8)
Newton 또는 Newton–Raphson 방식에서는 헤세 행렬의 역행렬을 이용한다.
따라서 갱신식은 다음과 같다.
헤세 행렬은 2계 미분을 모은 행렬이므로 함수의 곡률을 반영한다. 최급강하법보다 지형에 맞춘 방향을 선택할 수 있다.
하지만 반드시 조심해야 한다. 헤세 행렬의 역행렬이 언제나 양의 정부호인 것은 아니다. 헤세 행렬이 특이해서 역행렬이 존재하지 않을 수도 있고, 양의 정부호가 아니면 하강 방향도 보장되지 않는다.
슬라이드에서는 이 경우 역행렬을 I로 교체하거나, 역행렬과 I의 볼록결합을 사용하는 방식을 제안한다. 실제 적용 시에는 선택한 행렬이 양의 정부호가 되도록 확인해야 한다.
2.5 Why Does Newton’s Direction Work? (p.9)
Newton 방향은 갑자기 만들어진 것이 아니다. 현재 점 xₖ 부근에서 함수를 2차 Taylor 다항식으로 근사하면 자연스럽게 도출된다.
마지막 고차 오차항을 제외하면 현재 위치 주변에서의 2차 근사식이 된다.
이 2차식의 최소점을 찾기 위해 x에 대해 미분하여 0으로 놓는다.
헤세 행렬이 가역이면 다음을 얻는다.
즉 Newton Method는 현재 함수의 2차 근사모형이 최소가 되는 방향으로 이동한다. 헤세 행렬이 양의 정부호일 때 이 정지점은 근사모형의 최소점이다.
3. Stepsize Selection (p.10–12)
3.1 Optimal Stepsize and Limited Optimization (p.10)
하강 방향을 정했어도 얼마만큼 이동할지는 남아 있다. 슬라이드에서는 먼저 두 가지 최적화 기반 방법을 소개한다.
Method 1 — Optimal Stepsize (Minimization Rule)
양의 α 전체에서 Fₖ를 최소로 만드는 보폭을 선택한다.
Method 2 — Limited Optimization Rule
주어진 s > 0에 대해 탐색 범위를 (0, s]로 제한한다.
두 방법 모두 보폭 선택을 다시 1차원 최적화 문제로 바꾼다. 따라서 이전 글의 Golden-section search 등 Line Search 알고리즘을 활용할 수 있다. 실제로는 해석적인 최소화가 어렵기 때문이다.
3.2 Armijo Rule (p.11)
Armijo Rule은 정확한 최소 보폭을 계산하지 않고, 충분히 감소하는 보폭을 찾는 Inexact Line Search다.
슬라이드에서 사용하는 상수는 다음과 같다.
- s > 0: 처음 시도할 보폭
- 0 < β < 1: 보폭을 줄이는 비율
- 0 < σ < 1: 충분한 감소를 요구하는 기울기 계수
Armijo의 충분 감소조건은 다음과 같다.
이 부등식이 성립하지 않으면 α를 β배로 줄인다.
Algorithm — Armijo Backtracking
1
2
3
4
5
6
7
8
9
10
11
12
Input: current point xk, direction matrix Dk
       s > 0, beta in (0,1), sigma in (0,1)

alpha = s

grad = gradient_f(xk)

while f(xk - alpha * Dk @ grad) >= \
      f(xk) - sigma * alpha * (grad.T @ Dk @ grad):
    alpha = beta * alpha

alpha_k = alpha
예를 들어 s = 1, β = 0.5라면 보폭 후보는 1 → 0.5 → 0.25 → 0.125처럼 줄어든다. 조건이 처음 만족되는 보폭을 채택한다.
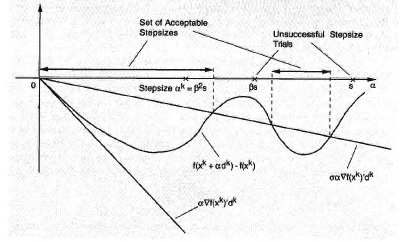
Figure 2 — 충분 감소조건을 만족하는 보폭의 범위와 만족하지 못하는 보폭의 범위.
Armijo Rule은 매번 정확한 1차원 최솟점을 찾지 않아도 되고, 함수값이 충분히 감소할 때까지만 탐색하므로 실무적으로 유용하다.
3.3 Quadratic Approximation Stepsize (p.12)
세 번째 방법은 이동 경로에 대한 2계 Taylor 근사식의 최소점을 이용하는 것이다.
Method 4 — n-Dimensional Quadratic Approximation
최급강하법에서는 다음 보폭을 사용한다.
이 식은 해당 방향의 곡률을 나타내는 분모가 양수일 때 의미가 있다.
Newton Method의 2차 근사에서는 다음을 사용한다.
Method 5 — Diminishing Stepsize
보폭이 0으로 감소하면서도 총합이 발산하도록 선택한다.
한 번의 이동은 점차 작아지지만 전체 이동 가능량은 무한하게 남겨 두는 조건이다.
Method 6 — Constant Stepsize
모든 반복에서 같은 보폭을 사용한다. 구현은 간단하지만, α가 너무 크면 불안정해질 수 있다.
4. Convergence of Gradient Methods (p.13–17)
4.1 Assumption (A) (p.13)
수렴 정리를 이해하기 위해 슬라이드는 Assumption (A)를 둔다. 이는 하강 방향이 지나치게 커지거나, 실제로 함수가 거의 줄어들지 않는 방향이 되는 현상을 통제하기 위한 조건이다.
어떤 수렴하는 부분수열 xₖₙ의 극한이 f의 정지점이 아니라고 하자. 이때 하강 방향 벡터를 다음처럼 둔다.
Assumption (A)는 방향 벡터들의 집합이 유계이고 다음 조건을 만족해야 한다고 요구한다.
이 조건은 정지점이 아닌 위치 주변에서 실질적인 하강 방향이 유지되어야 한다는 뜻이다.
슬라이드에서는 이 가정의 의미를 두 방법에 대해 설명한다.
- Steepest Descent: f가 연속 미분 가능하면 해당 방향에 대해 (A)가 성립한다.
- Newton Method: 헤세 행렬의 모든 고유값이 0보다 큰 일정한 하한 m과 유한한 상한 M 사이에 있으면 (A)를 만족한다.
4.2 Convergence with Armijo and Minimization Rules (p.14)
Theorem — Convergence to Stationary Points
함수 f가 연속 미분 가능하고, 반복열 xₖ가 Assumption (A)를 만족하는 Gradient Method로 생성되었다고 하자.
보폭을 다음 중 하나로 선택하면,
- Armijo Rule
- Minimization Rule
- Limited Minimization Rule
반복열에서 수렴하는 임의의 부분수열의 극한은 f의 정지점이다.
여기서 매우 중요한 주의사항이 있다. Stationary point를 Local minimum으로 바꿔 말할 수는 없다. 정지점에는 안장점이나 기타 극값이 아닌 점도 포함될 수 있기 때문이다. 다만 슬라이드는 해당 극한이 엄격한 국소 최댓점(strict local maximum)은 아니라고 덧붙인다.
Remark — Oscillation and Coercivity
Gradient Method는 함수값을 감소시키지만, 반복점 자체가 반드시 한 점으로 수렴하는 것은 아니다. 함수값이 같은 여러 점 사이에서 진동할 가능성이 있다.
슬라이드는 모든 국소 최솟점이 엄격하면 반복열이 어떤 국소 최솟점으로 수렴하거나 발산하며, 여기에 coercivity(강제성)까지 더해지면 수렴이 보장된다고 설명한다. 이 서술은 앞선 수렴 정리의 가정과 맥락을 함께 읽어야 한다.
4.3 Convergence with Diminishing Stepsizes (p.15)
Theorem — Diminishing Stepsize Convergence
Diminishing stepsize에는 다른 조건이 추가된다. Assumption (A)와 f의 연속 미분 가능성 외에도 그래디언트가 Lipschitz 연속이어야 한다.
또한 양수 c₁, c₂가 존재하여 모든 k에 대해 다음 조건이 성립해야 한다.
이 조건들 아래에서 수렴하는 임의의 부분수열의 극한은 정지점이다.
첫 번째 부등식은 충분한 하강 성분이 있음을, 두 번째는 방향 크기가 그래디언트에 비해 지나치게 커지지 않음을 제어한다.
4.4 Convergence with Constant Stepsizes (p.16)
Theorem — Constant Stepsize Convergence
이번에는 보폭이 일정한 경우다. Assumption (A), f의 연속 미분 가능성, 그래디언트의 Lipschitz 연속성을 가정한다.
양수 ε이 존재하여 모든 k에서 다음 범위에 보폭 α가 들어가야 한다.
그러면 수렴하는 모든 부분수열의 극한은 정지점이다.
즉 보폭을 일정하게 잡아도 되지만, 함수의 곡률과 방향 크기에 맞는 충분히 작은 값이어야 한다.
4.5 Stronger Results for Convex Functions (p.17)
Theorem — Convex Functions
함수 f가 연속 미분 가능한 볼록함수(convex function)이고 Gradient Method가 (A)를 만족한다고 하자.
Case (a) — Armijo / Minimization / Limited Minimization
- 수렴하는 임의의 부분수열의 극한은 전역 최솟점(global minimizer)이다.
- 전역 최솟값이 존재한다면 함수값 f(xₖ)는 그 값으로 수렴한다.
볼록함수에서는 정지점이 전역 최솟점이므로 p.14보다 강한 결론을 얻는다.
Case (b) — Diminishing Stepsize with Square-Summable Steps
슬라이드는 다음 두 급수 조건을 추가한다.
이 경우 전역 최솟점이 존재하면 반복열 자체가 어떤 전역 최솟점으로 수렴한다고 제시한다.
Remark — Multiple Global Minimizers
Case (a)에서는 전역 최솟점이 여러 개라면 서로 다른 최솟점 사이에서 진동할 수 있다. Case (b)에서도 제곱합 유한 조건이 없으면 유사한 진동 가능성을 배제할 수 없다.
5. Speed of Convergence: Definitions (p.18–19)
5.1 Convergence Rate Definitions (p.18)
반복법이 x*로 수렴한다고 하자. 오차를 e(xₖ)로 나타낸다.
Definition — Linear Convergence
0과 1 사이의 β가 존재하여 다음을 만족하면 선형 수렴이라고 한다.
Definition — Superlinear Convergence
Definition — Quadratic Convergence
Definition — Superlinear Convergence of Order p
p가 1보다 큰 경우를 생각하면 된다. 이때 오차가 대략 이전 오차의 p제곱 수준으로 작아진다.
5.2 Intuitive Meaning and Error Functions (p.19)
- Linear: 오차가 등비수열처럼 일정한 비율로 감소한다.
- Superlinear: 반복할수록 감소 비율 자체가 더 작아진다.
- Order p: 직관적으로 정확한 소수 자릿수가 반복당 약 p배로 늘어나는 상황을 생각할 수 있다.
강의에서는 Gradient Method의 오차를 두 가지로 평가한다.
Distance Error — Euclidean Distance
실제 최솟점 위치에서 얼마나 떨어져 있는지 측정한다.
Cost Error — Objective Value Difference
최솟값에 비해 함수값이 얼마나 큰지 측정한다.
두 오차는 같지 않다. 위치가 아직 다르더라도 함수값의 차이는 매우 작을 수 있다.
6. Speed of Steepest Descent (p.20–21)
6.1 Quadratic Objective Functions (p.20)
Theorem — Steepest Descent on a Quadratic Function
대칭 양의 정부호 행렬 Q에 대해 다음 2차 함수를 생각한다.
이 함수의 전역 최솟점은 x* = 0이다. Q의 가장 큰 고유값과 가장 작은 고유값을 각각 λmax, λmin이라 하자.
Case (a) — Constant Stepsize
슬라이드는 유클리드 거리 기준 선형 수렴의 계수를 다음처럼 제시한다.
이 계수는 적절히 선택한 일정한 보폭에서 나타나는 대표적인 수렴계수다. 아무 상수 α를 선택해도 같은 계수가 나온다는 뜻은 아니다.
Case (b) — Optimal Stepsize
최적 보폭을 사용할 때 목적함수 값의 오차는 다음 부등식을 만족한다.
이 경우에도 수렴은 선형이지만, cost error를 기준으로 표현한 결과다.
6.2 Why Eigenvalues Matter (p.20–21)
위 비율을 이해하려면 행렬 Q의 고유값을 보자.
λmax와 λmin이 비슷하면 수렴계수가 작아지므로 비교적 빠르다. 반대로 두 값의 차이가 크면 수렴계수는 1에 가까워져 느려진다.
이는 앞서 본 타원형 등고선에서의 지그재그 현상을 수학적으로 설명한다.
6.3 Extension to General Functions (p.21)
Corollary — Steepest Descent Near a Stationary Point
함수 f가 두 번 연속 미분 가능하다고 하자. 각 xₖ에서 헤세 행렬의 가장 큰 고유값과 가장 작은 고유값을 각각 다음처럼 나타낸다.
Steepest Descent 반복열이 정지점 x*로 수렴한다면, 슬라이드는 다음과 같은 국소 수렴계수 상한을 제시한다.
Constant Stepsize — Distance Error
Optimal Stepsize — Cost Error
이 식들은 최솟점 근처에서 헤세 행렬이 양의 정부호인 등 적절한 국소 조건 아래의 해석으로 읽어야 한다. 특히 고유값 분모가 0이 되거나 양의 정부호성이 없으면 그대로 적용할 수 없다.
Bottom Line: Steepest Descent의 대표적인 수렴 속도는 선형이다. 보폭 선택을 개선할 수는 있지만, 이론적으로 Newton Method보다 느릴 수 있다.
7. Speed of Newton’s Method (p.22)
Theorem — Superlinear and Quadratic Convergence of Newton’s Method
함수 f가 두 번 연속 미분 가능하고, Newton 반복열이 x*로 수렴한다고 하자. 보폭은 Armijo Rule, Minimization Rule 또는 Limited Minimization Rule로 선택한다.
Case (a) — Superlinear Convergence
슬라이드는 거리 오차의 비율이 0으로 간다는 초선형 수렴을 제시한다.
Case (b) — Quadratic Convergence
x*를 포함하는 열린 근방에서 헤세 행렬이 Lipschitz 연속이라는 추가 조건이 있으면, 최솟점 가까이에서 2차 수렴을 얻는다.
Case (c) — Unit Stepsize
초기점 x₀가 x*에 충분히 가까우면 일정한 보폭 α = 1에서도 2차 수렴이 성립한다.
Bottom Line: Newton Method는 최솟점 부근에서 초선형 수렴이 가능하고, 충분히 규칙적인 함수에서는 2차 수렴까지 가능하다. 단, 이 결론에는 헤세 행렬의 가역성 및 국소적인 적절한 곡률 조건이 필요하므로 모든 정지점에 자동으로 적용되는 것은 아니다.
8. Steepest Descent vs. Newton’s Method (p.23)
마지막 슬라이드는 두 방법의 장단점을 비교한다.
| Criterion | Steepest Descent | Newton’s Method |
|---|---|---|
| Direction matrix | Identity matrix I | Inverse Hessian |
| Uses | First derivatives | First and second derivatives |
| Typical convergence | Linear | Superlinear / Quadratic near solution |
| Computation per step | Relatively cheap | Relatively expensive |
| Stability requirements | Weaker | Stronger |
| Main drawback | Zigzag and slow progress | Hessian computation and solving linear systems |
Newton Method의 장점
최솟점 근처에서 최급강하법보다 훨씬 빠르게 수렴할 수 있다. 특히 함수의 2차 근사모형이 실제 지형을 잘 설명할 때 유리하다.
Steepest Descent의 장점
수렴에 필요한 조건이 상대적으로 약하다. 또한 Newton Method는 2계 미분 정보를 요구하며, 헤세 행렬을 계산하고 역행렬에 해당하는 선형 시스템을 해결해야 한다. 큰 행렬에서는 시간과 수치적 정확성 문제가 발생할 수 있다.
실제 구현에서는 명시적으로 역행렬을 계산하기보다 선형 시스템을 직접 푸는 방법을 사용할 수 있지만, 2계 정보 처리 비용이 크다는 핵심 문제는 그대로다.
| English | Korean | Meaning |
|---|---|---|
| Gradient Method | 경사 기반 최적화 방법 | 현재점의 도함수 정보를 이용한 반복 최적화 |
| Steepest Descent | 최급강하법 | 음의 그래디언트 방향으로 이동 |
| Newton Method | 뉴턴 방법 | 역헤세 행렬을 이용해 방향 선택 |
| Descent Direction | 하강 방향 | 충분히 작게 이동하면 함수값이 감소하는 방향 |
| Direction Matrix | 방향 행렬 | 하강 방향을 조절하는 행렬 D |
| Stepsize | 보폭 | 매 반복 이동량을 조절하는 양수 α |
| Optimal Stepsize | 최적 보폭 | 해당 방향의 목적함수를 최소화하는 보폭 |
| Limited Optimization | 제한된 보폭 최적화 | 보폭 범위를 일정 구간으로 제한 |
| Armijo Rule | 아르미호 규칙 | 충분 감소조건을 만족하는 보폭 탐색 |
| Inexact Line Search | 부정확 선 탐색 | 정확한 최소 보폭 대신 허용조건을 만족하는 보폭 선택 |
| Diminishing Stepsize | 감소 보폭 | 보폭이 점차 0으로 감소 |
| Constant Stepsize | 고정 보폭 | 매 반복 같은 보폭 사용 |
| Positive Definite | 양의 정부호 | 0이 아닌 벡터에 대한 이차형식이 양수 |
| Hessian | 헤세 행렬 | 2계 편도함수 행렬 |
| Stationary Point | 정지점 | 그래디언트가 0인 점 |
| Assumption (A) | 가정 A | 방향 벡터의 유계성과 충분한 하강 방향 조건 |
| Lipschitz Continuity | 립시츠 연속성 | 변화율을 일정한 상수로 제한하는 조건 |
| Coercivity | 강제성 | 무한히 멀리 가면 함수값이 무한대로 증가 |
| Linear Convergence | 선형 수렴 | 오차가 기하급수적으로 감소 |
| Superlinear Convergence | 초선형 수렴 | 오차 비율이 0으로 감소 |
| Quadratic Convergence | 2차 수렴 | 다음 오차가 이전 오차의 제곱 수준으로 감소 |
| Euclidean Distance Error | 유클리드 거리 오차 | 실제 해와 반복점 사이의 거리 |
| Cost Difference | 목적함수 값 차이 | 현재 함수값과 최솟값의 차이 |
| Eigenvalue | 고유값 | 행렬의 방향별 확대·축소 특성 |
| Condition Number | 조건수 | 최대·최소 고유값의 비율로 곡률 불균형 설명 |
- Gradient Methods: 현재점에서 방향 행렬 D와 보폭 α를 이용해 반복한다.
- Steepest Descent: 가장 단순하고 조건이 약하지만, 지그재그 때문에 느릴 수 있다.
- Newton Method: 헤세 행렬로 곡률을 고려해 빠른 수렴을 얻지만 계산 비용이 높다.
- Stepsize Selection: Optimal / Limited / Armijo / Quadratic Approximation / Diminishing / Constant 방식이 있다.
- Convergence Theory: 방향 조건과 보폭 조건에 따라 정지점으로의 수렴을 보장한다.
- Convexity: 볼록함수에서는 정지점에 대한 결과가 전역 최솟점에 대한 결과로 강화된다.
- Convergence Speed: Steepest Descent는 선형, Newton은 적절한 조건에서 초선형·2차 수렴을 보인다.
결국 좋은 최적화 알고리즘은 이동 방향의 질, 보폭 선택, 반복당 계산 비용, 수렴 안정성을 함께 고려해야 한다.
Reference
Piotr Więcek, Optimization Theory — Gradient Methods: Part I, Faculty of Pure and Applied Mathematics, Wrocław University of Science and Technology, 23 October 2026. Lecture slides, pp. 1–23.