Optimal Nonparametric Estimation of the Expected Shortfall Risk 3
지난 2편에서는 제안 추정량의 오차가 높은 확률로 일정한 범위 안에 들어온다는 사실을 증명했다. Theorem 1.4에서 유한 표본에 대한 오차 상한을 확보했고, Theorem 1.8에서는 일부 데이터가 악의적으로 변경되어도 그 성질이 유지되는 조건을 확인했다.
이번 3편에서는 그 성능이 Optimal하다는 주장을 살펴본다. 오차 상한을 구했다면 다음에는 그 상한을 더 개선할 여지가 있는지 확인해야 한다. 저자들은 신중하게 선택한 손실분포를 이용하여, 어떤 추정량을 사용하더라도 피할 수 없는 오차가 존재한다는 사실을 보인다.
Section 3은 Minimax Lower Bound, Quantile Function의 연속성, CLT 수준의 오차, Adversarial Corruption을 차례로 다룬다. 각 Proposition에 사용되는 분포를 먼저 살펴보고, 표본에서 어떤 사건이 발생할 때 오차의 하한이 만들어지는지 따라가려 한다.
- Lemma 3.1: Scaled Bernoulli 분포의 ES와 점근 분산을 계산한다.
- Lemma 3.2: 드문 사건이 N번 관측 가운데 한 번 이상 나타날 확률을 아래에서 제어한다.
- Proposition 3.3: Plug-in Estimator의 오차확률이 다항식 차수로 남을 수 있음을 보인다.
- Proposition 3.4 · Remark 3.5: 분위수 함수의 Lipschitz 상수 L에서 나오는 추가 오차항이 필요함을 증명한다.
- Proposition 3.6: 모든 추정량에 적용되는 CLT 규모의 하한을 도출한다.
- Proposition 3.7: K개 표본을 변조할 수 있을 때 피할 수 없는 오차를 분석한다.
3.0. Scaled Bernoulli (p. 18)
저자들은 이 절에서 Scaled Bernoulli Distribution을 반복해서 사용한다. 손실이 두 값만 가질 수 있는 간단한 분포다.
- 0: 손실이 발생하지 않은 경우
- x: 드물게 큰 손실이 발생한 경우
- p: 큰 손실이 관측될 확률
아래 그림은 p = 0.05인 설명용 예시다. 논문의 특정 Proposition에 사용한 모수값을 그대로 그린 결과는 아니다.
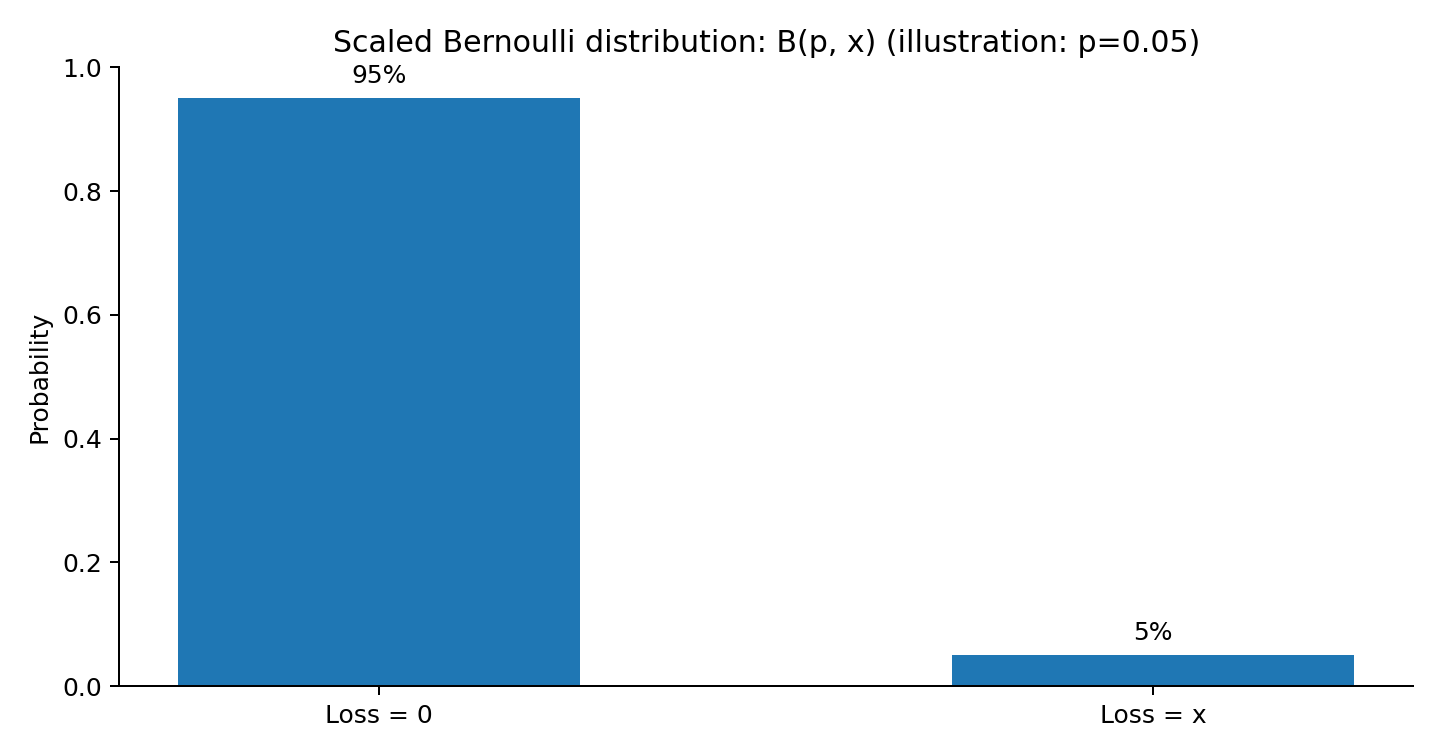
Figure 1. Scaled Bernoulli B(p, x)의 확률질량함수. 설명용 예시: p = 0.05.
이 분포를 선택하면 표본의 경험적 분포도 같은 형태를 갖는다. 큰 손실 x가 관측된 비율을 p̂_N이라고 하면, 경험적 분포는 B(p̂_N, x)로 표현된다. 따라서 ES와 추정 오차를 계산하기 편리하다.
Lemma 3.1 — Scaled Bernoulli의 ES
p ≤ α이면 상위 α 비율의 손실 구간에 x와 0이 함께 들어가므로 ES는 xp/α가 된다. p > α이면 상위 α 구간 전체가 x로 채워져 ES는 x다.
Proof — Lemma 3.1
ES 정의에 Scaled Bernoulli의 분위수 함수를 대입한다.
p ≤ α일 때 VaR₁₋α(X) = 0이다. 점근 분산의 이중적분에서 t와 s가 [0,x) 안에 있을 때 적분함수는 p−p²가 된다. 적분구간의 면적은 x²이므로 분산 식을 얻는다.
p > α이면 VaR₁₋α(X) = x이고 이중적분에 포함되는 영역에서 F_X가 1이므로 분산이 0이 된다.
Lemma 3.2 — 드문 사건도 어느 정도 확률로 관측된다
각 Aᵢ가 서로 독립이며 발생확률이 p 이상이고 p ≤ 1/N이면 다음 하한이 성립한다.
Proof — Lemma 3.2
어느 사건도 발생하지 않을 확률은 최대 (1−p)ᴺ이다.
0 ≤ Np ≤ 1에서 1−e⁻ᴺᵖ ≥ Np/4라는 느슨한 하한을 적용한다. 이후 Proposition 3.3에서 관측된 큰 손실이 적어도 한 개 있다는 사건의 확률을 구할 때 사용한다.
3.1. The minimax rate (p. 19–20)
Proposition 3.3은 Plug-in Estimator의 오차확률이 최악의 경우 다항식 속도로만 감소할 수 있음을 보인다. 앞서 Section 1에서 지적했던 heavy-tail에 대한 불안정성을 유한 표본 하한으로 뒷받침하는 부분이다.
Proposition 3.3
α ≤ 1/10, ε ≤ √α/2, Nε² ≥ 5이면 다음 성질을 가진 분포 X가 존재한다. 점근 표준편차는 1이고, 관심 분위수 구간의 분위수 함수는 1-Lipschitz이며 다음을 만족한다.
오차가 ε 이상의 크기로 발생할 확률이 1/(Nε²) 수준 이상인 예가 존재한다는 결과다. 이러한 하한은 Plug-in Estimator에 지수적인 신뢰수준 보장을 일반적으로 부여하기 어렵다는 점을 보여준다.
Proof — Proposition 3.3
δ = 2ε로 놓고 다음과 같이 분포의 모수를 결정한다.
Lemma 3.1에 의해 이 선택은 σ²_ES = 1을 만족한다. p가 매우 작아 큰 손실이 드물지만, 한 번 관측되었을 때 x의 크기가 추정량에 큰 영향을 준다.
표본에서 큰 손실 x가 하나 이상 나타나는 사건 A를 정의한다.
Lemma 3.2와 p ≤ 1/N을 이용하면 다음을 얻는다.
사건 A에서는 경험적 ES가 적어도 x/(Nα)가 된다. 모수를 이렇게 선택했기 때문에 이 값이 실제 ES보다 충분히 커지고, 논문은 그 차이가 ε 이상임을 계산한다.
따라서 사건 A의 확률이 추정 오차확률의 하한이 된다.
핵심 직관: 매우 드문 손실은 표본에 한 번 들어오는 것만으로 ES 추정량을 크게 올릴 수 있다. 표본을 늘려도 그 사건의 확률이 일정한 다항식 차수로 남도록 분포를 구성한 것이 증명의 핵심이다.
3.2. On the continuity of the quantile functions (p. 20–22)
Section 1의 오차식에는 σ/√N 항과 함께 L/N에 비례하는 항이 등장했다. Proposition 3.4는 분위수 함수가 L-Lipschitz인 분포에서도 이 추가항이 필요하다는 사실을 보인다.
Proposition 3.4
일정한 조건 아래, 다음 세 성질을 갖는 분포 X가 존재한다.
- 확률변수 X의 절댓값이 1 이하인 조건이 거의 확실하게 성립한다.
- 분위수 함수 F_X⁻¹는 (0,1)에서 L-Lipschitz이다.
- ES 추정의 점근 분산 σ²_ES는 0이다.
그런데도 Plug-in Estimator가 ε²L 규모의 오차를 보일 확률은 아래에서 제한된다.
점근 분산이 0이라 하더라도 유한 표본의 오차가 완전히 사라지는 것은 아니다. 저자들은 분위수 경계 부근의 표본 변동만으로 오차가 생기는 분포를 직접 만든다.
Proof — Proposition 3.4 — Step 1: 분포 구성
δ = ε√α/40, x₀ = −δL로 둔다. X는 x₀와 0에서 확률질량을 가지며 두 점 사이에 연속적인 분포를 갖도록 설계한다.
구간 (x₀,0)에는 전체 확률 δ를 균일하게 배치한다. 이 분포의 분위수 함수는 중간 구간에서 기울기 L을 갖고 나머지 구간에서는 상수다.
상위 α 분위수 구간의 값이 0이므로 ESα(X) = 0이고, ES 점근 분산도 0이 된다.
Proof — Proposition 3.4 — Step 2: 경험적 분위수의 변동
저자들은 x₀ 이하의 관측 비율이 실제 확률보다 2δ 이상 많아지는 사건을 사용한다.
Feller의 Binomial anti-concentration 결과를 적용하면 이 사건의 확률이 c exp(−c̃Nε²) 이상이라는 하한을 얻는다. 증명에서는 상수와 N에 관한 조건을 조정하여 exp(−c₃Nε²) 형태로 정리한다.
Proof — Proposition 3.4 — Step 3: ES 추정 오차 계산
위 사건이 발생하면 경험적 분위수는 u < 1−α+δ인 구간에서 x₀ 이하가 된다. 경험적 ES 적분의 일부 구간이 음수 x₀의 영향을 받는다.
실제 ES는 0이고, x₀의 절댓값은 δL이므로 다음과 같은 하한을 얻는다.
이 계산으로 Proposition 3.4의 오차 크기가 나온다.
Remark 3.5 — L/N 항이 등장하는 이유
ε을 대략 1/√N 규모로 선택하면 ε²L은 L/N과 같은 차수가 된다. Proposition 3.4의 확률 하한을 기대값 하한에 적용하면 다음 관계를 얻는다.
이 결과는 1편에서 다뤘던 두 번째 오차항의 역할을 설명한다. 분위수 함수의 경계가 얼마나 가파른지에 따라 유한 표본에서의 추가 오차가 커질 수 있다.
3.3. No estimator can outperform the CLT-rates (p. 22–23)
이번 절에서는 모든 추정량에 적용되는 통계적 한계를 확인한다. 증명은 ES가 다른 두 분포를 준비한 뒤, 유한한 표본으로 이 둘을 구별하기 어려운 사건을 만든다.
Proposition 3.6
ε ≤ √α/2이고 R̂_N이 임의의 추정량이면, 점근 표준편차가 1이고 관심 구간의 분위수 함수가 1-Lipschitz인 분포 X 중 다음을 만족하는 분포가 존재한다.
서로 비슷하게 관측되는 두 분포
아래 그림은 두 Scaled Bernoulli 분포가 모두 대부분의 확률을 손실 0에 두고, 서로 다른 드문 손실값에 확률을 배치하는 모습을 설명한다. 그림 속 p, x 값은 시각화를 위한 예시로, Proposition 3.6의 실제 모수 선택과 구별된다.
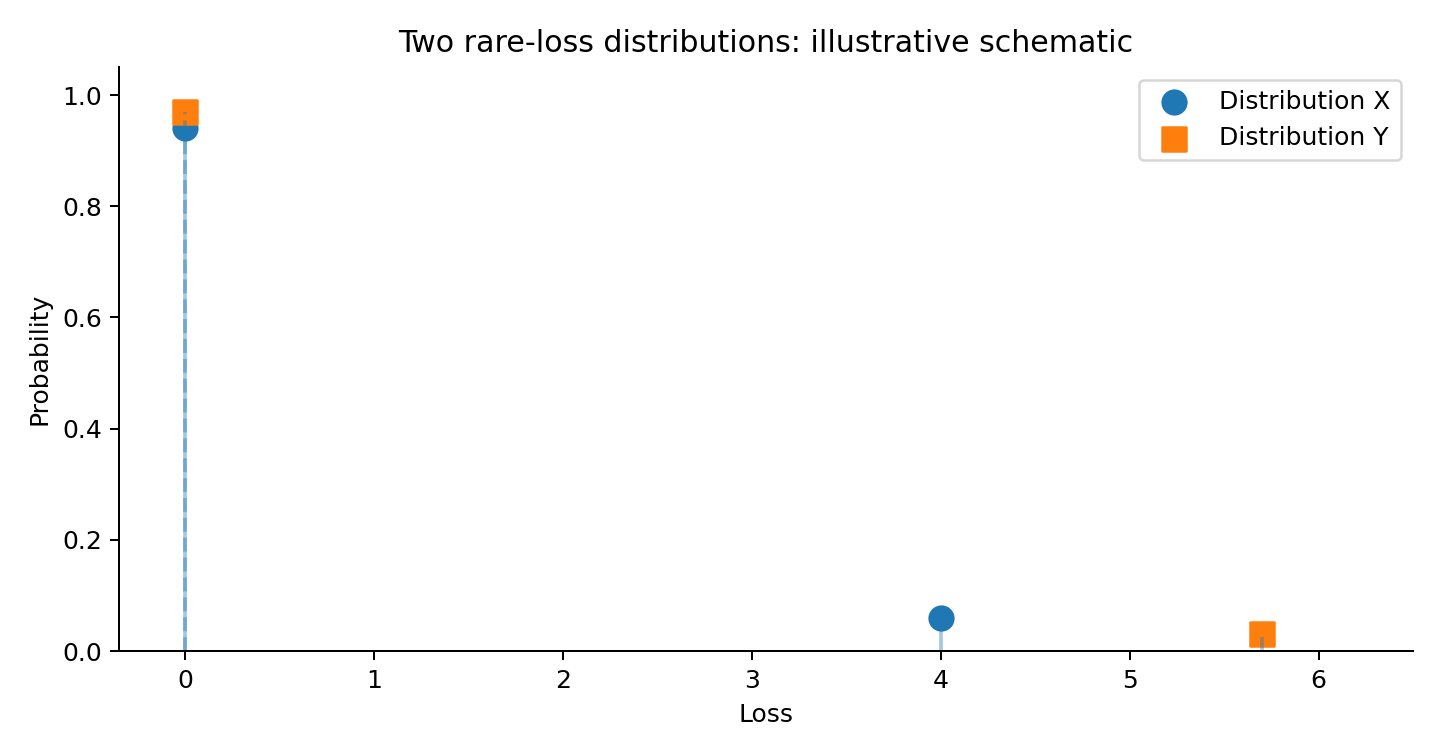
Figure 2. 드문 손실의 발생확률과 크기가 다른 두 분포의 개념도. 설명용 예시이며 Proposition 3.6의 모수값과 다름.
서로 다른 모집단의 ES를 추정하면서 표본이 거의 비슷하게 보인다면, 같은 데이터 입력에 대해 추정량은 같은 숫자를 출력하게 된다. 두 분포의 참 ES 사이에 차이가 있다면 어느 한쪽에서는 오차가 발생한다.
Proof — Proposition 3.6 — 두 분포를 이용한 하한
논문은 X ~ B(p,x), Y ~ B(q,y)를 구성하여 두 분포의 ES 점근 표준편차가 모두 1이 되도록 만든다. q = ε²/2이고 p = ε²로 설정하며 x와 y는 Lemma 3.1의 분산식으로 정한다.
이 구성에서는 두 분포의 ES 값에 충분한 간격이 있다.
두 확률변수를 결합(coupling)해 한 번 관측에서 X와 Y가 달라질 확률이 ε²/2가 되도록 한다. N번 모두 같은 값이 관측되는 사건을 A라고 두면
가 성립한다. 사건 A에서는 임의의 추정량 R̂_N이 양쪽 데이터에 대해 같은 결과를 낸다. 두 참 ES의 차이가 ε/5 이상이므로, 삼각부등식에 의해 어느 한쪽의 추정 오차는 ε/10 이상이어야 한다.
따라서 모든 추정량에 대해 exp(−Nε²) 규모의 실패확률을 피할 수 없는 분포가 존재한다.
Proposition 3.6은 Section 2에서 달성한 exp(−cNε²) 형태의 집중속도가 통계적 차수 측면에서 최적이라는 근거가 된다. 어떤 추정 알고리즘을 선택하더라도 가능한 모든 손실분포에 대해 이 차수를 근본적으로 뛰어넘을 수 없다.
3.4. The level of adversarial corruption (p. 23–24)
마지막으로 저자들은 데이터 K개를 적대적으로 변조할 수 있는 상황을 다룬다. 2편 Theorem 1.8에서는 변조 수가 제한되어 있을 때 제안 추정량의 오차를 제어했다. 여기서는 변조 비율이 커지면서 필연적으로 발생하는 오차의 하한을 증명한다.
Proposition 3.7
α ≤ 1/10, N ≥ 10, K ≤ αN/2일 때 임의의 추정량 R̂_N에 대하여 적절한 분포 X가 존재한다. 확률이 적어도 1−2exp(−K/4)인 사건에서, 적대자는 N개 중 K개 이하의 표본을 변경해 다음 규모의 오차를 발생시킬 수 있다.
허용되는 변조 개수 K와 전체 관측 개수 N의 비율이 제곱근 형태로 오차에 반영된다.
Proof — Proposition 3.7 — 변조된 표본을 이용한 구별 불가능성
Proposition 3.6에서 사용한 두 분포 X, Y를 다시 사용하고 ε = (1/2)√(K/N)으로 정한다. 결합한 두 표본에서 서로 다른 관측값의 개수를 U라고 둔다.
Bernstein 부등식을 이용하면 확률이 적어도 1−2exp(−ε²N)인 사건에서 U ≤ 4ε²N이 성립한다. 여기서 논문의 실제 설정은 ε = (1/2)√(K/N)이며, 따라서 4ε²N = K가 된다.
그 사건에서 적대자는 X 표본 중 서로 다른 U개만 바꿔 Y의 표본과 동일하게 만들 수 있다. Proposition 3.6의 두 참 ES 사이의 거리와 삼각부등식을 결합하면 한쪽에서 피할 수 없는 오차가 발생한다.
위 증명에서 중요한 점은 변조된 표본이 어느 원래 분포에서 생성되었는지 추정량이 구분하기 어려워지는 상황이다. adversarial robustness의 한계는 데이터가 갖는 정보량과 직접 연결된다.
이 장에서 증명한 네 가지 하한은 서로 다른 문제를 다룬다.
| 결과 | 다루는 질문 | 중요한 하한 |
|---|---|---|
| Proposition 3.3 | Plug-in Estimator는 얼마나 불안정할 수 있는가? | 1/(Nε²) 규모의 오차확률 |
| Proposition 3.4 | 분위수의 기울기가 클 때 추가로 필요한 오차는? | L/N 규모의 항 |
| Proposition 3.6 | 모든 추정량에 공통되는 정보적 한계는? | exp(−Nε²) 규모의 실패확률 |
| Proposition 3.7 | K개 표본이 변조될 때 피할 수 없는 오차는? | √(K/N) 규모 |
Section 2의 Upper Bound와 Section 3의 Lower Bound를 함께 읽으면 논문이 제안하는 추정량의 통계적 위치가 보다 분명해진다. 제안 추정량은 자연스러운 가정에서 높은 확률의 오차 보장을 달성하며, Section 3에서는 해당 오차 차수가 어떤 이유로 일반적으로 개선되기 어려운지 보여준다.
다음 4편에서는 Pareto Distribution을 대상으로 계산을 구체화한다. 손실분포의 꼬리모수 λ가 Plug-in Estimator의 오차확률에 어떤 영향을 주는지, 수식을 실제 모수와 연결해 살펴볼 예정이다.
Bartl, D., & Eckstein, S. (2026). Optimal Nonparametric Estimation of the Expected Shortfall Risk. arXiv:2405.00357v2. https://arxiv.org/abs/2405.00357