Optimal Nonparametric Estimation of the Expected Shortfall Risk 4
1편에서는 Expected Shortfall(ES)를 데이터로 추정하는 문제와 논문이 제안하는 강건 추정량을 살펴보았다. 2편에서는 유한 표본 오차 상한을 증명했고, 3편에서는 그 상한이 통계적으로 최적이라는 사실을 공부했다.
이번 4편에서는 Pareto distribution을 대상으로 논문의 주장을 구체적으로 계산해본다. 파레토 분포는 매우 큰 손실이 드물게 나타나는 금융 위험의 특성을 설명할 때 자주 사용하는 heavy-tailed 분포다. 특히 단 한 개의 극단적인 손실값이 전체 plug-in ES 추정값을 얼마나 크게 흔들 수 있는지 확인한다.
원문 Section 4에는 Lemma 4.1, Lemma 4.2, Remark 4.3이 등장한다. 이 글에서도 그 순서를 따르고, 각 계산이 어떤 가정에 의존하는지 함께 정리한다.
4. Explicit computations in case of the Pareto distribution (p. 24–26)
4.1 Definition of Pareto distribution
논문에서 사용하는 파레토 분포의 모수는 꼬리모수 λ와 최소 손실 수준 x₀이다. 여기서는 x₀ > 0으로 둔다.
따라서 t ≥ x₀에서 손실이 t 이상일 확률은 다음과 같다.
꼬리모수 λ가 작을수록 큰 손실이 발생할 확률이 천천히 감소한다. λ > 2이면 분산이 유한하고, λ가 2에 가까울수록 매우 큰 관측값의 영향이 커질 수 있다.
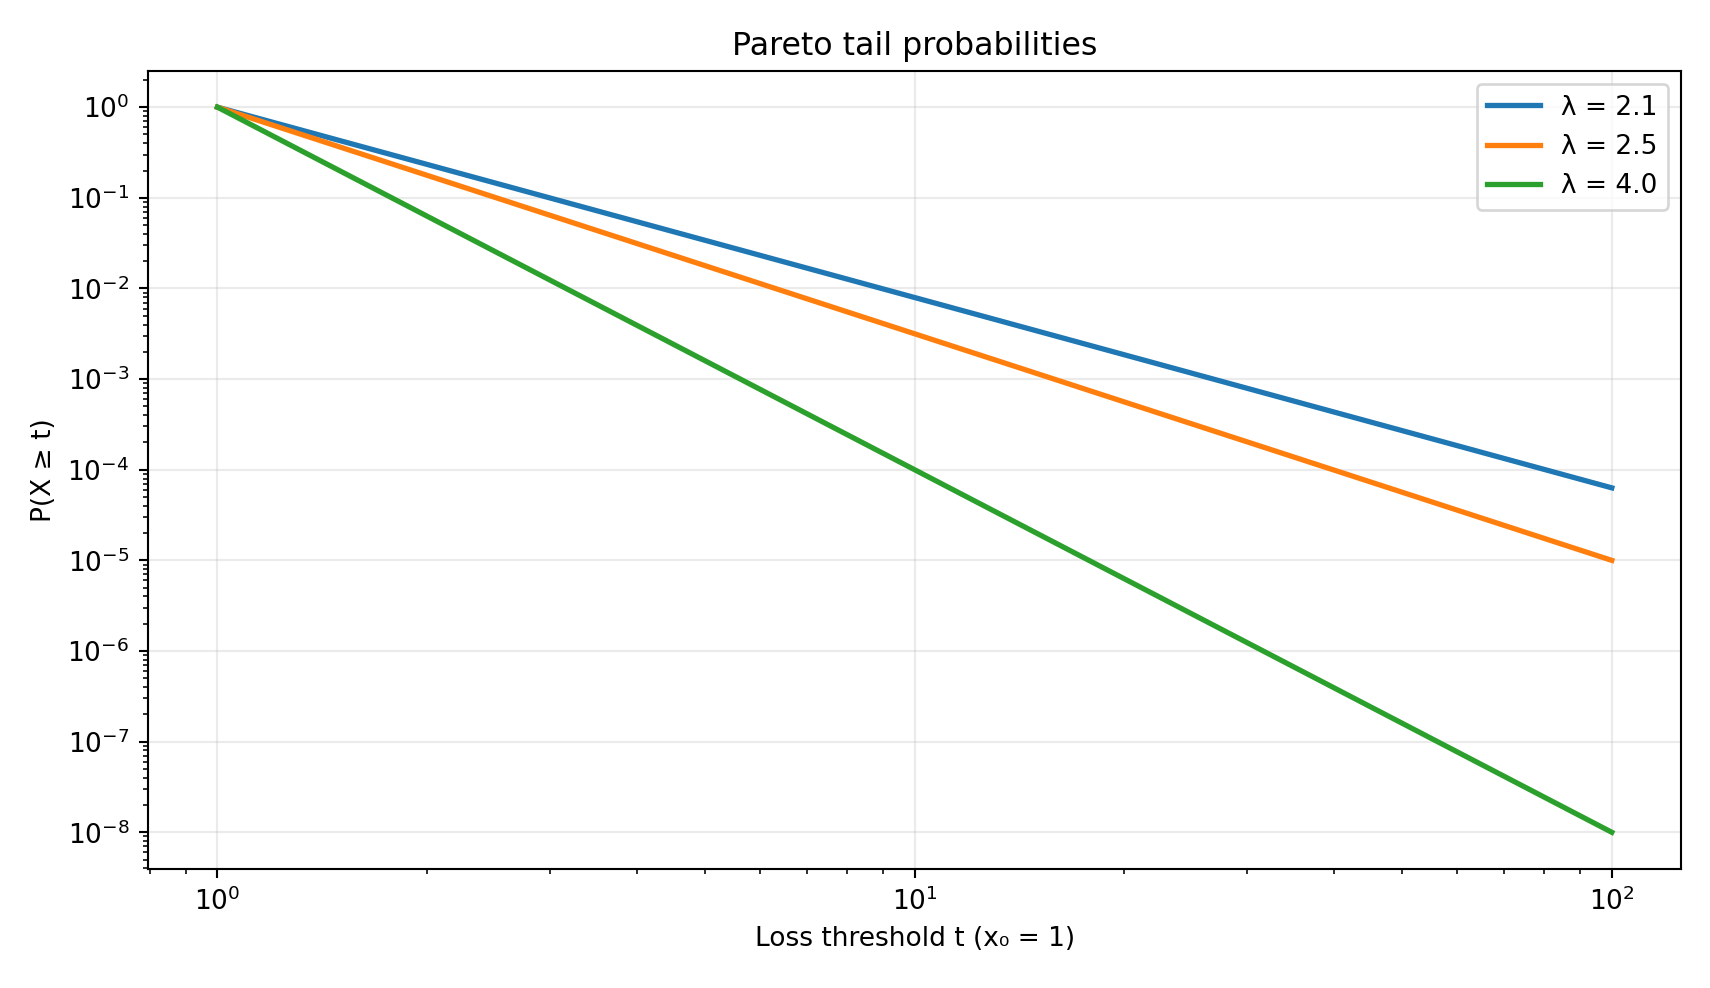
Figure 1. λ에 따른 파레토 꼬리확률 비교. x₀ = 1로 설정한 설명용 그래프이며 논문의 원본 그림은 아니다.
이 절에서 사용하는 ES는 상위 α 비율에 해당하는 손실 분위수의 평균이다. 파레토 분포의 분위수 함수는
이고, 이를 ES 정의에 대입하면
를 얻는다. λ > 1이면 이 값이 유한하다. 이후 Lemma 4.1에서는 λ > 2를 가정한다.
4.2 Lemma 4.1 — Plug-in 추정량의 다항식 오차 하한
Lemma 4.1은 파레토 분포에서 기존 plug-in ES 추정량이 일정 크기 이상 벗어날 확률에 대한 하한(lower bound)을 제시한다.
가정은 λ > 2, x₀ > 0이고 표본 수 N은 다음 조건을 만족한다.
이때 ε ≥ 0에 대해 다음 관계가 성립한다.
여기서 σ_ESα는 ES 추정 문제의 점근 표준편차다. 오른쪽에는 N의 (λ−1)제곱에 반비례하는 항이 나타난다. λ가 2에 가까우면 오차확률의 하한이 약 1/N 비율로 감소한다. 이전에 다룬 sub-Gaussian 형태의 지수적 오차확률과 큰 차이가 있다.
Proof — Lemma 4.1
Step 1. 표본 한 개가 ES 추정량을 크게 만드는 사건
손실은 모두 양수이며 plug-in ES는 가장 큰 α 비율의 관측값을 평균한다. 따라서 어느 한 관측값이 αNt 이상이면 plug-in 추정량도 t 이상이다.
Step 2. 파레토 꼬리확률을 적용
파레토 분포에서는 해당 사건의 단일 관측 확률을 직접 계산할 수 있다.
N개의 독립된 관측값 가운데 하나라도 이 사건이 발생할 확률은 1−(1−p)^N이다. p가 충분히 작아 p ≤ 1/N이면 이전 Section 3의 Lemma 3.2를 통해 하한을 얻는다.
Step 3. 오차의 기준값을 대입
논문은 t = ESα(X) + εσ_ESα를 선택한다. 이 값에 대한 위 부등식의 적용 가능성은 Lemma 4.1의 N에 관한 가정과 파레토 ES 공식으로 확인한다. 최종적으로 위에서 제시한 확률 하한을 얻는다.
극단적인 관측값 하나가 발생할 확률을 계산하고, 그 관측값이 전체 plug-in 추정량을 크게 만드는 사건을 이용한다. 이 사건의 확률이 다항식 규모로 남아 있기 때문에 plug-in 추정량에 지수적인 오차 보장을 일반적으로 기대하기 어렵다.
N을 늘리면 극단값의 영향이 점차 줄어들 수 있다. 그러나 Pareto 분포에서는 큰 관측값의 발생 확률 자체가 비교적 천천히 감소한다. 이 때문에 데이터를 더 많이 모으더라도 높은 신뢰수준의 오차 보장을 얻기가 쉽지 않다.
이 결과는 전체 데이터의 꼬리 평균을 계산하는 plug-in 방식이 heavy tails에서 겪는 구조적 어려움을 보여준다.
4.3 Lemma 4.2 — 분위수 함수의 Lipschitz 상수와 ES 점근 분산
2편의 Theorem 1.4에서는 강건 추정량의 오차 크기에 두 항이 등장했다. 하나는 ES 점근 표준편차 σ에 비례하고, 다른 하나는 분위수 함수의 Lipschitz 상수 L에 비례한다.
파레토 분포에서는 이 두 값이 α와 λ에 따라 어떻게 변하는지 계산할 수 있다. 논문은
로 두고 α ≤ 1/2를 가정한다.
(i) Lipschitz 상수 L
Lemma 4.2의 첫 번째 결론은 [1−2α, 1−α/2]에서 분위수 함수가 Lipschitz 연속이며 다음 상수를 사용할 수 있다는 것이다.
Proof — Lemma 4.2 (i)
앞서 계산한 분위수 함수를 미분한다.
이 도함수는 u가 1에 가까워질수록 증가한다. 주어진 구간의 오른쪽 끝 u = 1−α/2에서 최댓값을 갖는다.
파레토 분위수 함수를 미분하고, 관심 구간에서 도함수가 최대가 되는 지점을 찾는다. 최대 기울기를 Lipschitz 상수로 사용할 수 있다.
L은 α가 작아질수록 증가한다. ES가 극단적인 손실 구간을 대상으로 할수록 그 주변의 분위수 값이 빠르게 변할 수 있다는 사실과 연결된다.
(ii) ES 점근 분산의 상·하한
두 번째 결론은 다음과 같다.
이 식은 ES 점근 분산이 α의 거듭제곱 형태로 커질 수 있음을 보여준다. 3−2r은 λ > 2 가정에서 양수이다.
Proof — Lemma 4.2 (ii)
논문의 계산을 따라가기 위해 우선 x₀ = 1로 정규화한다. 마지막에는 분산이 스케일의 제곱에 비례한다는 성질로 x₀²을 복원한다.
Section 1의 ES 점근 분산 정의에서 t와 s를 각각 u = F(t), v = F(s)로 치환한다. 밀도 f에 대해 dt = du/f(F⁻¹(u))가 성립한다.
이제 적분 영역을 u ≤ v와 u ≥ v로 나눈다. 고정된 v에 대해 다음 두 함수를 정의한다.
논문의 식 (4.3)은 다음과 같다.
Step 1. 하한 계산
A_v는 음수가 아니고, α ≤ 1/2에서 v ≥ 1/2가 성립한다. B_v는 직접 적분할 수 있다.
A_v를 제외하고 v를 1/2로 아래에서 제한하면 분산의 하한을 얻는다. 그 결과 Lemma 4.2의 왼쪽 부등식이 성립한다.
Step 2. 상한 계산
원문은 A_v를 B_v로 제어한다.
이 부등식과 v ≤ 1을 적용하면 분산의 상한을 얻는다. 마지막으로 x₀ = 1을 해제하면 앞의 Lemma 4.2 전체 결과가 완성된다.
두 변수의 이중적분을 분위수 영역으로 변환하고, 적분 영역을 둘로 나눠 A_v와 B_v를 정의한다. B_v를 계산하고 A_v의 상한을 얻은 뒤 분산의 양쪽 경계를 도출한다.
4.4 Remark 4.3 — 두 오차항의 상대적 크기
Section 2에서 증명한 강건 추정량의 오차는 다음 두 규모를 갖는다.
첫 번째 항에는 ε와 점근 표준편차 σ가, 두 번째 항에는 ε의 제곱과 Lipschitz 상수 L이 포함된다. 어느 항이 더 큰지는 ε와 σ/L의 상대적인 크기에 달려 있다.
Lemma 4.2의 두 경계를 이용하면 파레토 분포에 대해
를 얻는다. 따라서 ε ≤ √α/4인 범위에서는 εσ 항이 ε²L 항보다 크거나 같아진다.
Remark 4.3은 1편의 Corollary 1.7과도 연결된다. 파레토 분포에서 ε가 충분히 작은 영역에서는 강건 추정량의 1차 오차항이 전체 오차 규모를 결정한다.
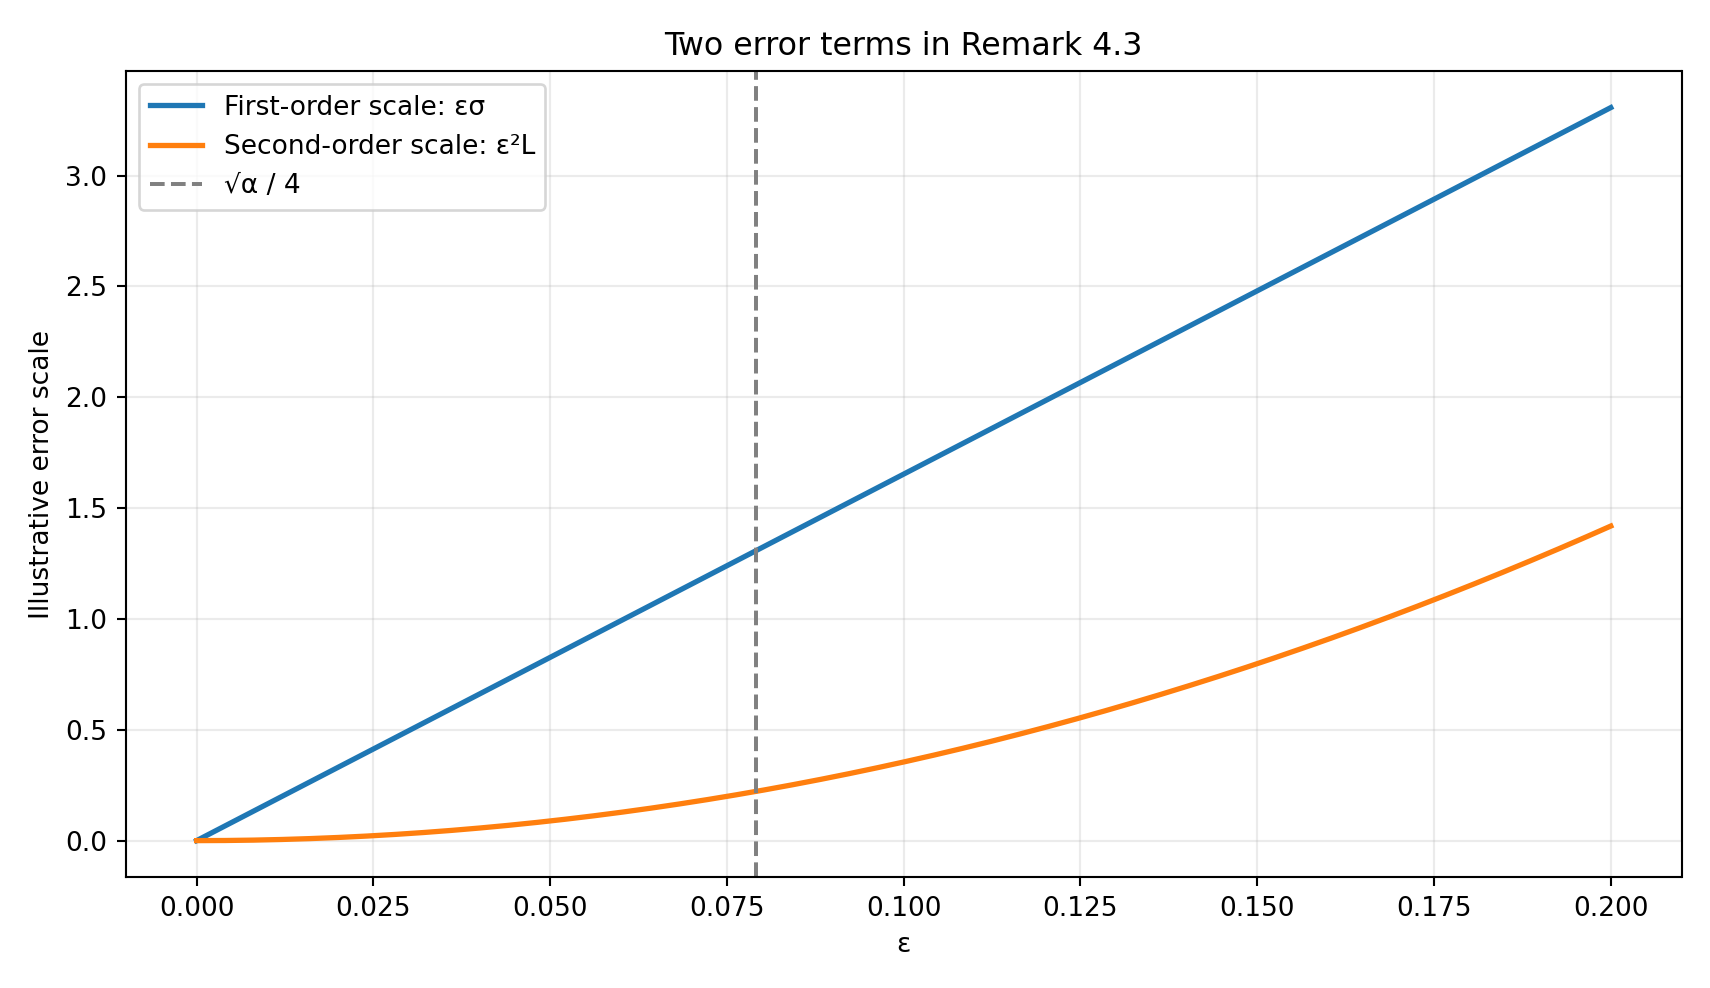
Figure 2. 두 오차항 εσ와 ε²L의 크기를 비교한 설명용 예시. α = 0.1, λ = 2.2, x₀ = 1이며 σ는 Lemma 4.2가 허용하는 범위 안의 참고값으로 설정했다. 논문의 원본 그림은 아니다.
이 그림은 ε가 작을 때 1차항의 비중이 크고, ε가 증가하면서 2차항의 상대적 비중도 증가하는 모습을 보여준다. 엄밀한 수치 계산은 Lemma 4.2의 상·하한과 별도로 구분해야 한다.
Lemma 4.1에서는 기존 plug-in 추정량이 파레토 분포의 극단값에 취약한 이유를 오차확률 하한으로 확인했다. 표본이 늘어나더라도 적어도 N의 (λ−1)제곱에 반비례하는 규모의 오차확률이 남을 수 있다.
Lemma 4.2에서는 분위수 함수의 Lipschitz 상수와 ES 점근 분산을 계산했다. 두 상수는 Theorem 1.4에서 등장한 오차항의 크기를 결정한다.
Remark 4.3에서는 앞의 계산을 합쳐 어떤 오차항이 지배적인지 살펴봤다. 파레토 분포에서는 σ/L에 대한 명시적인 하한을 얻을 수 있어, 1편의 Corollary 1.7에서 사용한 조건을 구체적으로 해석할 수 있다.
다음 5편에서는 Section 5의 Numerical experiments를 읽고, Plug-in Estimator, Median of Blocks, Proposed Estimator의 성능을 데이터와 그래프로 비교해볼 예정이다. 가능하면 논문에서 사용한 파라미터를 맞춰 Python으로 재현하는 과정도 함께 기록할 계획이다.
Bartl, D., & Eckstein, S. (2026). Optimal Nonparametric Estimation of the Expected Shortfall Risk. arXiv:2405.00357v2, Section 4, pp. 24–26. https://arxiv.org/abs/2405.00357