Control Variates for Coupon-Bond Pricing under the Black–Karasinski Model 1
Objective
본 과제에서는 Black–Karasinski(BK) 단기금리 모형을 기반으로, Monte Carlo Simulation을 이용하여 Fixed-Coupon Bond의 가격을 계산한다.
BK 모델에서는 채권 가격을 구하는 Closed-form Solution가 존재하지 않으므로, 몬테카를로 시뮬레이션 또는 다른 수치적 방법을 사용해야 한다.
먼저 Analytical Price이 존재하는 Vasicek 모델을 이용하여 몬테카를로 계산 방법이 올바르게 작동하는지 검증한다.
이후 Control Variates을 적용하여 BK 모델의 가격 추정량이 갖는 분산을 감소시킨다.
이를 위해 먼저 BK 모델과 Brownian Motion에 의해 움직이는 Vasicek 채권을 통제변량으로 사용하고, 다음으로 BK 모델의 금리 경로 자체에서 구성한 통제변량을 사용한다.
통제변량법의 성능은 사용되는 통제변량의 알려진 기대값(Known Expectation)이 얼마나 정확한지에 달려 있다. 따라서 본 과제의 핵심적인 부분 중 하나는 사용하는 기대값이 올바른지 검증하는 것이다.
과제에 적용되는 일반적인 규칙인 노트북 구조, 검증, 테스트 기록표, 구술 확인, 실행 시간 제한은 별도의 Assessment Rules에 명시되어 있다.
1. Models
이번 과제에서는 Black–Karasinski(BK) 모델과 Vasicek 모델이라는 두 가지 단기금리 모형을 사용한다. 두 모델 모두 금리가 시간에 따라 어떻게 변하는지를 확률미분방정식(SDE)으로 표현하지만, 모델링하는 대상과 금리의 움직임에는 차이가 있다.
이번 과제의 최종 목표는 Black–Karasinski(BK) 모델을 이용해 쿠폰 채권의 가격을 추정하는 것이다.
BK 모델은 채권 가격을 직접 계산할 수 있는 해석적 공식이 없기 때문에 몬테카를로 시뮬레이션을 활용한다.
반면 Vasicek 모델은 해석적 가격 공식이 존재하므로, 먼저 몬테카를로 계산의 정확성을 검증하는 데 사용한다.
이후 Vasicek 모델을 통제변량(Control Variate)으로 활용하여 BK 모델의 채권 가격 추정 과정에서 발생하는 분산을 줄이고, 보다 정밀한 가격 추정을 최종 목표로 설정할 것이다.
1.1 Black–Karasinski Model
Black–Karasinski(BK) 모델은 단기금리(Short Rate)의 로그값이 평균회귀(Mean Reversion) 성질을 가진다고 가정한다. 평균 회귀는 어떤 값이 장기적인 기준 수준에서 벗어나더라도 다시 평균적인 그 수준으로 돌아가려는 경향이다.
단기금리를 rₜ라고 할 때 로그 금리는 다음과 같이 정의된다.
여기서 xₜ는 평균회귀 성질을 갖는 Ornstein–Uhlenbeck(OU) 확률과정을 따른다.
각 기호의 의미는 다음과 같다.
| 기호 | 의미 |
|---|---|
| rₜ | 시점 t에서의 단기금리 |
| xₜ | 단기금리의 로그값 |
| κ | 평균회귀 속도(Mean Reversion Speed) |
| θ | 로그 금리의 장기 평균회귀 수준 |
| σ | 로그 금리의 변동성(Volatility) |
| Wₜ | 브라운 운동(Brownian Motion) |
| dt | 매우 작은 시간 변화량 |
이 식은 크게 두 부분으로 나눌 수 있다.
① Drift Term
현재 로그 금리 xₜ가 장기 평균 수준 θ보다 높으면 음의 방향으로, 낮으면 양의 방향으로 움직이도록 만드는 항이다.
즉, 금리가 무작위로 움직이더라도 로그 금리는 장기적으로 특정 수준을 향해 돌아가려는 성질을 가진다.
② Diffusion Term
브라운 운동에 의해 발생하는 무작위 변동을 나타낸다.
σ가 클수록 로그 금리의 무작위 움직임이 커진다.
또한 BK 모델에서는 금리를 다음과 같이 계산한다.
지수함수는 항상 양수이므로 BK 모델에서는 단기금리가 음수가 되지 않는다.
Euler Scheme
앞의 확률미분방정식은 연속시간에서 금리가 어떻게 움직이는지를 나타낸다.
하지만 컴퓨터에서는 연속적인 시간의 모든 순간을 직접 계산하기 어렵기 때문에, 시간을 작은 간격으로 나누어 계산하는 Euler 방법(Euler–Maruyama Scheme)을 적용한다.
먼저 시간 격자를 다음과 같이 설정한다.
Δt는 시간 간격, M은 전체 시간 구간의 개수, T는 최종 시점이다.
BK 모델에 적용하는 Euler 공식은 다음과 같다.
Zₖ는 서로 독립이고 동일한 표준정규분포를 따르는 난수이다.
Euler 공식은 다음 세 부분으로 이해할 수 있다.
- 현재 로그 금리
- 평균회귀에 따른 변화
- 무작위 충격에 따른 변화
현재 로그 금리에 평균회귀 효과와 무작위 충격을 더하면 다음 시점의 로그 금리를 계산할 수 있고 마지막으로 계산된 로그 금리에 지수함수를 적용하면 실제 금리 경로를 얻는다.
BK 모델의 SDE를 Euler 방법으로 이산화하여 미래의 금리 경로를 생성하는 것이 시뮬레이션의 첫 단계이다.
1.2 Vasicek Model
Vasicek 모델 역시 평균회귀 성질을 가지는 단기금리 모형이다.
다만 BK 모델과 달리 로그 금리가 아니라 금리 자체가 평균회귀 확률과정을 따른다.
Vasicek 모델의 확률미분방정식은 다음과 같다.
여기서 위첨자 v는 Vasicek 모델의 금리임을 구분하기 위한 표시이다.
| 기호 | 의미 |
|---|---|
| rₜᵛ | Vasicek 모델의 단기금리 |
| α | 평균회귀 속도 |
| β | 장기 평균 금리 수준 |
| η | 금리의 변동성 계수 |
| Wₜ | 브라운 운동 |
BK 모델과 마찬가지로 금리가 장기 평균 수준에서 벗어나면 다시 돌아가려는 성질을 가진다.
하지만 Vasicek은 금리 자체를 모델링하므로 음의 금리가 발생할 가능성이 있다는 차이가 있다.
Euler Scheme
Vasicek 모델에도 Euler 방법을 적용할 수 있다.
BK 모델의 Euler 공식과 구조는 거의 같다.
그러나 BK 모델은 로그 금리 xₜ를 계산한 후 지수함수를 적용해야 하는 반면, Vasicek 모델은 금리 rₜᵛ 자체를 직접 계산한다.
Zero-Coupon Bond Price
Vasicek 모델의 중요한 특징은 Zero-Coupon Bond의 가격을 해석적 공식으로 계산할 수 있다는 것이다. 무이표채권은 만기 전에는 별도의 이자를 지급하지 않고, 만기에 원금을 지급하는 채권이다.
Vasicek 모델의 무이표채권 가격은 다음과 같고
여기서 B(0,t)와 A(0,t)는 다음과 같이 정의된다.
각 기호의 의미는 다음과 같다.
- P_Vas(0,t) : 현재 시점 0에서 평가한, 만기 t의 무이표채권 가격
- r₀ᵛ : Vasicek 모델의 초기 금리
- A(0,t), B(0,t) : Vasicek 파라미터와 만기에 의해 결정되는 함수
Vasicek 모델에서는 연속시간 확률과정의 수학적 성질을 이용해 채권 가격을 해석적 공식으로 계산할 수 있다. 반면 Monte Carlo Simulation에서는 Euler 방법으로 금리 경로를 이산화하고, 유한한 개수의 경로를 생성해 채권 가격의 평균을 추정한다.
따라서 두 방법으로 계산한 가격 사이에는 차이가 발생할 수 있으며, 그 원인은 크게 Sampling Error와 Discretization Error로 구분할 수 있다.
Sampling Error는 무작위 표본을 유한하게 사용하기 때문에 발생하는 오차로, 시뮬레이션 횟수 N을 늘리면 일반적으로 감소하는 반면 Discretization Error는 연속시간 모델을 Euler 방법과 Trapezoidal Rule로 근사하면서 발생하는 오차이다. 이 오차는 N을 늘리는 것만으로 제거할 수 없으며, 시간 간격 Δt를 줄여 근사의 정확도를 높여야 한다. 그러므로 표본 수 N을 늘리는 것은 Monte Carlo의 통계적 오차를 줄이는 것이고, 시간 간격 Δt를 줄이는 것은 수치적 근사 오차를 줄이는 것이다.
따라서 Monte Carlo로 계산한 Vasicek 채권 가격과 해석적 가격을 비교할 때는 표준오차뿐 아니라 이산화 오차의 가능성도 함께 고려해야 한다.
1.3 Discount Factors
이전 단계를 통해 금리 경로를 생성하는 것만으로는 채권 가격을 계산할 수 없다.
채권은 미래에 이자와 원금을 지급하는 상품이므로, 미래에 받을 돈을 현재가치로 환산해야 한다. 이를 위해 Discount Factor를 계산한다.
Integrated Rate
먼저 하나의 시뮬레이션 경로에서 시점 0부터 tᵢ까지의 단기금리를 적분한다.
여기서
- j : 몬테카를로 시뮬레이션의 경로 번호
- rₛ⁽ʲ⁾ : j번째 경로에서 시점 s의 단기금리
- I⁽ʲ⁾(tᵢ) : 해당 경로에서 시점 tᵢ까지 누적된 적분 금리
를 의미한다. 금리가 시간에 따라 계속 달라지기 때문에 특정 시점의 금리 하나를 사용하는 대신, 기간 전체의 금리를 적분하는 것이다.
Trapezoidal Rule
컴퓨터에서는 연속적인 금리 경로의 적분을 직접 계산하기 어려우므로, Trapezoidal Rule을 사용하여 근사한다.
사다리꼴 공식은 인접한 두 시점의 금리를 평균 내고, 그 값에 시간 간격을 곱한 뒤 모두 더하는 방식이다.
즉, 시간에 따른 금리 그래프 아래의 면적을 여러 사다리꼴의 넓이로 근사한다고 생각하면 된다.
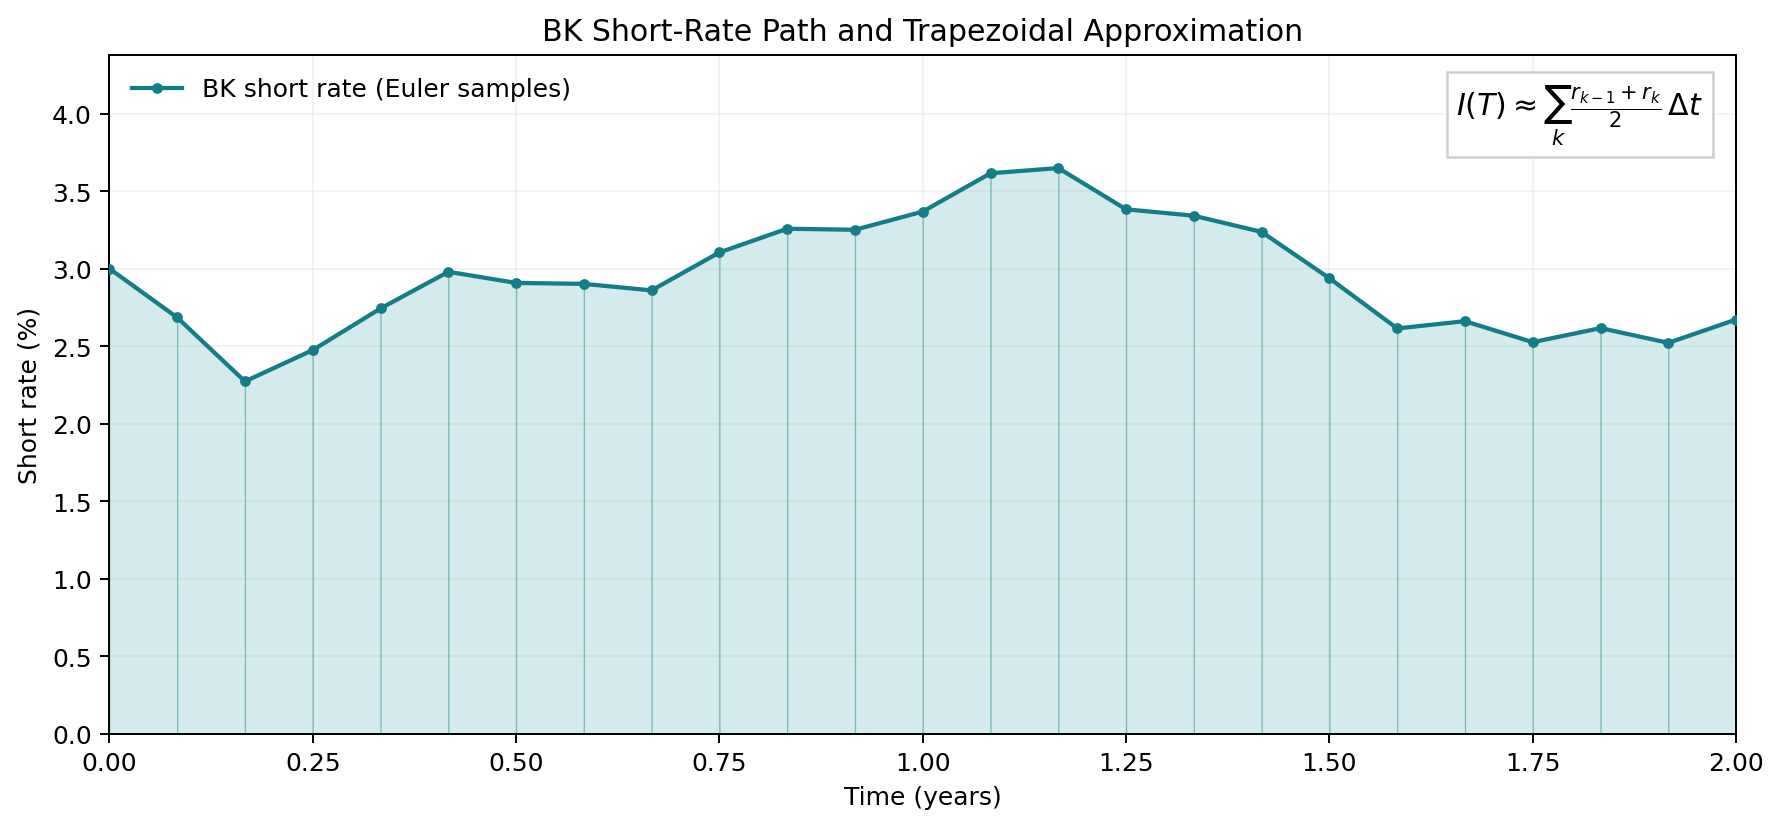
Figure 1. BK short-rate path and trapezoidal approximation of the integrated rate.
Discount Factor 계산
적분 금리를 구했다면 할인계수는 다음과 같이 계산한다.
이 식은 미래 시점 tᵢ에 지급받을 돈을 현재 시점 0의 가치로 환산하는 데 사용된다.
예를 들어 적분 금리가 0.05라면 할인계수는
이다. 미래에 받을 1의 현재가치는 약 0.9512가 되는 것이다. 중요한 점은 각 몬테카를로 경로마다 금리의 움직임이 다르기 때문에 적분 금리와 할인계수도 서로 달라진다는 것이다.
따라서 이후 채권 가격을 계산할 때는 각 경로에서 구한 할인계수를 해당 시점의 쿠폰 및 원금 지급액에 적용하게 된다.
2. Instrument
이번 과제에서 가격을 계산할 금융상품은 고정 쿠폰 채권(Fixed-Coupon Bond)이다.
쿠폰 채권은 정해진 기간 동안 일정한 이자를 지급하고, 만기에는 원금을 돌려주는 채권이고 과제에서는 만기가 T년이고, 연간 쿠폰 지급액이 C, 원금이 1인 채권을 가정한다.
쿠폰은 매년 지급되며, 만기에는 마지막 쿠폰과 원금을 함께 지급한다.
각 시점의 현금흐름은 다음과 같이 정의된다.
여기서 cᵢ는 i번째 지급 시점에 받는 금액이고, tᵢ는 해당 금액을 지급받는 시점이다.
예를 들어 만기가 5년이고 연간 쿠폰이 0.04라면, 1년부터 4년까지는 매년 0.04를 받고 마지막 5년에는 쿠폰 0.04와 원금 1을 합쳐 1.04를 받는다.
| 지급 시점 | 쿠폰 | 원금 | 총 지급액 |
|---|---|---|---|
| 1년 | 0.04 | 0 | 0.04 |
| 2년 | 0.04 | 0 | 0.04 |
| 3년 | 0.04 | 0 | 0.04 |
| 4년 | 0.04 | 0 | 0.04 |
| 5년 | 0.04 | 1 | 1.04 |
하지만 미래에 받을 금액을 단순히 더하는 것이 채권의 현재 가격은 아니다. 미래의 현금흐름을 현재가치로 환산하기 위해 앞에서 계산한 Discount Factor를 적용해야 한다.
2.1 Pathwise Discounted Payoff
몬테카를로 시뮬레이션에서는 금리 경로를 여러 개 생성하며, 각 경로에 따라 할인계수가 달라진다. 따라서 j번째 금리 경로에서 계산한 채권의 현재가치는 다음과 같다.
여기서 각 기호의 의미는 다음과 같다.
| 기호 | 의미 |
|---|---|
| Y⁽ʲ⁾ | j번째 금리 경로에서 계산한 채권의 현재가치 |
| cᵢ | i번째 지급 시점의 쿠폰 또는 원금 지급액 |
| D⁽ʲ⁾(0,tᵢ) | j번째 경로에서 시점 tᵢ까지의 할인계수 |
| n | 전체 지급 횟수 |
각 시점에 받을 금액에 해당 시점의 할인계수를 곱하고, 이를 모두 더하면 하나의 금리 경로에서 채권의 현재가치를 구할 수 있다.
앞서 계산한 할인계수는 다음과 같다.
따라서 채권의 현재가치는 다음과 같이 표현할 수도 있다.
다만 이것은 하나의 금리 경로에서 계산한 결과이므로, 아직 최종적인 채권 가격 추정값은 아니다.
2.2 Plain Monte Carlo Estimator
몬테카를로 시뮬레이션에서는 여러 금리 경로를 생성하고, 각 경로에서 계산한 채권 가치의 평균을 구한다.
이를 Plain Monte Carlo Estimator라고 한다.
예를 들어 10,000개의 금리 경로를 생성했다면, 각 경로에서 채권의 현재가치를 계산한 후 10,000개 값의 평균을 구하는 것이고 정리하면 Plain Monte Carlo는 별도의 분산 감소 기법을 적용하지 않고, 시뮬레이션 결과의 단순 평균으로 기대값을 추정하는 방법이다.
하지만 유한한 개수의 무작위 경로를 사용하기 때문에 계산 결과에는 Sampling Error(표본 오차)가 발생할 수 있다.
Vasicek 모델의 해석적 채권 가격
Vasicek 모델에서는 앞에서 배운 무이표채권의 해석적 가격 공식을 이용하여 쿠폰 채권의 가격도 계산할 수 있다.
여기서 P_Vas(0,tᵢ)는 Vasicek 모델의 무이표채권 가격이다.
무이표채권(Zero-Coupon Bond)이란 만기 전까지 별도의 이자(쿠폰)를 지급하지 않고, 만기에 원금만 지급하는 채권이다. 일반적으로 액면가보다 할인된 가격에 발행되며, 투자자는 매입 가격과 만기에 지급받는 액면가의 차이로 수익을 얻는다.
쿠폰 채권은 매년 이자를 지급하고 만기에 원금을 돌려주는 반면, 무이표채권은 만기에 한 번만 지급한다는 차이가 있다.
따라서 쿠폰 채권을 각 지급 시점에 현금흐름을 제공하는 여러 무이표채권의 합으로 생각할 수 있다. 각 지급액에 해당 만기의 무이표채권 가격을 곱한 뒤 모두 더하면 쿠폰 채권의 전체 현재가치를 계산할 수 있다.
따라서 Vasicek 모델에서는 몬테카를로로 계산한 가격과 해석적 공식으로 계산한 가격을 비교하여 수치 계산의 정확성을 검증할 수 있다.
3. Control Variates
Plain Monte Carlo는 여러 시뮬레이션 결과의 평균을 이용하여 채권 가격을 추정한다.
하지만 시뮬레이션에 무작위 표본을 사용하기 때문에, 같은 조건에서 반복 계산하더라도 추정값이 달라질 수 있다.
물론 시뮬레이션 횟수 N을 늘리면 일반적으로 표본 오차가 감소하지만, 그만큼 계산량도 증가한다.
이러한 문제를 개선하기 위해 사용하는 방법이 Control Variates(통제변량법)이다.
Control Variates는 기대값을 알고 있으면서 우리가 추정하려는 값과 높은 상관관계를 갖는 다른 변수를 활용하여 추정량의 분산을 줄이는 방법이다.
3.1 Control Variate의 정의
우리가 가격을 추정하려는 채권의 경로별 가치를 Y라고 하자.
그리고 같은 시뮬레이션 경로에서 계산한 통제변량들을 다음과 같이 정의한다.
통제변량의 기대값은 정확하게 알려져 있다고 가정한다.
이때 통제변량법을 적용한 새로운 경로별 값은 다음과 같다.
| 기호 | 의미 |
|---|---|
| Y⁽ʲ⁾ | 원래의 j번째 경로별 채권 가치 |
| X⁽ʲ⁾ | 같은 경로에서 계산한 통제변량 |
| μₓ | 통제변량의 알려진 기대값 |
| ν | 통제변량의 보정 강도를 결정하는 계수 |
| Y_CV⁽ʲ⁾ | 보정된 경로별 채권 가치 |
X가 자신의 기대값에서 얼마나 벗어났는지를 이용해 Y를 보정한다는 것이다.
예를 들어 어떤 경로에서 X가 자신의 기대값보다 높게 나왔다면, Y도 함께 높게 나왔을 가능성이 있다. 이때 X와 Y가 양의 상관관계를 가진다면, 그 영향을 일부 제거하여 Y의 변동을 줄일 수 있다.
반대로 X가 기대값보다 낮게 나왔다면 보정 방향이 달라지고 각 경로에서 관측된 X의 편차에 따라 서로 다른 크기로 보정하는 것이다.
3.2 보정해도 기대값이 유지되는 이유
통제변량법의 중요한 특징은 통제변량의 기대값이 정확하다면 보정 전후의 이론적인 기대값이 같다는 점이다.
통제변량이 하나인 경우 다음과 같이 표현할 수 있고
양쪽에 기대값을 취하면
그런데 μₓ = E[X]이므로
으로
가 성립한다. 보정항의 기대값이 0이기 때문에 원래 추정하려는 기대값을 유지할 수 있는 것이다.
다만 실제 유한한 표본에서는 보정항의 표본평균이 정확히 0일 필요는 없고 위 관계는 이론적인 기대값에 대한 성질이다.
3.3 Optimal Control Coefficient
그렇다면 보정 계수 ν는 어떻게 정해야 할까?
통제변량을 여러 개 사용할 경우, 보정 후 분산을 최소화하는 최적 계수는 다음과 같다.
여기서 Σₓ는 통제변량 벡터 X의 Covariance Matrix이다.
통제변량이 하나인 경우로 m=1이면 식이 간단해진다.
이 계수는 통제변량이 원래 추정 대상의 변동을 얼마나 설명하는지를 반영한다.
통제변량이 하나이고 분산이 0보다 클 때, 최적 계수를 적용한 분산은 다음과 같다.
따라서 X와 Y의 상관관계가 강할수록 분산 감소 효과가 커질 수 있다.
단, 위의 최적 계수는 모집단의 공분산과 분산을 알고 있다는 이론적인 상황에서의 값이므로 실제 구현에서는 표본을 이용해 계수를 추정해야 한다.
3.4 Pre-run을 이용한 계수 추정
실제 몬테카를로 시뮬레이션에서는 최적 계수 ν*를 정확히 알기 어렵기 때문에, 별도의 예비 시뮬레이션(Pre-run)을 통해 계수를 추정한다.
금융전산 수업에서 교수님은 예비 시뮬레이션의 경로 수를 전체 가격 추정용 경로 수의 약 10%로 설정하도록 요구하셨다.
예를 들어 가격 계산에 10,000개의 경로를 사용한다면, 별도의 1,000개 경로로 보정 계수 ν̂를 추정하는 것이다.
이 계수는 Pre-run에서 계산한 Y와 X의 공분산 및 분산을 이용하거나, Y를 X에 대해 최소제곱 회귀(Least-Squares Regression)하여 구할 수 있다.
중요한 조건은 Pre-run에서 사용한 경로를 최종 가격 추정에 다시 사용하지 않는 것이다.
계수를 추정하는 표본과 채권 가격을 계산하는 표본을 분리하여 최종 가격 추정에 사용할 경로들과 보정 계수의 독립성을 확보할 수 있도록 하는 것이다.
3.5 Control Variate Estimator
Pre-run에서 추정한 계수 ν̂를 이용하여 각 경로의 채권 가치를 보정한 뒤 평균을 계산한다.
이 값이 Control Variate Estimator이다.
Plain Monte Carlo가 원래 채권 가치 Y⁽ʲ⁾의 평균을 계산하는 방식이었다면, Control Variate Monte Carlo는 보정된 값 Y_CV⁽ʲ⁾의 평균을 계산하는 방식이다.
따라서 두 방법은 동일한 기대값을 추정하는 것을 목표로 하지만, Control Variates는 표본의 변동을 줄여 더 작은 표준오차를 얻는 데 목적이 있다.
3.6 Variance Reduction Factor (VRF)
통제변량법을 적용했을 때 분산이 얼마나 감소했는지를 평가하기 위해 Variance Reduction Factor(VRF)를 사용한다.
보정 전 분산을 보정 후 분산으로 나누어 VRF가 클수록 통제변량법의 분산 감소 효과가 크다는 점을 알 수 있다.
| VRF | 의미 |
|---|---|
| 1 | 분산 감소 효과 없음 |
| 2 | 기존 분산이 절반으로 감소 |
| 4 | 기존 분산이 1/4로 감소 |
| 10 | 기존 분산이 1/10로 감소 |
| 1 미만 | 보정 후 분산이 오히려 증가 |
예를 들어 VRF가 4라면 보정 후 분산은 기존의 25%가 되므로, 분산이 75% 감소한 것이다.
동일한 시뮬레이션 횟수를 사용할 때 표준오차의 비율은 다음과 같다.
따라서 VRF가 4라면 표준오차는 기존의 절반으로 감소한다.
Control Variates는 분산을 감소시키기 위한 방법이고, VRF는 그 방법의 성능을 평가하는 지표라고 이해할 수 있다.
3.7 통제변량의 기대값이 정확해야 하는 이유
마지막으로 교수님께서 다음 조건을 강조하셨다.
Control Variate 추정량이 Plain Monte Carlo와 동일한 대상을 추정하려면, 사용하는 μₓ가 실제로 시뮬레이션한 통제변량의 진짜 기대값이어야 한다.
앞에서 보정 전후의 기대값이 같다는 사실은 다음 조건에 의존했다.
그런데 만약 잘못된 기대값을 사용한다면 보정항의 기대값이 0이 아니게 되므로, 추정 결과에 편향(Bias)이 발생할 수 있다.
예를 들어 해석적 공식으로 구한 연속시간 기대값과 Euler 방식으로 시뮬레이션한 이산시간 통제변량의 기대값이 서로 다를 수 있다.
따라서 단순히 통제변량을 적용하여 VRF가 높아졌다는 이유만으로 더 정확한 가격을 계산했다고 판단할 수는 없다.
분산이 작더라도 기대값이 잘못 설정되어 있다면 잘못된 가격을 정밀하게 추정할 수 있기 때문이다.
결국 통제변량법에서는 분산 감소 효과를 확인하는 것뿐만 아니라, 사용하는 통제변량의 기대값이 올바른지 검증하는 과정도 중요하다.
이번 글에서는 Black–Karasinski(BK) 모델을 이용한 쿠폰 채권 가격 평가에 앞서, 금리 모형부터 몬테카를로 시뮬레이션, 통제변량법까지의 이론적 배경을 살펴보았다.
Section 1. Models에서는 BK와 Vasicek이라는 두 가지 단기금리 모형을 다루었다. 두 모델 모두 평균회귀 성질을 가지지만, BK는 로그 금리를, Vasicek은 금리 자체를 모델링한다는 차이가 있다. 또한 연속시간 확률미분방정식(SDE)을 Euler 방법으로 이산화하여 금리 경로를 생성하고, Trapezoidal Rule로 적분 금리를 근사한 뒤 Discount Factor를 계산하는 과정을 정리했다.
Section 2. Instrument에서는 생성한 금리 경로와 할인계수를 이용해 각 경로에서의 쿠폰 채권 현재가치를 계산하고, 여러 경로의 평균으로 채권 가격을 추정하는 Plain Monte Carlo 방법을 살펴보았다. 특히 Vasicek 모델은 해석적 채권 가격 공식이 존재하므로, 몬테카를로 추정 결과와 비교하여 수치 계산의 정확성을 검증할 수 있다는 점을 확인했다.
Section 3. Control Variates에서는 몬테카를로 추정량의 분산을 줄이기 위한 통제변량법(Control Variates)의 원리를 다루었다. 기대값을 알고 있고 추정 대상과 높은 상관관계를 갖는 변수를 이용해 경로별 채권 가치를 보정함으로써, 원래의 기대값을 유지하면서 분산을 감소시키는 방법이다. 또한 VRF(Variance Reduction Factor)를 통해 분산 감소 효과를 평가하며, 통제변량의 기대값이 정확해야 한다는 점도 확인했다.
전체적인 계산 과정은 다음과 같이 정리할 수 있다.
금리 모델 설정 → Euler 방법 적용 → 금리 경로 생성 → Trapezoidal Rule로 적분 금리 계산 → Discount Factor 계산 → 경로별 채권 가치 계산 → Plain Monte Carlo 가격 추정 → Control Variates 적용 → VRF를 통한 분산 감소 효과 평가
결국 이번 과제의 목표는 BK 모델을 기반으로 쿠폰 채권의 가격을 추정하고, Control Variates를 활용해 몬테카를로 추정의 분산을 줄이는 것이다. 다만 분산이 감소했다고 해서 모든 오차가 사라지는 것은 아니므로, 표본 오차와 이산화 오차를 구분하고 통제변량의 기대값이 올바른지도 검증해야 한다.
이번 글에서는 채권 가격을 추정하는 데 필요한 수학적 모델과 계산 원리를 중심으로 정리했다.
다음 편에서는 지금까지 살펴본 수식을 Python으로 직접 구현해볼 예정이다.
Part A에서는 Vasicek 모델에 Euler 방법을 적용해 금리 경로를 생성하고, 할인계수와 쿠폰 채권의 현재가치를 계산한다. 이후 Plain Monte Carlo로 구한 가격을 Vasicek의 해석적 가격과 비교하여 추정 오차가 발생하는 원인을 분석할 것이다.
다음으로 Part B에서는 BK 모델로 확장하여 두 가지 변동성 조건에서 채권 가격과 표준오차를 계산하고, Part C에서는 Vasicek 모델을 통제변량으로 활용해 분산 감소 효과를 비교할 계획이다. 이후 BK 경로 자체를 활용하는 통제변량과 기대값 검증까지 단계적으로 확장해보려 한다.
단순히 코드를 실행하고 결과를 확인하는 데 그치지 않고, 각 수식이 Python에서 어떻게 구현되는지, 계산 결과가 이론과 일치하는지, 오차가 발생한다면 그 이유는 무엇인지를 함께 살펴볼 예정이다.