Computational Finance : Monte Carlo
이 글은 Wrocław University of Science and Technology의 Computational Finance 2026/27 — Monte Carlo 강의자료(Jan Palczewski)를 슬라이드 순서대로 번역·정리한 학습 기록이다.
몬테카를로의 기본 개념(p.2–11) → 분산 감소의 원리(p.12–23) → 아시안 옵션과 Control Variates(p.24–32) → 최적 계수와 금융상품 응용(p.33–37) 순서로 진행한다. 슬라이드에 있는 의사코드는 Python 실습으로도 구현한다.
p.1 — Computational Finance 2026/27: Monte Carlo
확률적인 결과를 여러 번 생성해 평균을 취하면, 직접 계산하기 어려운 기댓값과 금융 파생상품 가격을 근사할 수 있다. 이때 핵심은 추정값의 정확도를 측정하고 같은 계산량에서 오차를 더 줄이는 것이다.
p.2 — Monte Carlo: The Idea
Monte Carlo는 확률변수 ξ의 기댓값을 계산하는 방법이다.
ξ의 분포로부터 독립적인 표본 ξ₁, …, ξ_M을 생성하고, 표본평균을 추정량으로 사용한다.
이 추정량은 불편(unbiased)이고, 표본평균의 분산은 M에 반비례한다.
큰 수의 법칙에 의해 M이 증가하면 a_M은 a로 수렴한다. 실제 분산을 모르므로 표본분산을 계산한다.
분모가 M−1인 것은 표본평균을 데이터로부터 추정했기 때문이다. 여기서 b_M은 표본표준편차, b_M²은 표본분산이다.
p.3 — Central Limit Theorem and Standard Error
표본이 i.i.d.이고 ξ의 평균이 a, 유한한 분산이 σ²이면 중심극한정리(CLT)에 따라
가 성립한다. 따라서 표본 수가 클 때 표본평균은 다음 정규분포로 근사된다.
σ를 표본표준편차 b_M으로 대체한 값이 표준오차(Standard Error, SE)다.
표준편차는 개별 관측값의 흩어짐을, 표준오차는 추정한 평균의 불확실성을 나타낸다.
p.4 — Confidence Interval
표본평균을 표준오차로 표준화하면 대략 표준정규분포를 따른다. 표준정규분포의 누적확률 Φ(1.96) ≈ 0.975를 이용하면
이므로 95% 신뢰구간은
이다. 일반적인 신뢰수준 1−α에서는 1.96 대신 표준정규 분위수 z_(1−α/2)를 쓴다. 99% 신뢰구간에서는 약 2.58이다.
신뢰구간의 반폭(half-width)은
z × SE다. 따라서 오차를 줄이는 방법은 표본 수 M을 늘리거나, 확률변수 ξ의 분산을 줄이는 것이다.
p.5 — z-score: Comparison with a Fixed Value
Monte Carlo로 얻은 값이 이미 알려진 기준값 c(예: 해석적으로 계산한 옵션 가격)와 일치하는지 검정한다.
귀무가설 H₀이 맞다면 z는 대략 N(0,1)을 따른다. 따라서 z는 추정값과 기준값의 차이를 표준오차 몇 개만큼인지 나타낸다.
- z의 절댓값이 1.96 이하면 5% 유의수준에서 귀무가설을 기각할 근거가 부족하다.
- z의 절댓값이 1.96보다 크면 양측 5% 검정에서 기각한다.
- z의 절댓값이 2.58보다 크면 양측 약 1% 검정에서 기각한다.
단일 검정에서 우연히 큰 z가 나올 수 있으므로, 수치가 크다는 사실만으로 버그를 확정해서는 안 된다.
p.6 — z-score, Bias and Variance
기준값 c와 참기댓값 a의 차이를 δ = a−c라고 쓰면
이다. 앞 항은 탐지하려는 신호(signal), 뒤 항은 몬테카를로의 잡음(noise)이다. 동일한 δ를 더 뚜렷하게 감지하려면 표준오차를 줄여야 한다.
분산을 k배 줄이면 z의 신호 크기는 √k배 커진다. 이는 표본을 k배 늘린 것과 비슷한 효과다.
p.7 — z-score: Two Monte Carlo Results
서로 독립적으로 얻은 두 몬테카를로 추정값 a_M과 a′_N을 비교한다. 각 계산에서 추정한 표본표준편차를 b_M과 b′_N이라 하면
이다. 독립적인 두 추정값의 차이에서는 표준오차를 빼지 않고 분산을 더한다.
두 신뢰구간의 겹침만 보고 판단하는 것보다, 차이 자체를 표준화하는 검정이 더 직접적이다.
p.8 — Why This Formula?
Step 1. 독립적인 정규변수의 차이도 정규분포를 따른다.
Step 2. 귀무가설 a = a′을 적용하면 차이의 평균이 0이 된다.
Step 3. 차이의 표준편차로 나누면 표준정규분포로 근사된다.
Proof
독립성 때문에 공분산 항이 0이다. 따라서 분산이 합쳐지고, 이를 루트 씌운 값으로 나누어 표준화한다. 두 시뮬레이션이 공통 난수를 사용한다면 독립성 가정이 깨질 수 있으며 공분산을 포함해야 한다.
p.9 — Intuitions
신뢰구간의 폭은 추정 정확도의 지표다. 95% 신뢰구간을 여러 번 구성하면 그중 약 95%가 고정된 참기댓값을 포함하도록 설계된 것이다. 나머지 약 5%는 참값을 포함하지 않을 수 있다.
한 번 계산한 특정 신뢰구간에 대해 참값이 95% 확률로 움직인다는 의미는 아니다. 반복되는 것은 표본추출과 구간 계산 절차다.
p.10 — Confidence Intervals vs. Number of Samples
슬라이드의 그림은 표본 수를 점차 늘리면 신뢰구간이 좁아지며 참값 주변에서 안정되는 모습을 보여준다. 초기에는 표본 수가 적어 추정값과 구간 폭이 크게 흔들린다.
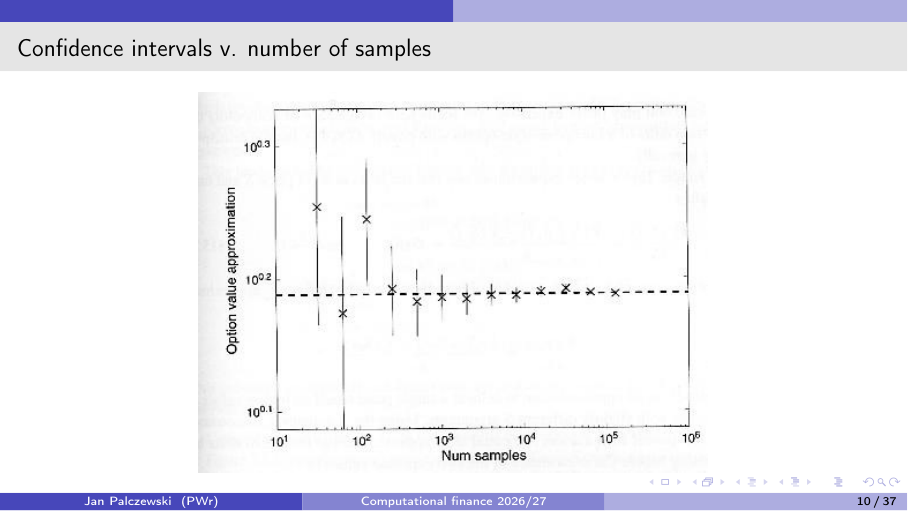
원본 슬라이드 p.10. 표본 수와 신뢰구간의 관계.
p.11 — Confidence Interval Scaling
몬테카를로 신뢰구간은 다음과 같은 구조를 갖는다.
신뢰구간의 길이는 표본 수의 제곱근에 반비례하고, ξ의 표준편차에는 정비례한다. 오차를 절반으로 줄이려면 같은 방식으로는 표본 수를 약 네 배 늘려야 한다. 따라서 계산량을 무작정 늘리는 것보다 분산을 낮추는 방법이 중요하다.
p.12 — Variance Reduction Techniques
강의는 세 가지 분산 감소 기법을 소개한다.
- Antithetic Variates(대조변량법)
- Control Variates(통제변량법)
- Importance Sampling(중요도 표본추출) — 이 강의에서는 자세히 다루지 않는다.
핵심은 원래 확률변수 ξ를 기댓값은 같고 분산이 더 작은 확률변수로 바꾸는 것이다.
p.13 — Antithetic Variates
ξ와 같은 평균·분산을 가지면서 ξ와 음의 상관관계를 가진 Y를 생각한다.
기댓값은 그대로 유지되지만 분산은
이 된다.
Proof — 분산이 감소하는 이유
분산의 합 공식에
Cov(ξ,Y)가 들어간다. Y와 ξ가 반대 방향으로 움직이면 이 항이 음수가 되어 두 관측값을 평균한 결과의 변동이 작아진다. 원래 분산과의 정확한 효율 비교에는 난수 생성·평가 횟수를 함께 고려해야 한다.
p.14 — On the Way to Find Y
만약 ξ의 기댓값이 0이라는 사실을 이미 알고 있다면 Y = −ξ로 정할 수 있다. 이때 Z = 0이므로 분산도 0이다. 하지만 우리가 알아내려는 것이 바로 기댓값이므로 기댓값을 미리 알아야 가능한 방법은 실제 계산에 쓸 수 없다.
중요한 힌트는 부호를 반대로 한 입력을 사용해 평균은 보존하고 상관관계는 음수로 만드는 구조다.
p.15 — Negative Covariance Lemma
γ를 확률변수, f를 단조증가 또는 단조감소 함수로 두면 적절한 이차 적률 조건 아래
가 성립한다. γ가 표준정규분포를 따르면 대칭성에 의해 γ와 −γ는 같은 분포를 가진다.
따라서 f(γ)와 f(−γ)는 같은 분포이고 기댓값도 같다.
Proof — 단조함수와 음의 공분산
γ와 독립인 복사본 γ′을 생각하자.
f(γ)−f(γ′)와f(−γ)−f(−γ′)는 f가 단조일 때 서로 반대 부호(또는 0)를 가진다. 독립 복사본을 사용한 공분산 항등식으로 두 함수의 공분산이 0 이하임을 보일 수 있다.
p.16 — Symmetric Pairing for an Option
ξ = f(γ)로 쓸 수 있을 때 반대쪽 난수 −γ를 짝지어
를 계산한다. f가 단조이면
이다. Black–Scholes 모형에서는 할인된 옵션 payoff를 다음 함수로 나타낼 수 있다.
여기서 h가 단조이면 f도 단조다. 유럽형 콜·풋의 payoff는 각각 단조증가·단조감소에 해당한다.
p.17 — Implementation: Antithetic Variates
입력: r, σ, S₀, T, M. 반복마다 표준정규 난수 x를 생성하고, x와 −x를 이용해 만기 주가 두 개를 만든다.
할인된 payoff 두 개의 평균을 한 표본으로 사용한다.
M회 반복 후 평균과 표본표준편차를 출력한다. 이 슬라이드는 Python이 아닌 알고리즘 설명이지만 아래에서 실제 코드로 구현한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import numpy as np

def antithetic_put(S0=4, K=5, sigma=0.3, r=0.04, T=1, M=10_000, seed=2026):
    rng = np.random.default_rng(seed)
    z = rng.standard_normal(M)
    drift = (r - 0.5 * sigma**2) * T
    up = S0 * np.exp(drift + sigma * np.sqrt(T) * z)
    down = S0 * np.exp(drift - sigma * np.sqrt(T) * z)
    discount = np.exp(-r * T)
    plus = discount * np.maximum(K - up, 0)
    minus = discount * np.maximum(K - down, 0)
    paired = 0.5 * (plus + minus)
    plain = plus
    for name, values in [('Plain MC', plain), ('Antithetic', paired)]:
        mean = values.mean()
        sd = values.std(ddof=1)
        se = sd / np.sqrt(M)
        print(name, 'mean=', round(mean, 6), 'SD=', round(sd, 6),
              '95% CI=', (round(mean-1.96*se,6), round(mean+1.96*se,6)))
    return plain, paired

plain, paired = antithetic_put()
p.18 — Example: European Put Option
강의의 입력값은 S₀ = 4, K = 5, σ = 0.3, r = 0.04, T = 1, M = 10,000이다. 슬라이드에 제시된 한 번의 실험 결과는 다음과 같다.
| 항목 | Plain MC | Antithetic Variates |
|---|---|---|
| 추정 평균 | 1.024211 | 1.019956 |
| 표본분산 | 0.700746 | 0.019493 |
| 표본표준편차 | 0.837105 | 0.139618 |
| 95% 신뢰구간 | [1.007804, 1.040618] | [1.017219, 1.022692] |
난수 시드와 구현 언어가 다르면 값이 같지는 않지만, 분산 감소 여부는 직접 확인할 수 있다.
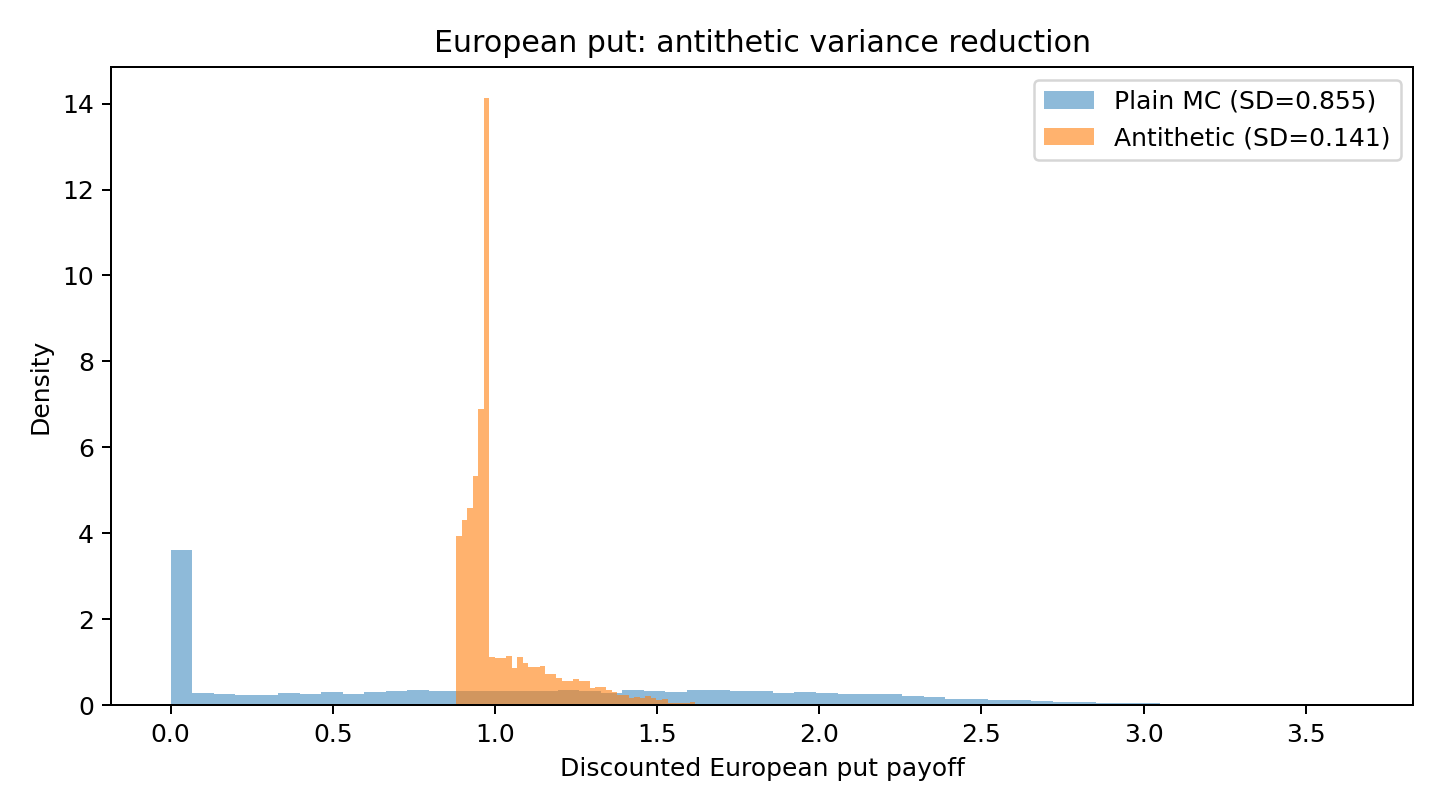
Python 재현 시각화. 동일한 표준정규 난수에 대해 Plain MC와 대조변량법으로 계산한 할인 payoff를 비교한 예시. 원본 슬라이드 그림과 별개로 생성했다.
p.19 — Original f(x)
원래 유럽형 풋 옵션의 할인 payoff 함수 f(z)를 나타낸 그래프다. 기초자산 가격이 오르면 풋 payoff는 감소하고, 행사가격보다 충분히 큰 구간에서는 0이다. 슬라이드의 분산은 약 0.70이다.
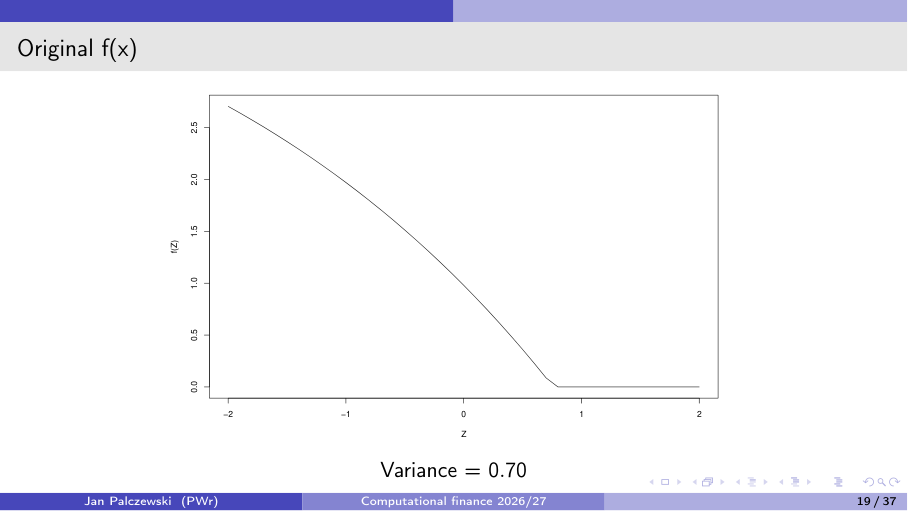
원본 슬라이드 p.19: Original f(x), Variance ≈ 0.70.
p.20 — Original f(x) and Antithetic f(x)
실선은 원래 함수, 점선은 f(z)와 f(−z)의 평균을 나타낸다. 대조변량법을 적용하면 함수의 변동폭이 줄어든다. 슬라이드에 표시된 분산은 실선 0.70, 점선 0.02다.
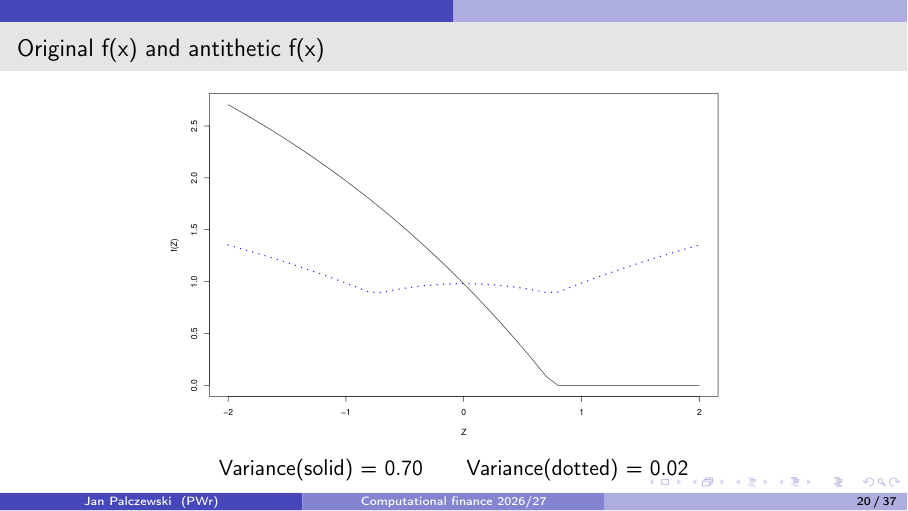
원본 슬라이드 p.20: 분산 감소를 함수 모양으로 비교.
p.21 — Control Variates
기댓값 E[Y]를 알고 있고, ξ와 비슷한 움직임을 보이는 확률변수 Y를 찾는다. 그러면 새로운 변수
를 만들 수 있다. 기댓값을 취하면
이므로 원래 구하려던 값은 보존된다. ξ와 Y가 함께 움직이면 ξ−Y의 변동폭이 작아질 수 있다. 이 Y를 Control Variate(통제변량)라고 한다.
p.22 — What Makes a Good Control Variate?
통제변량이 유익하려면 다음 조건이 필요하다.
문제는 Y의 선택이 일반적으로 명확하지 않다는 점이다. 평가 대상과 경제적으로 비슷한 구조를 가지면서 기댓값(가격)을 알고 있는 상품을 찾는 것이 좋은 출발점이다.
p.23 — Programming Comments
Control Variates 구현에서 가장 중요한 것은 코드로 계산한 Y의 평균과 공식에 넣는 E[Y]가 실제로 일치하는지 검증하는 것이다. 강의는 특히 다음 문제를 경고한다.
- Y의 계산 자체가 잘못 구현된 경우
- 이론 공식에는 반영되지 않은 시간 이산화·근사 오차가 Y 계산에 들어간 경우
- 잘못된 E[Y]를 사용해 오히려 편향이 생기는 경우
실습 점검
같은 경로·같은 시점·같은 할인 규칙으로 통제변량을 만들어야 한다. 표본으로 계산한 Y에 대응하지 않는 이론적 평균을 넣으면 분산을 줄이더라도 추정량의 평균이 잘못될 수 있다.
p.24 — Example: Average Asian Option
아시안 옵션의 만기 payoff는 기초자산 가격의 일정 기간 평균에 의존한다. 산술평균 S_avg를 사용할 때 콜·풋의 payoff는 각각
이다. 여기서 x의 양의 부분은 max(x,0)을 의미한다. 평균에 의존하므로 아시안 옵션은 경로의존적(path-dependent) 파생상품이다.
p.25 — Arithmetic vs. Geometric Asian Options
관측 시점이 0 ≤ t₀ < t₁ < ··· < tₙ ≤ T일 때, 산술평균 콜 payoff는
이고, 기하평균 콜 payoff는
이다. 이산 관측된 산술평균 아시안 콜은 기본 Black–Scholes 모형에서도 일반적으로 단순한 해석 가격식이 없지만, 기하평균 아시안 콜은 닫힌 형태의 가격식을 갖는다. 두 payoff는 비슷하게 움직일 수 있으므로 기하평균 옵션이 유용한 통제변량 후보가 된다.
p.26 — Asian Options and the Lognormal Theorem
관측 시점이 균등한 간격이라면
로 놓는다. 기하평균 G의 로그는 위험중립측도에서 정규분포를 따른다.
이유는 Black–Scholes 모형에서 각 log S_(t_i)가 정규 확률과정의 값이고, 로그 기하평균은 이 값들의 산술평균이기 때문이다.
Proof — 기하평균의 로그분포
log G = (1/(n+1)) Σ log S(t_i)를 쓰고, 각 로그주가를log S0 + (r−σ²/2)t_i + σW(t_i)로 표현한다. 등간격 합에서 시간의 평균은 T/2이고, Brownian motion의 공분산Cov(W(s),W(t)) = min(s,t)를 합산하면 표시된 분산을 얻는다.
p.27 — Price of Geometric Average Asian Option
기하평균 G가 로그정규분포를 따르므로 기하평균 아시안 콜의 가격은 로그정규분포의 부분 기댓값으로 직접 계산할 수 있다.
여기서 아래처럼 정의하면 강의의 b₁, b₂와 일치한다.
Φ는 표준정규 누적분포함수다. 강의 p.27의 식을 보다 간결한 동치 형태로 정리한 것이다.
p.28 — Implementation: Control Variate for Asian Calls
산술평균 아시안 콜의 가격을 추정할 때, 동일한 시뮬레이션 경로에서 기하평균 아시안 콜 payoff도 계산한다. 원문 의사코드에서 P는 p.27의 기하평균 옵션 해석가격이다.
이 변수 V_i의 평균을 구하면 산술평균 아시안 콜 가격을 추정할 수 있다. 다음은 p.28 알고리즘의 Python 구현이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
import numpy as np
from math import erf, sqrt, log, exp

def normal_cdf(x):
    return 0.5 * (1 + erf(x / sqrt(2)))

def geometric_asian_call_price(S0, K, r, sigma, T, n):
    mu = log(S0) + 0.5 * (r - 0.5 * sigma**2) * T
    v = sigma**2 * T * (2*n + 1) / (6*(n + 1))
    d1 = (mu - log(K) + v) / sqrt(v)
    d2 = d1 - sqrt(v)
    return exp(-r*T) * (exp(mu + v/2) * normal_cdf(d1) - K * normal_cdf(d2))

def asian_control_variate(S0=100, K=100, r=0.04,
                           sigma=0.3, T=1, n=24, M=10_000, seed=2026):
    rng = np.random.default_rng(seed)
    dt = T/n
    shocks = rng.standard_normal((M, n))
    increments = (r - 0.5*sigma**2)*dt + sigma*np.sqrt(dt)*shocks
    log_paths = np.column_stack([
        np.full(M, np.log(S0)),
        np.log(S0) + np.cumsum(increments, axis=1)
    ])
    paths = np.exp(log_paths)
    arithmetic = paths.mean(axis=1)
    geometric = np.exp(log_paths.mean(axis=1))
    disc = np.exp(-r*T)
    A = disc * np.maximum(arithmetic-K, 0)
    G = disc * np.maximum(geometric-K, 0)
    P = geometric_asian_call_price(S0, K, r, sigma, T, n)
    CV = A - (G-P)
    for label, samples in [('Plain MC', A), ('Control Variate', CV)]:
        mean = samples.mean()
        se = samples.std(ddof=1) / np.sqrt(M)
        print(label, 'price=', round(mean, 5),
              '95% CI=', (round(mean-1.96*se,5), round(mean+1.96*se,5)))
    return A, CV

plain_asian, cv_asian = asian_control_variate()
p.29 — Numerical Example: M = 10,000
원문의 실제 계산 결과는 아래와 같다. 두 방식 모두 표본 수는 10,000개다.
| 항목 | Control Variate | Plain Monte Carlo |
|---|---|---|
| payoff 표준편차 | 0.255346 | 6.0897 |
| 99% 신뢰구간 | [4.04609, 4.05048] | [3.95807, 4.05729] |
| 계산 시간 | 5.277초 | 5.226초 |
통제변량법의 신뢰구간 폭은 Plain Monte Carlo보다 약 23배 작다. 같은 정확도를 표본 수 증가만으로 얻으려면 대략 23² = 529배의 반복이 필요하므로 계산 시간이 크게 늘어난다. 강의는 약 2,765초(46분)라는 비교치를 제시한다.
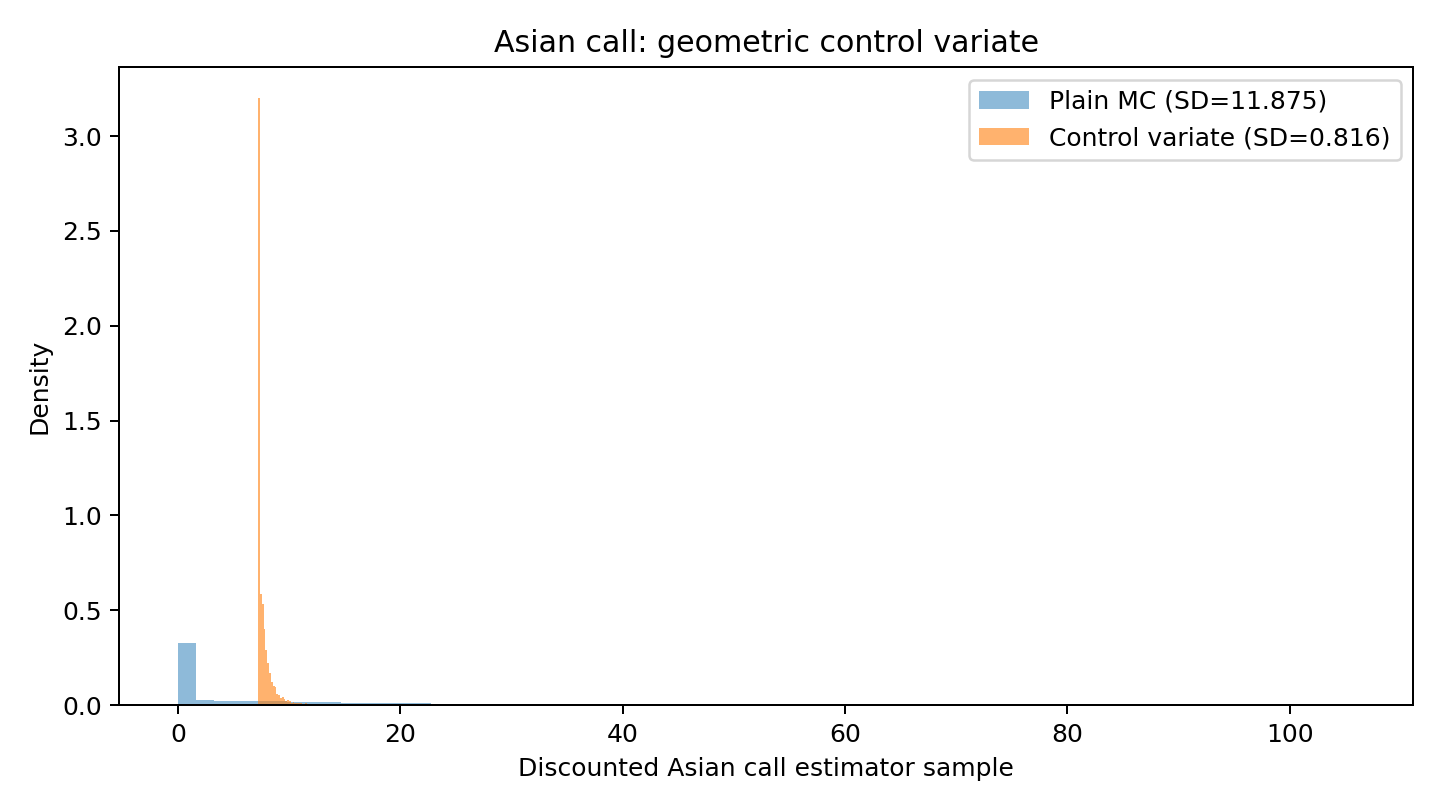
별도 Python 실습 예시: 산술평균 아시안 옵션의 Plain MC와 기하평균 통제변량 결과 비교. 슬라이드의 숫자는 강의에서 사용한 다른 실험 설정일 수 있으므로 이 그림과 직접 일치하지 않는다.
p.30 — Fine-tuning Control Variate Technique
통제변량 Y 앞에 실수 계수 θ를 추가하면
가 된다. θ의 값과 관계없이 E[Z_θ] = E[ξ]이지만, 분산은 θ에 따라 변한다.
θ에 관한 이차함수이므로 분산을 최소로 만드는 최적 계수를 찾을 수 있다.
p.31 — Testing of CV Estimator
Plain Monte Carlo와 CV estimator가 같은 기댓값을 추정하는지 검증하는 두 방법을 소개한다.
- Independent runs: 서로 독립된 난수로 실행하고 p.7의 두 결과 z-score를 사용한다.
- Common random numbers: 두 계산에서 난수를 공유한다. 이 경우 두 추정값의 차이는 상관되어 있으므로 해당 차이의 분산을 직접 평가해야 한다.
같은 난수를 사용하는 것은 비교의 잡음을 줄이는 데 유용할 수 있지만, 독립 실행용 분산 공식을 그대로 사용하면 안 된다.
p.32 — Optimal θ and Two-step Monte Carlo
p.30의 분산을 θ로 미분해서 0으로 두면
을 얻는다(Var(Y) > 0). 분산 감소가 일어나는 θ의 범위는 θ_min의 부호에 따라 달라진다.
- θ_min > 0이면 0 < θ < 2θ_min
- θ_min < 0이면 2θ_min < θ < 0
실제로 Cov(ξ,Y)를 모르면 두 단계 시뮬레이션을 수행한다. 적은 표본으로 θ를 추정한 다음, 더 큰 독립 표본으로 최종 가격을 계산한다.
Proof — 최적 계수
p.30의 분산식은 θ에 대한 볼록한 이차함수다. 미분식
−2Cov(ξ,Y)+2θVar(Y)=0을 풀면 최적 계수가 나온다. 추정한 θ가 표본에 의존할 때는 표본 재사용 여부가 편향 및 표준오차 계산에 영향을 줄 수 있으므로, 독립적인 pilot sample을 사용하는 방식이 명확하다.
p.33 — Example: European Call Option
입력값은 S₀ = 4, K = 5, σ = 0.3, r = 0.04, T = 1, M = 10,000이다. 강의는 만기 payoff가 S_T − K_f인 선도계약을 통제변량으로 사용한다.
할인된 콜 payoff를 ξ라 할 때 통제된 함수는
다. 강의의 그래프에서는 이를 입력 난수 또는 만기주가에 대한 함수로 표현한다.
p.34 — Crude Control Variate: θ = 1
θ = 1을 사용한 단순 통제변량의 그래프다. 원래 payoff의 분산은 약 0.79, 통제된 payoff의 분산은 약 0.28로 표시된다.
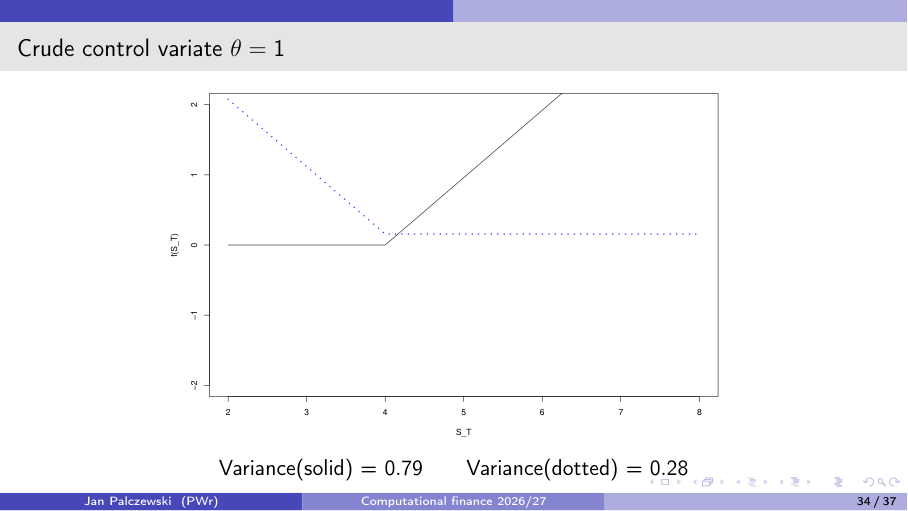
원본 슬라이드 p.34. 실선: 원래 payoff, 점선: θ = 1 통제변량.
p.35 — Fine-tuned Control Variate: θ = 0.66
θ를 0.66으로 조정하면 슬라이드에서 통제된 payoff의 분산이 약 0.11로 더 낮아진다. 단순히 통제변량을 뺀다고 끝나는 것이 아니라 어느 정도 뺄지 최적화할 수 있다는 사실을 보여준다.
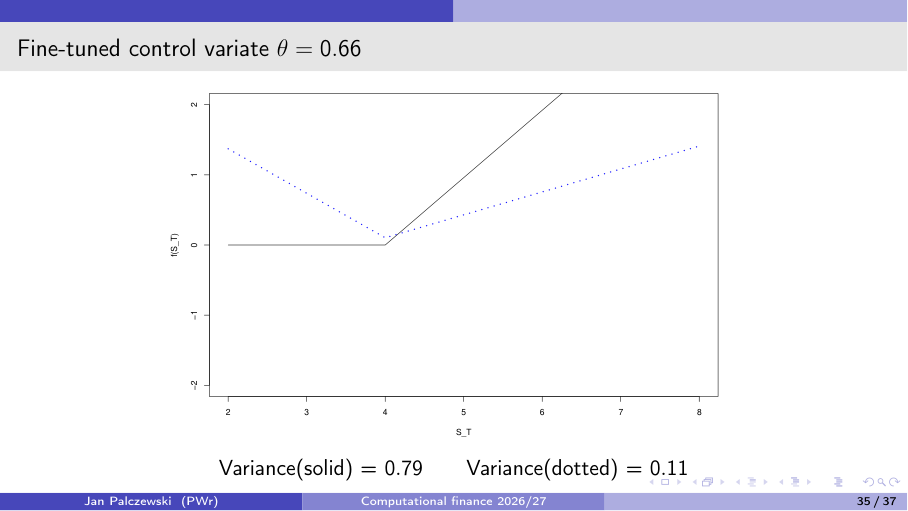
원본 슬라이드 p.35. 실선 분산 0.79, 점선 분산 0.11.
p.36 — Original f(z) and θ × Control Variate
이 페이지는 원래 콜 payoff와 통제변량 성분을 별도로 그려 보여준다. 통제변량은 원래 payoff와 공통적으로 움직이는 부분을 상쇄하도록 설계된다. 이 그림에 적힌 Variance = 0.79는 원래 함수의 분산이다.
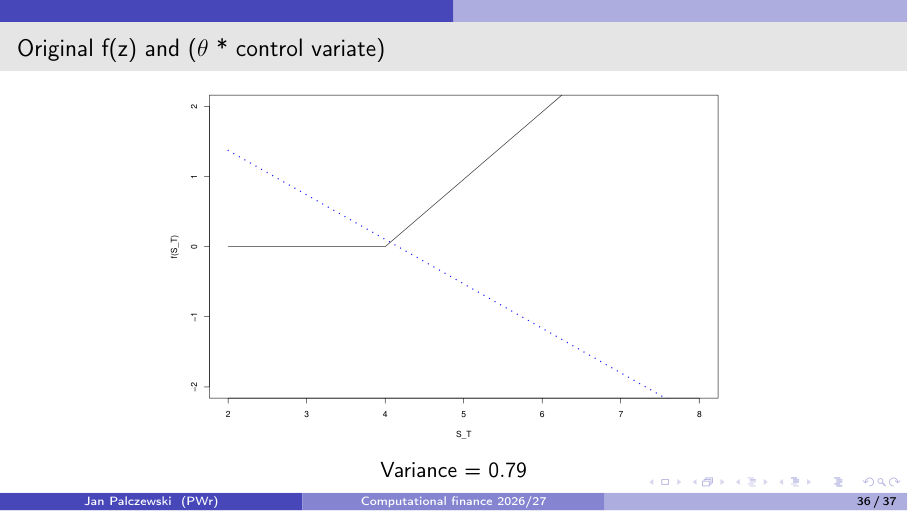
원본 슬라이드 p.36. 원래 함수와 통제변량 성분의 비교.
p.37 — Further Applications and References
통제변량법은 특히 다음 계산에 유용하다.
- 표준 옵션의 조합과 비슷한 비정형 payoff의 가격결정
- 아시안 옵션 같은 경로의존적 옵션의 가격결정
- 확률적 변동성(stochastic volatility) 등 더 복잡한 모형의 옵션 평가
강의에서 추천하는 참고문헌은 다음과 같다.
- Boyle, P., Broadie, M., & Glasserman, P. (1997). Monte Carlo methods for security pricing. Journal of Economic Dynamics and Control, 21.
- Glasserman, P. (2004). Monte Carlo Methods in Financial Engineering. Springer.
정확한 Monte Carlo는 분산 관리에서 시작한다
Monte Carlo는 표본평균으로 기댓값을 근사하지만, 그 숫자가 얼마나 믿을 만한지는 표준오차와 신뢰구간으로 설명해야 한다. 같은 반복 횟수라도 어떤 확률변수를 평균하느냐에 따라 정확도가 달라진다. Antithetic Variates는 반대 방향으로 움직이는 난수 쌍을, Control Variates는 기댓값을 알고 있는 유사한 상품을 활용한다. 실제 파생상품 가격결정에서는 계산 시간을 늘리기 전에 이러한 분산 감소 구조를 검토할 가치가 있다.
자료 출처
Jan Palczewski, Computational finance 2026/27 — Monte Carlo, Politechnika Wrocławska, pp. 1–37. 이 글은 개인 학습을 위해 슬라이드 순서대로 번역·해설한 자료이며, 포함된 원본 슬라이드 이미지는 출처를 명시했다. Python 코드와 Python 결과 그림은 추가 학습용 재현 예제다.