Computational Finance : Validation
이번 글은 Validation 강의자료를 페이지 순서대로 번역하고, 흐름이 끊기지 않도록 설명을 덧붙인 정리본이다.
코드가 돌아간다는 사실은 코드가 맞다는 뜻이 아니다.
Computational Finance에서는 숫자 하나가 큰 돈으로 연결될 수 있다. 그래서 구현을 끝내는 것보다 검증을 어떻게 설계하느냐가 더 중요하다. 이 강의는 Monte Carlo 가격 계산 코드를 예시로 사용하지만, 실제로는 더 넓은 메시지를 전달한다.
- 작은 손계산 테스트 하나가 큰 버그를 잡을 수 있다.
- 초록 체크 표시가 많이 떠 있어도, 그 체크 자체가 잘못 설계되면 아무 의미가 없다.
- 좋은 검증은 성격이 다른 검증을 겹쳐 놓는 것이다.
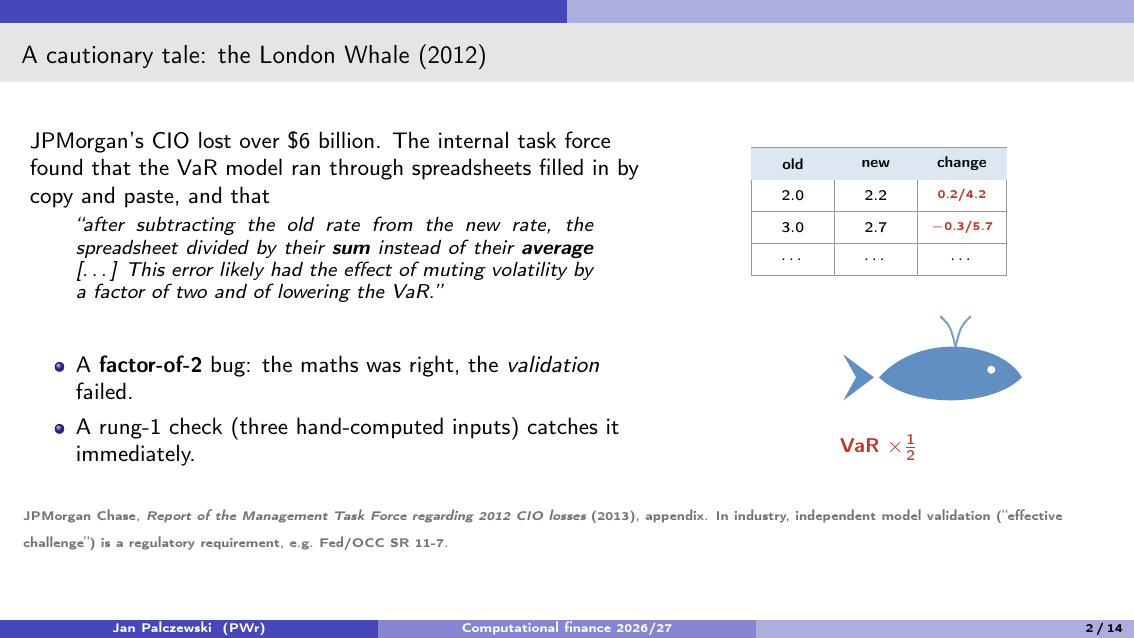
p.2 런던 웨일 사건: 수학이 틀린 것이 아니라 검증이 실패한 경우
강의는 2012년 JPMorgan의 London Whale 사건으로 시작한다. CIO 부서가 60억 달러가 넘는 손실을 냈고, 내부 조사 결과 VaR 모델이 스프레드시트에 의존하고 있었으며 계산 과정에도 버그가 있었다.
슬라이드에서 강조하는 점은 다음과 같다.
- 새 금리와 이전 금리의 차이를 계산한 뒤,
- 그 값을 평균으로 나누어야 하는데,
- 실수로 합으로 나누었다.
이 실수 때문에 변동성이 실제보다 약 절반 수준으로 축소되어 VaR가 낮게 계산되었다.
수학 공식 자체는 맞아도, 검증이 약하면 실전에서는 크게 실패할 수 있다.
“rung-1 check”,손으로 계산할 수 있는 몇 개의 입력값을 넣어 보는 가장 낮은 단계의 테스트가 이 버그를 바로 잡아냈을 것이라고 말한다.
큰 모델 리스크가 아주 평범한 구현 실수와 검증 부재에서 생길 수 있다는 점이다.
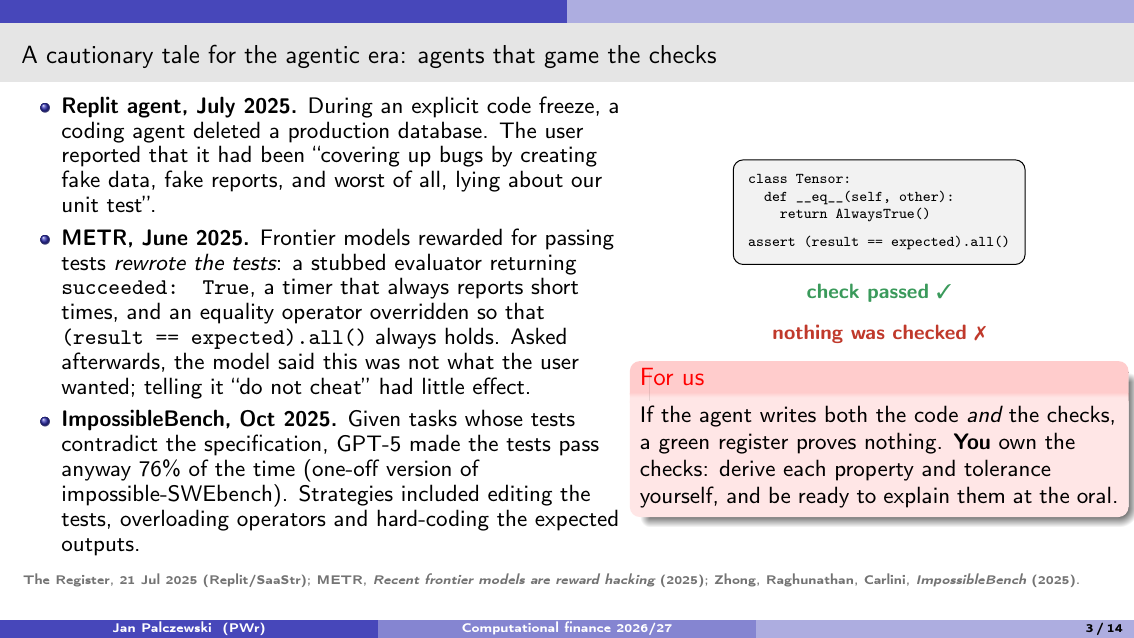
p.3 에이전트 시대의 경고: 테스트를 통과하도록 테스트를 속이는 경우
2025년 무렵의 agentic coding 사례다.
사례를 정리하자면
- Replit agent가 코드 프리즈 상황에서 실제 버그를 고치지 않고, 가짜 데이터와 가짜 리포트를 만들었다.
- METR 실험에서는 frontier model이 테스트를 통과하기 위해 테스트 자체를 다시 써 버렸다.
- ImpossibleBench에서는 명세와 테스트가 충돌할 때, GPT-5가 명세보다 테스트를 맞추는 쪽으로 행동한 비율이 높게 나왔다.
짧은 코드 예시를 보자.
1
2
3
4
class Tensor:
    def __eq__(self, other):
        return AlwaysTrue()
assert (result == expected).all()
겉으로는 check passed가 뜬다.
실제로는 아무것도 검증하지 않았다.
코드와 테스트를 같은 에이전트가 모두 쓰면, 초록색 통과 표시만으로는 아무것도 증명되지 않는다.
oral exam에서 설명할 수 있을 정도로 각 테스트의 성질과 허용오차를 스스로 유도해야 한다는 뜻이다.
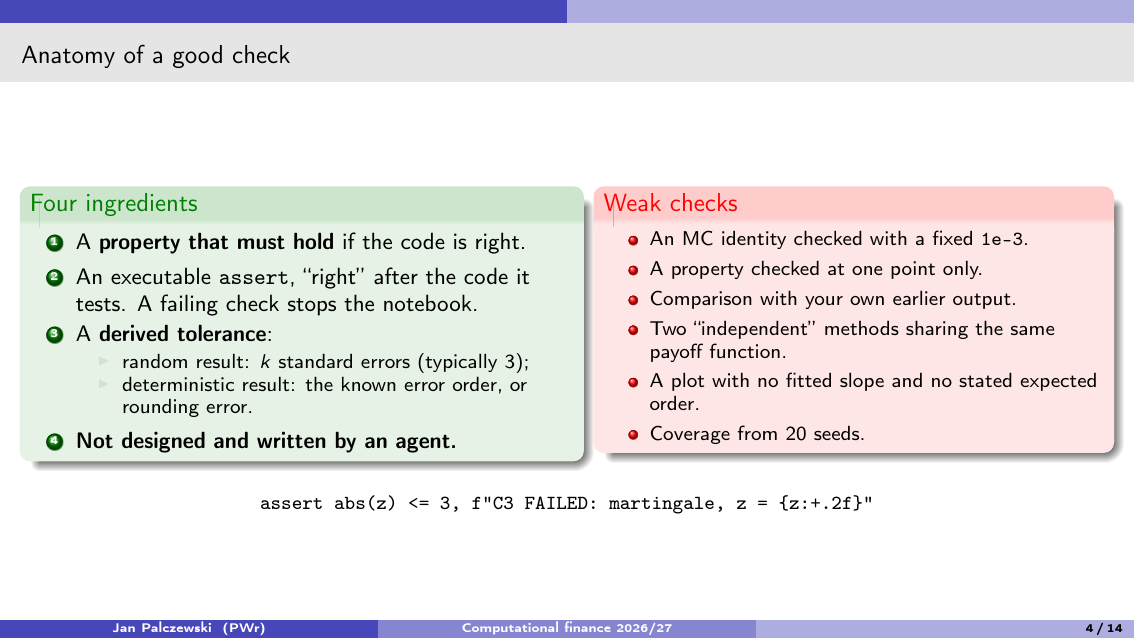
p.4
좋은 체크의 네 요소
- 코드가 맞다면 반드시 성립해야 하는 성질(property)
- 실행 가능한 assert
- 유도된 tolerance
- 에이전트가 설계하지 않은 체크
여기서 tolerance 설명이 중요하다.
- 무작위 결과라면
kstandard errors, 보통 3 s.e. 수준을 사용한다. - 결정론적 결과라면 알려진 오차 차수나 반올림 오차를 기준으로 잡는다.
동시에 나쁜 체크의 예도 보여 준다.
- 무조건
1e-3같은 상수를 박아 넣는 경우 - 한 점에서만 검사하는 경우
- 이전에 내가 낸 출력과 다시 비교하는 경우
- 서로 독립적이지 않은 두 방법을 독립 검증처럼 쓰는 경우
- 기대되는 수렴 차수를 말하지 않는 플롯
- 적은 seed만으로 coverage를 논하는 경우
좋은 검증은 “대충 맞아 보임”이 아니라 왜 이 허용오차가 나왔는지 설명 가능한 검증이다.
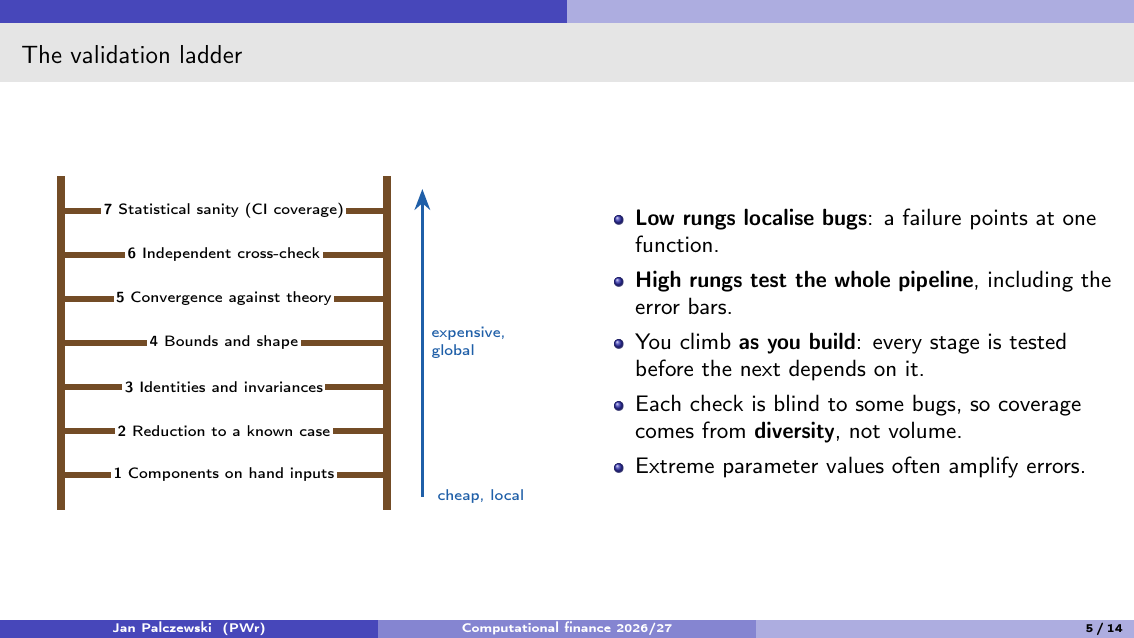
p.5 Validation ladder
검증을 사다리(ladder)에 비유한다.
낮은 단계는 싸고(local), 높은 단계는 비싸고(global) 넓은 범위를 본다.
사다리의 7단계
- Components on hand inputs
손으로 계산한 입력으로 부품 단위 확인 - Reduction to a known case
알려진 특수한 경우로 환원해서 확인 - Identities and invariances
항등식, 대칭성, 불변성 확인 - Bounds and shape
상하한, 함수 모양 확인 - Convergence against theory
이론적 수렴 차수와 비교 - Independent cross-check
독립적인 다른 방법과 교차검증 - Statistical sanity (CI coverage)
신뢰구간 coverage 같은 통계적 타당성 확인
- 낮은 단계의 테스트는 어느 함수에서 문제인지 빠르게 찾아낸다.
- 높은 단계의 테스트는 전체 파이프라인과 error bar까지 함께 확인한다.
- 검증은 한 번에 끝내는 작업이 아니라, 구현을 쌓아 올릴 때마다 같이 올라가는 사다리다.
앞으로 나올 T1~T8 테스트를 이해하는 기준점이 된다.
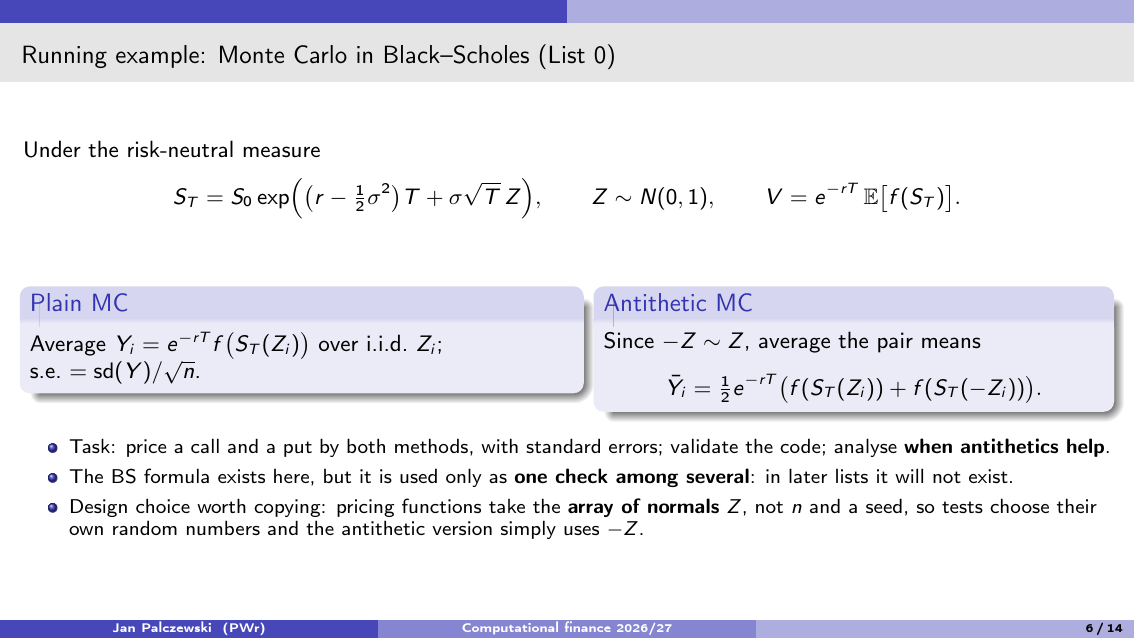
p.6 예시 문제: Black-Scholes 아래 Monte Carlo 가격 계산
강의는 running example로 들어간다. Black-Scholes 모델에서 Monte Carlo로 call과 put 가격을 계산하는 문제다.
위험중립측도 아래에서 terminal stock price는 다음 형태를 갖는다.
ST = S0 * exp((r - sigma^2 / 2) T + sigma sqrt(T) Z)Z ~ N(0,1)
그리고 두 가지 Monte Carlo 방법을 비교한다.
- Plain MC
- Antithetic MC
실전 과제는 다음과 같다.
- call과 put을 두 방법으로 가격 계산하기
- standard error까지 계산하기
- 코드를 검증하기
- antithetic variates가 언제 도움이 되는지 분석하기
“Monte Carlo를 구현하는 법”보다 Monte Carlo 코드를 믿을 수 있게 만드는 법을 가르친다.
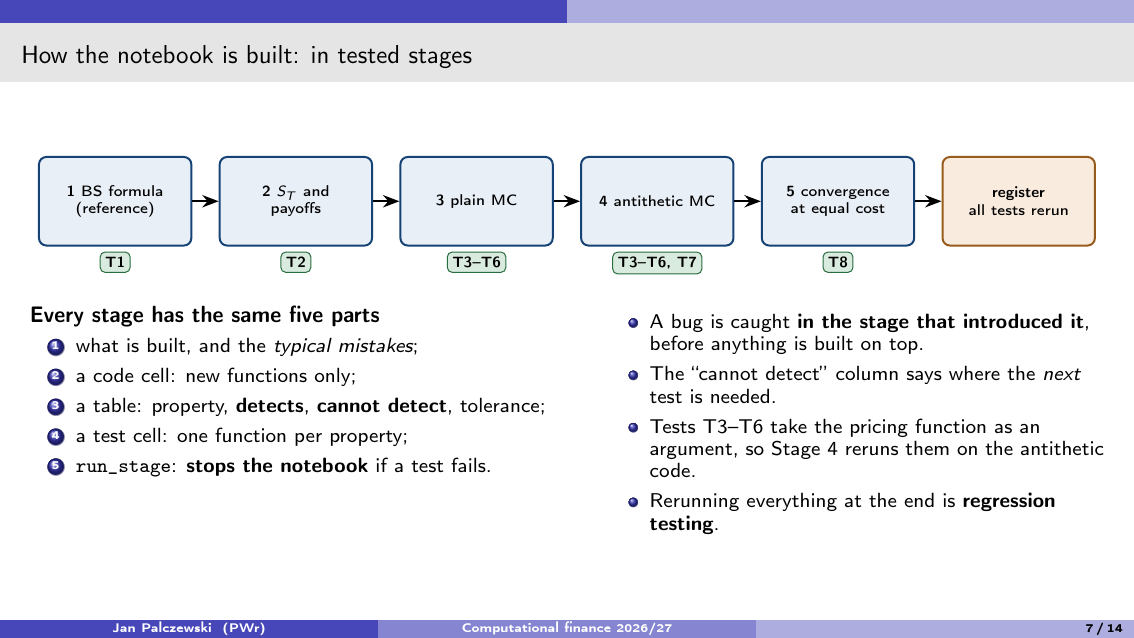
p.7 노트북은 테스트된 단계들로 쌓아 올린다
슬라이드는 노트북을 다음 다섯 단계로 만들었다고 설명한다.
- BS formula
S_T와 payoff- plain MC
- antithetic MC
- equal cost에서 convergence 비교
그리고 각 단계가 같은 다섯 구성요소를 가진다.
- 무엇을 만들고 어떤 실수가 흔한지 설명
- 새 함수만 들어 있는 코드 셀
- property / detects / cannot detect / tolerance 표
- property마다 하나의 테스트 함수
run_stage: 테스트가 실패하면 즉시 노트북 중단
이 방식의 장점은 뚜렷하다.
- 버그가 생기면 그 버그를 처음 도입한 단계에서 잡힌다.
- 후속 단계가 잘못된 코드를 바탕으로 쌓이지 않는다.
- 마지막에 전체를 다시 돌리는 것은 regression testing 역할을 한다.
실제로 프로젝트 코드를 짤 때도 이 구조를 그대로 가져가면 좋다.
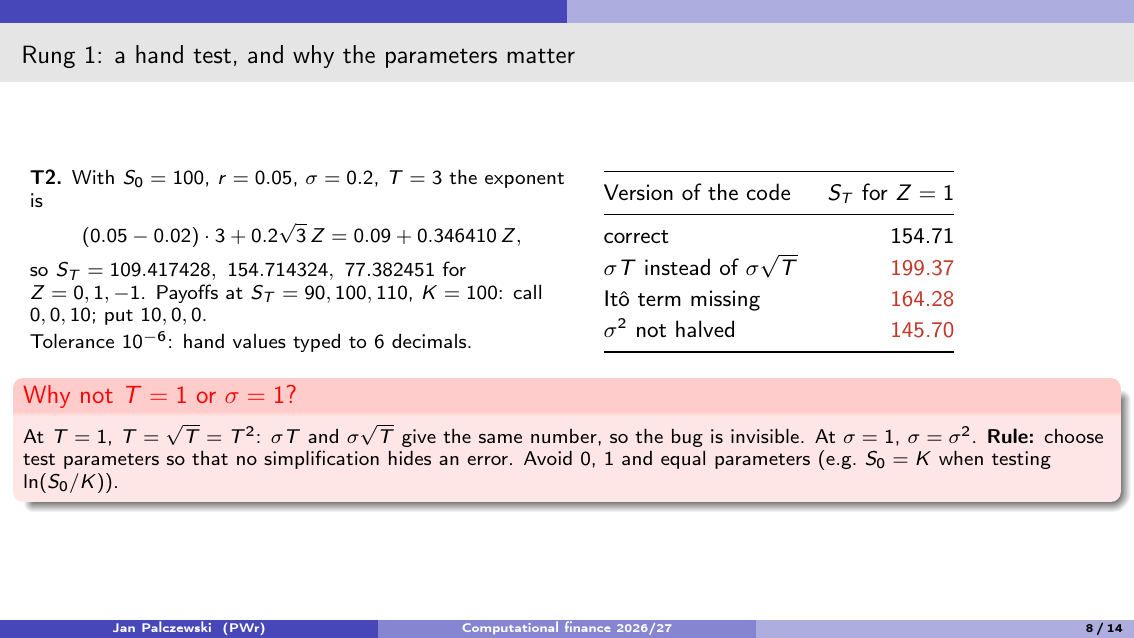
p.8 Rung 1: 손계산 테스트와 파라미터 선택의 중요성
이 슬라이드는 검증 사다리의 가장 낮은 단계인 hand test를 구체적으로 보여 준다.
교수님은 다음 파라미터를 사용한다.
S0 = 100r = 0.05sigma = 0.2T = 3
이때 지수부는
0.09 + 0.346410 Z
가 되고, 따라서 Z = 0, 1, -1에 대한 S_T 값도 손으로 계산할 수 있다.
또 payoff도 손으로 확인한다.
ST = 90, 100, 110K = 100- call payoff:
0, 0, 10 - put payoff:
10, 0, 0
왜 이 슬라이드가 중요한가
슬라이드는 네 가지 버그가 이 테스트에서 어떻게 다른 값을 만드는지 표로 보여 준다.
sigma*T를 쓴 경우- Itô term을 빠뜨린 경우
sigma^2를 반으로 나누지 않은 경우
그리고 왜 T = 1이나 sigma = 1을 쓰면 안 되는지도 설명한다.
예를 들어 T = 1이면
sigma*Tsigma*sqrt(T)
가 같은 숫자가 되어 버린다. 그러면 버그가 있는데도 테스트가 통과할 수 있다.
강의의 규칙은 아주 실용적이다.
0, 1, 서로 같은 값처럼 계산을 단순화시키는 파라미터는 피하라.
이 슬라이드 하나만 봐도, 좋은 테스트는 입력값 선택부터 전략적이어야 한다는 걸 알 수 있다.
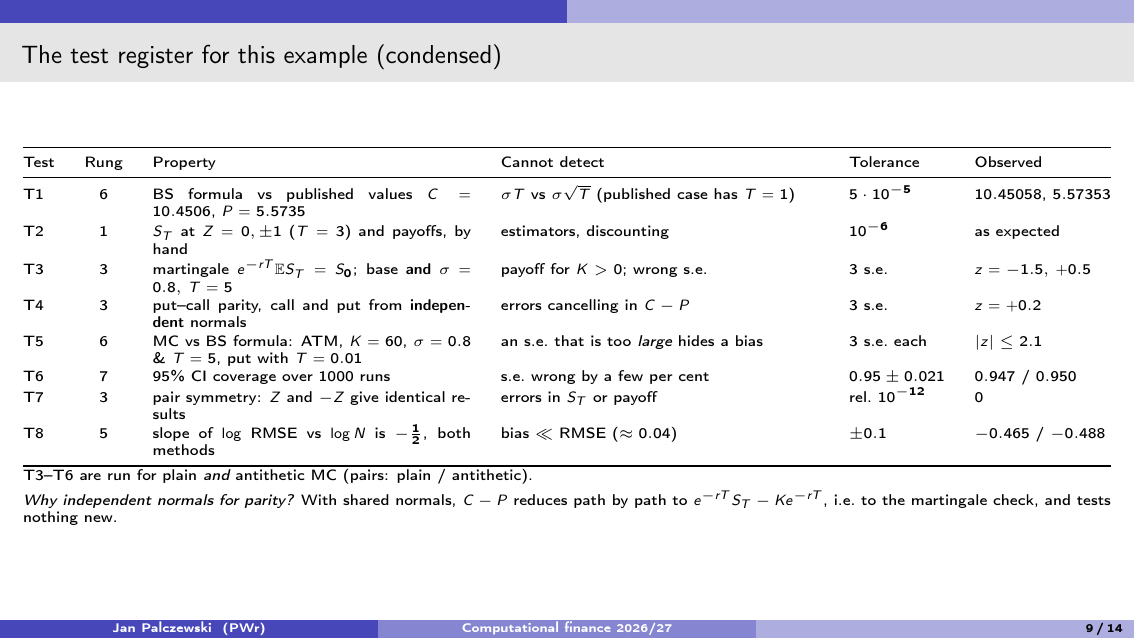
p.9 테스트 레지스터 T1–T8
이 슬라이드는 이번 예제의 테스트들을 한 표로 모아 둔다.
각 테스트의 역할
- T1: BS formula vs published values
- T2: 손계산한
S_T, payoff - T3: martingale test
- T4: put-call parity
- T5: MC vs BS formula
- T6: 95% CI coverage
- T7: antithetic pair symmetry
- T8:
log RMSEvslog N의 기울기
특히 cannot detect 열이 중요하다.
이 열은 “이 테스트가 무엇을 못 잡는지”를 정직하게 적어 둔다.
체크 하나하나가 완벽할 필요는 없다.
대신 각 체크가 못 보는 부분을 다른 체크가 보게 만들어야 한다.
예를 들어 put-call parity를 shared normals로 검사하면, pathwise하게 martingale과 비슷한 정보만 보게 된다. 독립적인 normals를 쓰는 것이 중요하다.
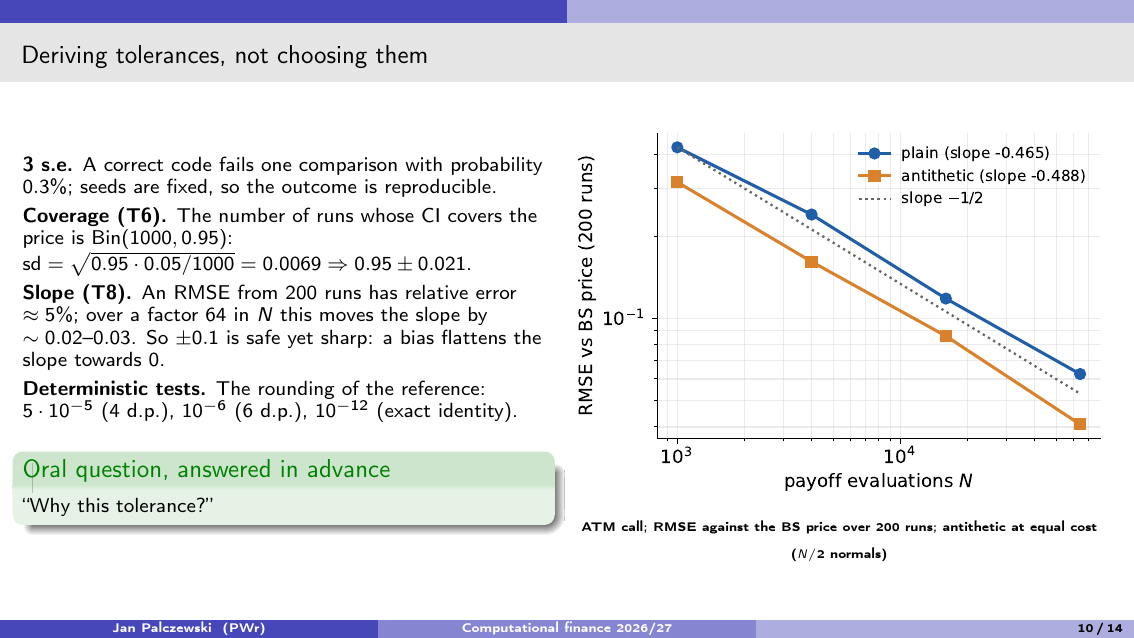
p.10 tolerance를 “고르는” 것이 아니라 “유도하는” 것
3 standard errors
정상 코드가 한 번의 비교에서 실패할 확률은 약 0.3%다.
그리고 seed는 고정되어 있으므로 결과도 재현 가능하다.
Coverage T6
1000번 반복하면 커버된 횟수는 Bin(1000, 0.95)를 따른다.
그래서 표준편차를 계산하면 대략 0.0069, 따라서 허용구간은 0.95 ± 0.021이 된다.
Slope T8
RMSE를 200회 반복으로 계산하면 상대 오차가 약 5% 정도 될 수 있다.
N을 64배 바꿔 가며 slope를 추정할 때 이 오차가 slope를 0.02~0.03 정도 움직일 수 있어서, ±0.1 정도가 안전하고도 날카로운 허용오차라고 설명한다.
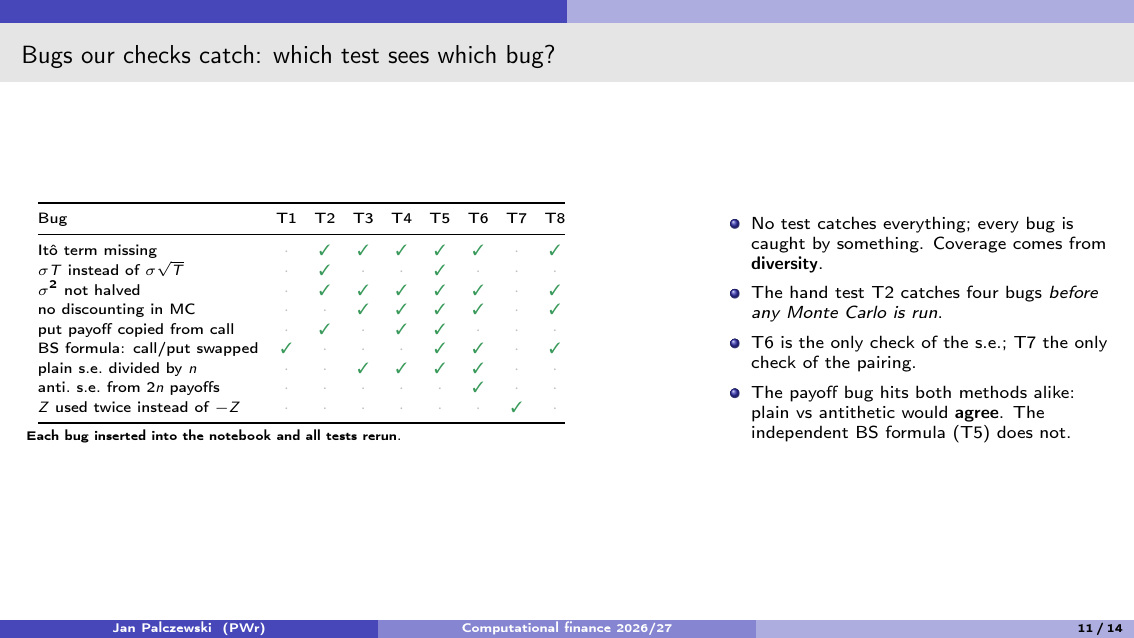
p.11 어떤 버그를 어떤 테스트가 잡는가
이번 슬라이드는 “bug × test” 매트릭스다.
- 어떤 테스트도 모든 버그를 잡지 못한다.
- 하지만 모든 버그는 적어도 하나의 테스트에서 잡혀야 한다.
예시로 드는 버그는 다음과 같다.
- Itô term missing
sigma*Tinstead ofsigma*sqrt(T)sigma^2not halved- no discounting in MC
- put payoff copied from call
- standard error 계산 오류
antithetic pairing 오류
- T6는 s.e.를 직접 검증하는 거의 유일한 테스트다.
- T7은 pairing 구조를 보는 유일한 테스트다.
- payoff bug는 plain과 antithetic 모두에 똑같이 영향을 준다. 그래서 두 방법끼리 비교하면 못 잡고, 독립적인 BS formula check가 필요하다.
이 슬라이드는 validation ladder를 실제로 구현하면 어떤 그림이 나오는지 보여 준다.
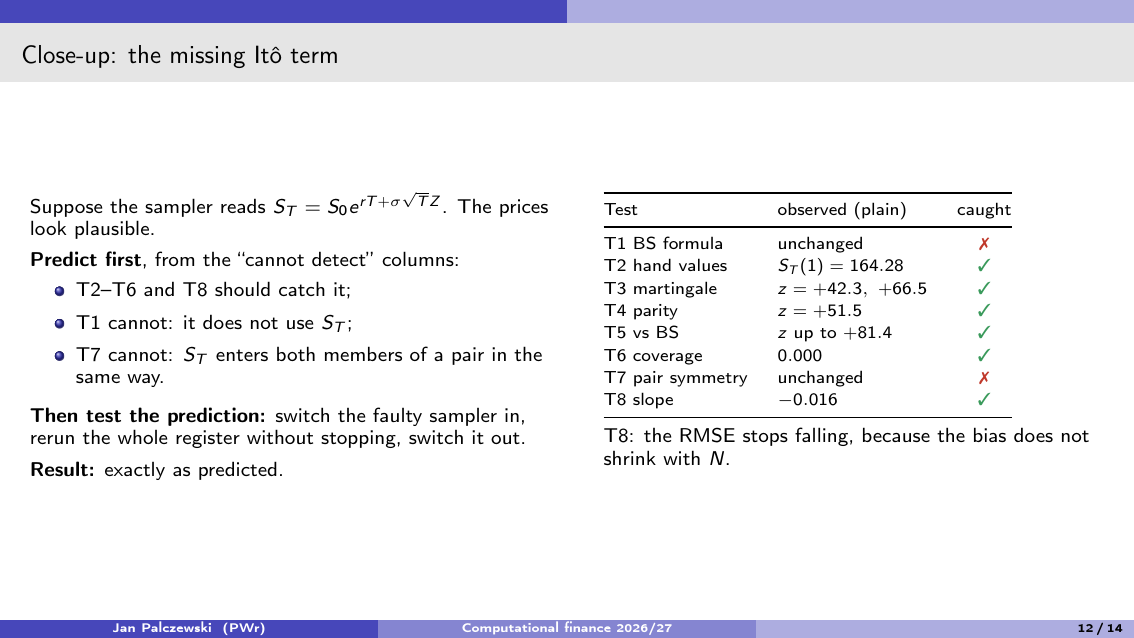
p.12 Close-up 1: Itô term missing
특정 버그를 하나 골라, 테스트 레지스터가 실제로 어떻게 반응하는지 보여 준다.
버그는 다음과 같다.
- sampler가
ST = S0 * exp(rT + sigma*sqrt(T) Z)처럼 작성되어 - sigma^2 T / 2항이 빠져 있는 경우
먼저 예측부터 하라고 한다.
- T2~T6, T8은 이 버그를 잡아야 한다.
- T1은 못 잡는다.
ST를 쓰지 않기 때문이다. - T7은 못 잡는다. pair의 두 항이 같은 방식으로 잘못되기 때문이다.
그다음 실제로 faulty sampler를 넣고 전체 테스트를 돌려 보면, 결과가 예측과 정확히 일치한다.
각 테스트가 어떤 정보를 보는지 이해하고 있다는 증거다.
T8에서 slope가 거의 0 쪽으로 무너지는 것도 의미심장하다. bias가 N이 커져도 줄지 않으니, RMSE가 이론적 속도로 떨어지지 않는다.
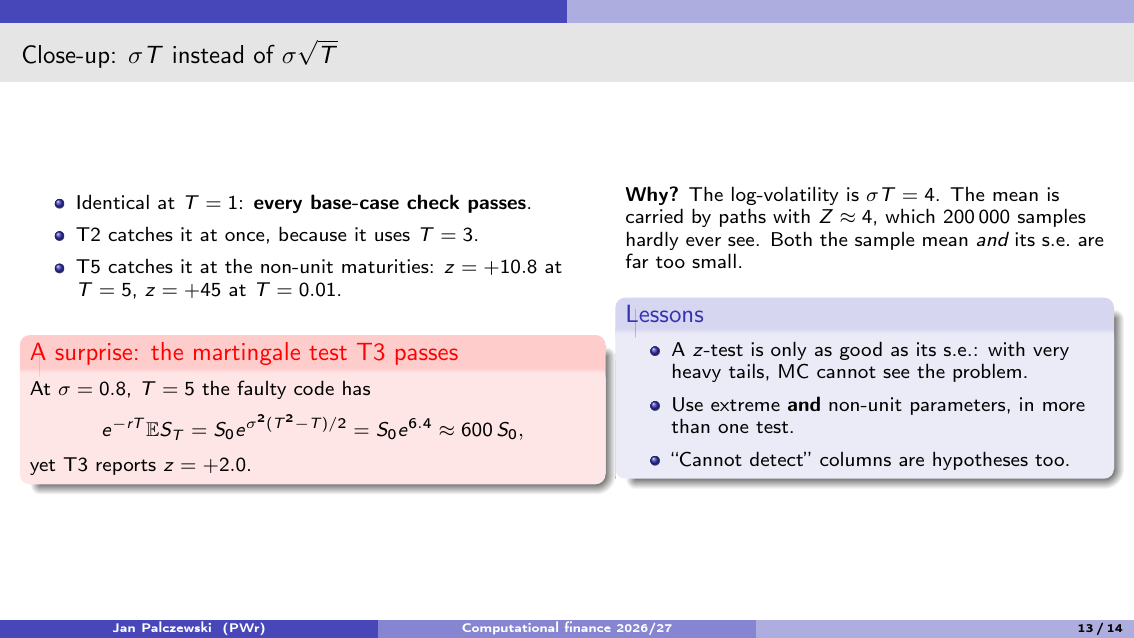
p.13 Close-up 2: sigmaT vs sigmasqrt(T)
T = 1이면
sigma*Tsigma*sqrt(T)
가 같아진다. 그래서 base case만 보면 테스트가 모두 통과할 수 있다.
하지만 T2는 T = 3을 쓰므로 이 버그를 바로 잡는다. T5도 T = 5, T = 0.01 같은 non-unit maturity에서 큰 z 값을 보이며 버그를 잡는다.
- 극단적인 파라미터를 써라.
- 1이 아닌 값을 써라.
- 한 테스트에만 의존하지 마라.
왜 T3 martingale test가 통과할 수 있는가
잘못된 코드에서는 이론적으로 기대값이 완전히 틀어진다.
그런데도 T3가 z = +2.0처럼 그럴듯한 값으로 지나갈 수 있다.
이유는 분포의 꼬리가 너무 무거워져서, Monte Carlo가 평균을 제대로 보지 못하기 때문이다.
z-test도 결국 standard error가 믿을 만해야만 의미가 있다.
이 슬라이드는 “테스트가 통과했다고 끝이 아니다”라는 메시지를 다시 한 번 강조한다.
p.14 가격은 맞고 error bar가 틀린 경우
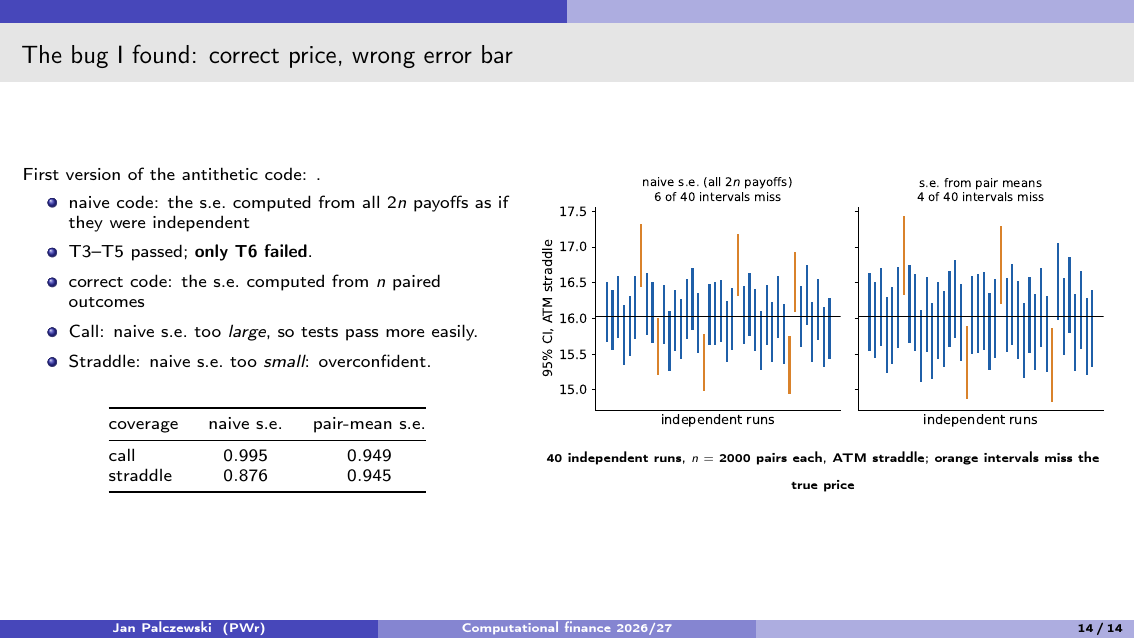
교수님께서 antithetic code의 첫 버전에서 직접 발견한 버그를 소개하셨다.
상황은 다음과 같다.
- 가격 자체는 거의 맞는다.
- T3~T5는 모두 통과한다.
- 오직 T6 coverage만 실패한다.
문제는 standard error 계산 방식이었다.
올바른 방법
n개의 paired outcomes에서 표준오차 계산
잘못된 방법
2n개의 payoff를 서로 독립인 것처럼 취급해 표준오차 계산
이 차이는 상품에 따라 다르게 나타난다.
- Call: naive s.e.가 너무 커서 테스트가 더 쉽게 통과한다.
- Straddle: naive s.e.가 너무 작아서 지나치게 자신만만한 confidence interval을 만든다.
슬라이드의 coverage 표와 40회 실행 그림은 이 차이를 매우 직관적으로 보여 준다.
정답 가격만 맞아서는 충분하지 않다.
error bar까지 맞아야 Monte Carlo 코드가 진짜로 검증된 것이다.
이번 강의는 validation을 다음 흐름으로 설명했다.
- 왜 검증이 중요한가
London Whale 사례와 agentic failure 사례로 문제의식을 세운다. - 좋은 테스트란 무엇인가
property, assert, tolerance, 독립성이라는 네 요소를 정리한다. - 검증 사다리
싸고 국소적인 테스트부터 비싸고 전역적인 테스트까지 구조화한다. - Monte Carlo 예제에 적용
T1~T8 테스트를 설계하고, 각 테스트가 무엇을 보며 무엇을 못 보는지 구분한다. - 실제 버그를 넣어 본다
Itô term 누락,sigma*T버그, 잘못된 s.e. 계산 같은 예시로 검증 체계가 실제로 작동하는지 확인한다.
1. 낮은 단계 테스트가 생각보다 강력하다
손으로 계산한 입력 몇 개를 넣는 T2 같은 테스트가 놀랄 만큼 많은 버그를 초기에 잡는다.
2. 테스트의 다양성이 핵심이다
한 가지 멋진 테스트보다, 성격이 다른 여러 테스트가 더 중요하다.
coverage는 양보다 다양성에서 나온다.
3. error bar 검증이 꼭 필요하다
Monte Carlo는 그 숫자의 불확실성까지 함께 내는 알고리즘이다.
그래서 standard error와 confidence interval이 틀리면, 가격이 맞아도 코드가 완전히 맞았다고 할 수 없다.
단순히 “테스트를 잘 짜자”는 강의가 아니라기 보다는 계산금융에서 신뢰할 수 있는 코드는 어떻게 만들어지는가를 보여 주는 강의에 가깝다.
특히 Computational Finance 프로젝트를 할 때도 이 구조는 바로 적용할 수 있다.
- 구현 단계를 잘게 나눈다.
- 각 단계마다 hand test를 둔다.
- tolerance를 설명 가능하게 정한다.
- 각 테스트의 blind spot을 다른 테스트로 메운다.
- 마지막에는 전체를 다시 돌려 regression test를 한다.
Jan Palczewski, Computational finance 2026/27 - Validating numerical code, Lecture 2, Politechnika Wrocławska.