Optimal Nonparametric Estimation of the Expected Shortfall Risk 1
금융에서 중요한 것은 아주 안 좋은 상황에서 손실이 얼마나 큰지를 파악하는 것이다. 이때 사용하는 대표적인 위험 측도가 Expected Shortfall이다.
그런데 우리는 실제 손실의 확률분포를 모르기 때문에 과거 데이터로 ES를 추정해야 한다. 가장 자연스러운 방법인 plug-in estimator는 데이터에 극단적인 손실값이 포함될 때 추정값이 크게 흔들릴 수 있다. 이 논문은 이런 문제를 해결하기 위한 새로운 강건 추정량을 제안하고, 데이터 개수가 유한할 때에도 얼마나 정확한지 수학적으로 보장한다.
Plug-in Estimator는 실제 확률분포를 알 수 없을 때, 관측된 데이터로 만든 Empirical Distribution를 대신 대입하여 통계량을 추정하는 방법이다.
예를 들어, 금융시장에서 최악의 10% 손실에 대한 평균인 ES(Expected Shortfall)를 추정한다고 하자.
이론적 ES: 실제 손실의 확률분포를 이용하여 계산
Plug-in ES: 과거 손실 데이터 100개를 크기순으로 정렬한 뒤, 손실이 가장 큰 10개의 평균을 계산
실제 확률분포를 모르기 때문에 관측된 표본 데이터를 이용해 ES를 추정하는 것이다.
다만, 극단적으로 큰 손실값(Outlier)이 하나라도 포함되면 상위 10개 손실의 평균이 크게 증가할 수 있다. 특히 금융 데이터처럼 극단적인 손실이 발생할 가능성이 상대적으로 높은 Heavy-tailed Distribution에서는 이러한 문제가 더욱 중요해진다.
따라서 이 논문은 기존 Plug-in Estimator의 한계를 개선하면서도 통계적으로 높은 정확도와 안정성을 확보할 수 있는 새로운 ES 추정 방법을 제안하게 되는데 “실제 데이터에 극단값이나 잘못된 관측치가 있더라도, ES를 안정적으로 추정할 방법이 없을까?”라는 질문으로 출발하게 된다.
Abstract
저자들은 유한한 개수의 i.i.d. 데이터로부터 금융 손실의 Expected Shortfall 위험을 추정하는 문제를 다룬다. 기존의 고전적인 plug-in estimator는 금융에서 흔히 사용하는 heavy-tailed 분포에 대해 통계적 성능이 좋지 않다는 점이 알려져 있다. 또한 이 방법은 강건하지 않아서 데이터 중 단 하나의 관측치만 바뀌어도 추정 결과가 크게 왜곡될 수 있다.
이 논문은 ES를 추정하는 새로운 절차를 제안한다. 저자들은 이 추정량이 최소한의 가정하에서 유한한 표본 크기에 대해, 중심극한정리가 암시하는 최선의 통계적 성능을 달성함을 증명한다. 또한 소수의 관측치가 악의적으로 변조되더라도 실제 ES를 최적으로 추정할 수 있는 adversarial robustness을 갖는다. 여러 손실분포를 사용한 수치실험에서도 기존 추정량보다 좋은 성능을 보인다.
- Nonparametric(비모수적): “손실이 반드시 정규분포를 따른다”처럼 특정 분포 형태를 미리 정하지 않고 추정한다는 뜻이다.
- Heavy tails(두꺼운 꼬리): 극단적으로 큰 손실이 상대적으로 자주 발생하는 분포를 뜻한다. 극단값 하나가 평균이나 ES를 크게 흔들 수 있다.
- Finite sample(유한 표본): N이 무한대로 커지는 이상적인 상황이 아니라, 실제로 N = 500 또는 N = 3,250처럼 데이터가 제한된 상황이다.
- Robust(강건한): 일부 관측치가 유별나게 크거나 변조되더라도 추정량이 심하게 흔들리지 않는 특성이다.
1. Introduction
ES와 VaR의 정의 (p. 1)
위험관리의 핵심 과제 중 하나는 금융 포지션에 내재한 위험 수준을 정확하게 수치화하는 것이다. 이를 위한 엄밀한 이론적 틀은 risk measure 이론이 제공한다. 실무에서 폭넓게 사용하는 위험 측도 중 하나가 Expected Shortfall(ES)이다.
확률변수 X를 금융 손실이라고 하자. 논문에서는 α ∈ (0, 1/2)에 대해 ES를 다음과 같이 정의한다.
여기서 VaR는 다음과 같다.
그러나 ES를 계산하려면 손실 X의 누적분포함수(CDF)
를 알아야 하는데, 현실에서 이 분포를 정확히 아는 경우는 드물다. 따라서 일반적으로 과거 관측값 X₁, …, Xₙ을 사용한다. 실제 금융 시계열에는 약한 상관관계가 있을 수 있지만, 이 논문에서는 ES 추정 관련 많은 연구의 표준적인 접근에 따라 독립·동일분포(i.i.d.)를 기본 가정으로 사용한다. 다만 제안한 틀은 약한 종속성을 가진 데이터에도 확장할 수 있으며, 이를 Section 6에서 다룬다.
VaR와 ES는 무엇이 다를까?
손실 X가 크다는 것은 나쁜 일이다. 예를 들어 α = 0.05이면:
- VaR₀.₉₅: 손실분포의 95% 분위수, 즉 손실이 이 값을 초과할 확률이 약 5%인 경계값.
- ES₀.₀₅: 가장 나쁜 상위 5% 손실구간의 분위수들을 평균한 위험 측도.
연속분포일 때는 ES를 흔히 “VaR를 넘어선 손실의 조건부 평균”이라고 이해할 수 있다. 다만 이산분포처럼 VaR 지점에 확률질량이 있으면 단순히 조건부 평균으로 쓰는 것은 항상 정확하지 않다. 그래서 논문은 분위수 적분 정의를 사용한다.
왜 1/α를 곱할까? [1−α, 1]의 구간 길이가 α이므로 적분한 값을 구간 길이로 나누어 평균을 계산하기 위해서다.
Ex: 100일간 손실 데이터를 작은 순서로 정렬한다고 하자. α = 0.05라면 상위 5개의 손실 평균이 ES의 직관적인 경험적 추정값이다. 실제로는 αN이 정수가 아닐 때 경계의 가중치를 조정해야 한다.
1.1. The plug-in estimator (p. 2–3)
관측값 X₁, …, Xₙ만으로 ES를 추정하는 가장 자연스러운 방법은 plug-in estimator다. ES는 X의 분포함수 F_X에 의해 결정되므로, 알 수 없는 F_X를 경험적 분포함수(empirical CDF) F̂_N으로 대체한다.
여기서 지시함수는 Xᵢ ≤ t이면 1, 아니면 0인 지시함수이다. 따라서 F̂_N(t)는 전체 데이터 중 t 이하인 값의 비율이다.
이 경험적 분포를 ES 공식에 그대로 대입하면
를 얻는다. 여기서 F̂_N의 역함수는 경험적 분위수 함수다.
논문의 궁극적 질문은 Plug-in 추정량이 실제 ES를 얼마나 잘 근사하는가이다.
Plug-in 추정량 자체가 표본에 따라 달라지는 확률변수이므로, 추정 오차에 대한 높은 신뢰수준의 확률적 상한을 구하고자 한다.
먼저 N이 무한대로 커질 때의 점근적(asymptotic) 거동을 분석한다. 이를 위해 ES 추정 문제에 관련된 분산을 다음과 같이 정의한다.
여기서 q = VaR₁₋α(X)이다.
이 값은 [0, ∞] 범위에서 정의되며, X의 양의 부분 X⁺ = max(X, 0)에 대한 제곱기댓값이 유한하다면 이 분산도 유한하다.
Theorem 1.1 — 중심극한정리
ES 관련 분산이 유한하고 분위수 함수가 u = 1−α에서 연속이면,
가 성립한다. 정규분포 N(0, σ²)는 평균이 0이고 분산이 σ²인 정규분포다.
논문에서는 이 연속성 가정이 실제로 필요한 조건이라고 강조한다. 분위수 함수가 해당 지점에서 불연속이라면 일반적으로 위 정규 극한이 성립하지 않는다(관련 논의: Remark 1.2, §3.2).
‘Plug-in’은 원래 식에서 모르는 분포를 데이터로 구한 분포로 바꿔 끼운다는 뜻이다.
중심극한정리의 요지는 N이 충분히 커지면 추정 오차의 전형적인 크기가 대략 1/√N 비율로 줄어든다는 것이다. 하지만 이것은 N이 유한할 때 항상 높은 확률로 작은 오차를 보장한다는 뜻은 아니다. 다음 §1.2가 바로 이 차이를 다룬다.
수식에서 주의할 점: 위에서 정의한 ES 관련 점근 분산은 원래 손실 X의 분산 Var(X)과 같지 않다. ES를 추정하는 과정과 연결된 점근 분산이다.
Python으로 확인해볼 지점 ①: 경험적 ES
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import numpy as np

def plugin_es(x, alpha=0.1):
    """논문의 분위수 적분 정의에 맞춘 경험적 ES (경계 가중치 포함)."""
    x = np.sort(np.asarray(x, dtype=float))[::-1]
    n = len(x)
    if n == 0 or not (0 < alpha < 1):
        raise ValueError("비어 있지 않은 데이터와 0 < alpha < 1이 필요합니다.")
    tail_count = alpha * n
    k = int(np.floor(tail_count))
    total = x[:k].sum()
    if k < n:
        total += (tail_count - k) * x[k]
    return total / tail_count

losses = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 30])
print(plugin_es(losses, alpha=0.2))  # 19.5
이 코드는 기존 plug-in 추정량만 구현한 것이다.
1.2. Finite sample performance of the plug-in estimator — 유한 표본에서의 성능 (원문 p. 3–5)
N이 무한대로 커지는 상황보다 실제로 더 중요한 질문은 데이터가 유한한 개수일 때 Plug-in 추정량의 오차가 어느 정도인가다.
신뢰수준 1−δ에 대해, 가능한 작으면서 다음을 만족하는 오차 한계 r = r(δ, N, X)를 찾고 싶다.
여기서 확률은 무작위 표본 X₁, …, Xₙ을 뽑는 과정에 대한 것이다. 점근 정규근사가 유한한 N에서도 정확하다고 지나치게 낙관적으로 가정하면 다음 식을 예상할 수 있다.
(1.1)
이는 오차 한계 r이 δ에 로그 형태로만 의존한다는 뜻이다. 같은 내용을 오차확률로 표현하면
(1.2)
그러나 저자들은 (1.1), (1.2)를 유한 표본에 일반적으로 적용하는 것은 잘못이라고 강조한다.
첫 번째 이유: 두꺼운 꼬리(Heavy Tails).
정규분포처럼 꼬리가 매우 가볍지 않다면 (1.2)와 같은 지수적 감소는 성립하지 않는다. 예컨대 유한한 분산을 갖도록 꼬리모수 λ > 2인 파레토 분포를 생각하면, 논문의 §4에서는
(1.3)
형태의 하한을 제시한다. λ가 2에 가까우면 우변은 거의 1/N 비율로 감소한다. 이는 지수적 감소와 매우 다르다.
더 일반적인 분포들에 대해 §3.1에서는 Plug-in 추정량의 오차확률이 최악의 경우 대략
보다 빠르게 줄어들기를 기대하기 어렵다고 설명한다. 이는 신뢰수준을 높일수록 오차 한계가 √(1/(δN)) 규모로 커질 수 있다는 뜻이다. 로그에만 의존하는 이상적인 한계보다 훨씬 불리하다.
두 번째 이유: 분위수 함수의 연속성 정도.
꼬리가 가볍더라도 문제는 남는다. Theorem 1.1은 충분히 큰 N에서
(1.4)
이라는 전형적 오차 규모를 설명하지만, 도대체 얼마만큼의 N부터 이 근사가 잘 작동하는지는 알려주지 않는다.
만약 분위수 함수가 L-Lipschitz 연속이고, 꼬리 영향을 분리해 생각하기 위해 X의 절댓값이 1 이하라고 가정해도, §3.2에서는 다음과 같은 추가적인 2차 오차항이 필요함을 보인다.
(1.5)
따라서 (1.4)와 같은 구간이 지배적이려면 대략 N ≳ L²/σ² 정도의 표본이 필요하다. 여기서 σ는 ES 추정 문제의 점근 표준편차다.
Remark 1.2 — 분위수 함수의 연속성
분위수 추정에서 분위수 함수의 연속성이 중요하다는 것은 알려져 있다. 특히 유한표본 분석에는 보통 분위수 함수의 Lipschitz 연속성이 사용된다. X에 양의 밀도함수 f_X가 있다면
이므로 VaR 분위수 주변에서 밀도 f_X가 너무 작지 않아야 분위수 함수가 급격하게 변하지 않는다. ES가 상위 꼬리 구간의 분위수 평균인 만큼, 분위수의 연속성 조건이 ES 추정에도 중요하다. 저자들은 이 2차 오차항의 역할이 이전 연구에서 충분히 명시적으로 다뤄지지 않았다고 지적한다.
이를 종합하면 Plug-in 추정량이 달성하길 바랄 수 있는 매우 낙관적인 형태는 다음과 같다.
(1.6)
하지만 plug-in 추정량에 대한 이 정도의 보장은 매우 가벼운 꼬리에서만 기대할 수 있고, 일반적인 금융 손실분포에서는 성능이 크게 악화될 수 있다.
여기서 가장 중요한 구분은 CLT는 ‘충분히 큰 표본에서의 극한’에 대한 이야기이고, 논문이 추구하는 것은 지금 가진 유한한 표본에서의 신뢰 가능한 보장이라는 점이다.
- δ: 실패확률. δ = 0.05이면 신뢰수준이 95%이고, δ = 0.01이면 99%이다.
- r: 그 신뢰수준을 확보하기 위해 허용하는 추정 오차의 한계.
- ε: ES 점근 표준편차의 몇 배 정도를 ‘큰 오차’로 볼지 정하는 척도.
- L: 분위수 함수가 얼마나 가파르게 변할 수 있는지 나타내는 Lipschitz 상수.
- O(·): 오차의 크기 차수를 표현하며 정확히 같은 값이라는 뜻은 아니다.
수능 모의고사를 아주 많이 반복했을 때 점수 평균이 안정된다는 말과, 지금 딱 10번의 시험 결과만으로도 평균 오차가 매우 작다고 보장하는 말은 다르다.
Python으로 확인해볼 지점 ②: 극단값 하나의 영향
1
2
3
4
5
6
7
8
9
10
import numpy as np

rng = np.random.default_rng(42)
x = rng.pareto(a=2.2, size=1000) + 1
before = plugin_es(x, alpha=0.1)

x[0] = 1_000_000
after = plugin_es(x, alpha=0.1)

print(f"변경 전: {before:.3f}, 변경 후: {after:.3f}")
이 실험은 plug-in의 민감성 예시이지, 논문의 확률적 하한 (1.3)을 수학적으로 검증하는 실험은 아니다. (1.3)을 확인하려면 각 N마다 수많은 반복실험을 해 오차확률을 추정해야 한다.
1.3. An improved estimator — 개선된 추정량 (원문 p. 5–9)
금융·보험 분야의 손실분포는 정규분포보다 꼬리가 두꺼운 경우가 많기 때문에, 기존 plug-in 추정량의 단점을 개선하기 위한 다양한 연구가 있었다. 하지만 저자들에 따르면 기존 연구는 주로 실험적 성능이나 점근적 성질에 집중했고, 유한 표본에서의 최적 통계적 보장이나 (1.5)의 2차항을 충분히 다루지 못했다.
이 논문은 분포의 꼬리가 얼마나 빨리 감소하는지와 관계없이, ES 관련 점근 분산이 유한하고 분위수 함수가 L-Lipschitz라는 조건 아래에서 (1.6) 수준의 오차확률 보장을 갖는 새로운 추정량을 구성한다.
Definition 1.3 — 논문에서 제안하는 추정량
먼저 바닥함수는 내림, 천장함수는 올림이다. 블록 크기 m, 블록 개수 n을
로 정한다. j = 1, …, n에 대해 겹치지 않는 블록을
로 정의한다. 즉 nm ≤ N이고, nm개 데이터를 n개 블록으로 나눈다. 마지막에 남는 N−nm개는 블록 구성에는 쓰지 않지만 전체 데이터 plug-in 추정량에는 포함된다.
각 블록에서도 동일하게 경험적 CDF와 ES 추정량을 계산한다.
그 다음 블록별 ES 추정값의 선형보간 경험적 분위수 Q̂(β)를 구한다. 논문은 하이퍼파라미터를
로 놓고 다음 추정량을 정의한다.
동일한 식을 더 쉽게 쓰면
전체 데이터의 plug-in 추정값을 블록 추정량들이 만든 구간 안으로 잘라 넣는(clipping/truncation) 방법이다.
논문의 알고리즘 순서는 다음과 같다.
- 블록 크기 m과 분위수 수준 β₁, β₂를 결정한다.
- 전체 표본 X₁, …, Xₙ으로 전체 plug-in 추정량을 계산한다.
- 표본을 크기 m의 겹치지 않는 블록으로 나눠 블록별 ES를 계산한다.
- 블록 추정값의 β₁, β₂ 경험적 분위수 Q̂(β₁), Q̂(β₂)를 구한다.
- 전체 plug-in 추정값을 그 구간 안으로 제한한 강건 추정량을 출력한다.
분위수 계산의 주의점: 원문의 각주 1은 n개 블록 추정값을 정렬하고, 위치 (j−1)/(n−1)에 j번째 정렬값을 대응시킨 뒤 선형보간하는 방식을 사용한다. 파이썬 np.quantile(..., method="linear")가 이 정의와 대응한다.
Theorem 1.4 — 제안 추정량의 오차 보장
어떤 양의 절대상수 c₀, c₁, c₂, c₃가 존재한다고 하자. ES 관련 분산이 유한하고, 분위수 함수가 [1−2α, 1−α/2]에서 L-Lipschitz이며, ε < c₀√α, N ≥ c₁ε⁻²이면
가 성립한다. 저자들은 이를 최적 통계적 성능이라고 설명한다. §3에서 제시하는 하한과 비교하면, 어떤 추정량도 본질적으로 더 좋은 오차·신뢰수준 관계를 일반적으로 보장할 수 없기 때문이다.
Remark 1.5에서 증명에 사용할 수 있는 상수의 한 예로 c₀ = 1/6, c₁ = 140, c₂ = 10, c₃ = 1/700을 제시한다. 다만 저자들은 이 상수들이 최선의 값은 아닐 것으로 본다. 블록 크기를 정할 때 사용하는 ‘11’도 실무에서 반드시 고수해야 하는 유일한 최적 숫자는 아니다.
Remark 1.6 — 이 추정량이 작동하는 직관
0.35 ≤ β₁ ≤ β₂ ≤ 0.65의 여러 선택이 이론적 보장에는 허용되지만, 실험적 편향(bias)에는 영향을 미친다. 블록별 plug-in 추정값은 오른쪽으로 치우치는 경향이 있으므로 β₁ = β₂ = 0.5 (블록 중앙값)을 택하면 음의 편향이 발생하기 쉽다. 반대로 충분히 큰 블록에서 β₁ = β₂ > 0.5를 택하면 양의 편향이 나타날 수 있다. 따라서 분포의 비대칭성 및 블록 크기 m을 고려해야 한다.
특히 β₁ < 0.5 < β₂이면 적응적 절단(adaptive truncation)으로 이해할 수 있다.
- 데이터에 특이한 값이 없다면 전체 plug-in 추정값이 분위수 구간 안에 있을 가능성이 높다. 이때 두 추정량이 같으므로 전체 데이터를 사용하는 장점을 살린다.
- 이상치 때문에 전체 plug-in 추정값이 구간을 벗어나면 양 끝 경계값으로 절단해 극단적인 오류를 방지한다.
- m이 작으면 블록 추정값의 변동이 커지는 대신 블록 수 n은 많아져 분위수 구간의 신뢰성이 좋아질 수 있다. 반대로 m이 커지면 블록 변동성이 줄지만 블록 수가 줄어든다.
Figure 1 — 기존 방법과 새 방법의 실제 비교 (원문 p. 8)
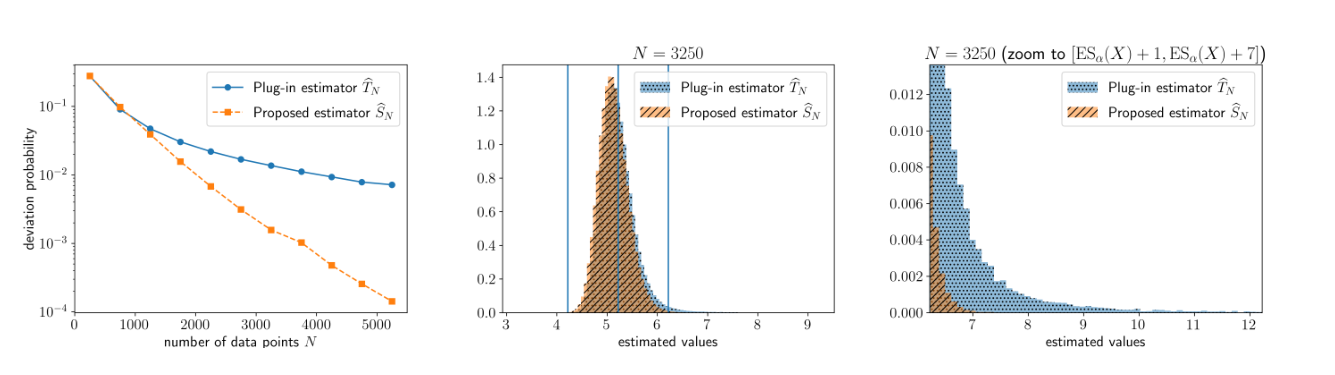
Bartl & Eckstein (2026), Figure 1, p. 8. arXiv:2405.00357v2.
이 그림은 Pareto 분포 λ = 2.2, α = 0.1, 제안 추정량의 설정 β₁ = 0.5, β₂ = 0.6, m = 250을 사용하며, 100만 회(10⁶) 반복실험 결과를 보여준다.
- 왼쪽: 데이터 개수 N이 증가할 때 추정 오차가 1 이상인 확률. 제안 추정량은 기존 plug-in보다 오차확률이 빠르게 줄어든다.
- 가운데: N = 3,250일 때 추정값의 히스토그램. 일반적인 범위에서는 두 추정량이 상당히 비슷하게 작동한다.
- 오른쪽: 극단적인 추정 오류의 꼬리 부분. 100만 번 중 오차가 1보다 큰 경우는 plug-in 13,637회, 제안 추정량 1,568회였다. 최대 관측 추정값도 각각 98.98, 7.83으로 매우 달랐다.
이 숫자는 해당 시뮬레이션 설정의 결과다. 모든 분포에서 항상 이 비율만큼 개선된다는 뜻은 아니다.
Corollary 1.7 — 2차항이 작을 때
추가로 ε ≤ σ/(c₂L)이면, 여기서 σ는 ES 관련 점근 표준편차다.
(1.7)
즉 ε이 충분히 작을 때는 Lε²인 2차항을 상대적으로 무시할 수 있고, 중심극한정리에서 기대했던 형태와 같은 차수의 오차 보장을 얻는다. §4에서 파레토 분포에 대해 이 조건을 더 분석한다.
분위수 함수의 국소 기울기와 Table 1
밀도함수 f_X가 있을 때 u = 1−α에서 분위수 함수의 국소 기울기는
이다. Theorem 1.4에서 쓰는 L은 보다 넓은 분위수 구간에서의 기울기 상한이고, 저자들은
로 설명한다. Table 1에서는 실무적인 비교를 위해 L 대신 D(α)를 보고한다.
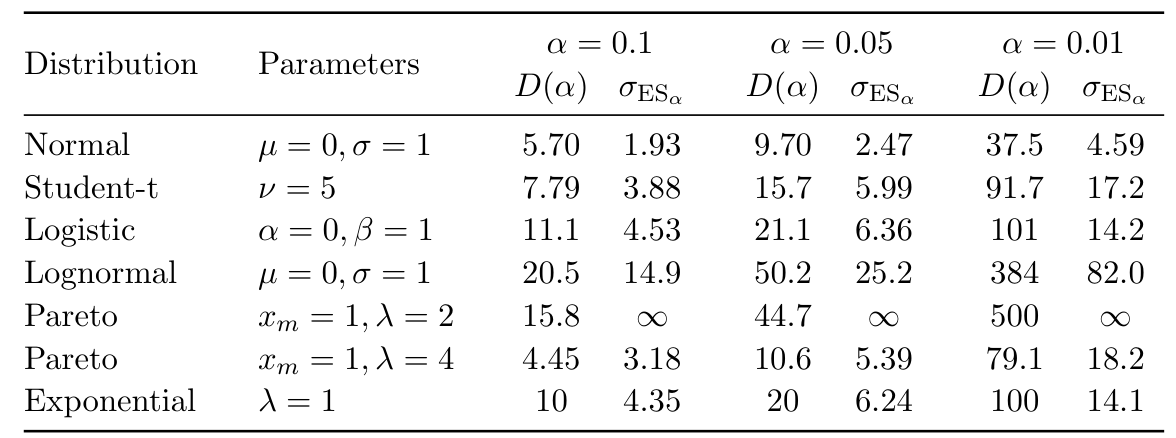
Bartl & Eckstein (2026), Table 1, p. 9. arXiv:2405.00357v2.
α가 0.1에서 0.01로 작아지면 더 극단적인 손실 꼬리를 추정하므로 D(α)와 ES 관련 점근 표준편차가 대체로 커진다. 특히 Pareto λ = 2의 점근 분산은 무한대다. 이 값들은 분포별 매개변수를 표에 적힌 대로 정한 계산 결과이므로 모든 경우에 동일하지 않다.
Python으로 확인해볼 지점 ③: 제안 추정량 구현
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import numpy as np

def robust_es(x, alpha=0.1, m=250, beta1=0.5, beta2=0.6):
    """Definition 1.3의 계산 절차. m은 실험용으로 직접 지정."""
    x = np.asarray(x, dtype=float)
    n = len(x) // m
    if n < 2:
        raise ValueError("분위수를 만들려면 최소 두 블록이 필요합니다.")
    if not (0.35 <= beta1 <= beta2 <= 0.65):
        raise ValueError("논문의 beta 범위를 벗어났습니다.")

    tn = plugin_es(x, alpha)
    blocks = x[:n*m].reshape(n, m)
    block_es = np.array([plugin_es(b, alpha) for b in blocks])
    q1, q2 = np.quantile(block_es, [beta1, beta2], method="linear")
    sn = np.clip(tn, q1, q2)

    return {
        "plugin": tn,
        "robust": sn,
        "lower": q1,
        "upper": q2,
        "block_es": block_es
    }

rng = np.random.default_rng(7)
x = rng.pareto(2.2, size=3250) + 1
print(robust_es(x))
여기서 m = 250은 Figure 1에 사용된 실험 설정이다. Theorem 1.4의 이론적 선택인 m = ⌈11/ε²⌉을 그대로 쓴 것이 아니라는 점을 구별해야 한다.
1.4. Adversarial robustness — 악의적 데이터 변조에도 강건한가? (원문 p. 9–10)
새로운 추정량 Ŝ_N의 또 다른 장점은 적대적 강건성(adversarial robustness)이다. 이는 실제 데이터와 추정 절차를 알고 있는 누군가가 일정 비율의 관측값을 임의로 바꾸더라도, 추정 성능에 대한 보장을 얻는다는 뜻이다.
반면 기존 plug-in 추정량은 원래 분포가 무엇이든 단 하나의 관측값 변경만으로도 결과가 크게 왜곡될 수 있다.
Theorem 1.8 — 변조된 데이터가 있을 때의 보장
Theorem 1.4의 조건이 성립한다고 하자. 어떤 양의 상수 C₀, C₁, C₂가 존재하여 전체 N개 중 최대 C₀Nε²개가 악의적으로 변조되더라도
가 성립한다. 증명에서는 C₀ = 1/140, C₁ = 10, C₂ = 1/2800을 사용할 수 있지만, 이 상수들이 최적이라고 주장하지는 않는다.
당연히 데이터 대부분 또는 전부가 변조되면 어떤 추정 방법으로도 원래의 ES를 만족스럽게 복구할 수 없다. 변조된 관측치 수를 K라고 하면 논문은 K ≤ C₀Nε²를 요구한다. 따라서
이라는 제약이 발생한다. §3.4에서는 변조 비율과 관련된 이 오차 규모가 minimax 관점에서 최적임을 보인다.
이상치(outlier)와 적대적 변조(adversarial corruption)는 다르다. 이상치는 실제로 일어난 극단적 손실일 수도 있지만, 적대적 변조는 데이터의 일부를 누군가 의도적으로, 심지어 알고리즘을 아는 상태에서 바꾸는 더 강한 조건이다.
이 논문의 강건성은 허용되는 변조 수 K와 오차확률을 수학적으로 연결한다는 데 의미가 있다.
추가로 같은 난수로 만든 데이터에서 (a) 변조 없음, (b) 큰 손실값 1개 삽입, (c) 큰 손실값 3개 삽입의 세 경우를 비교하여 두 추정량의 변화를 그래프로 나타낼 수 있다. 논문의 Figure 6이 이 아이디어를 더 정교하게 실험한다.
1.5. Related literature — 관련 선행연구 (원문 p. 10)
ES 추정은 금융 규제와 이론적 관심에 의해 오래 연구된 주제다. 기존 연구들은 i.i.d. 상황에서 비모수적 ES 추정, 확률적 변동성·시계열 종속성·두꺼운 꼬리를 고려한 추정, 극단값 이론 기반 방법, backtesting, 추정 오차 및 유한 표본의 불확실성 등을 다뤄 왔다.
이 논문의 방법과 가까운 선행 방법은 β₁ = β₂ = 1/2일 때 얻어지는 median of blocks estimator다. 이 경우
이다. 평균 추정에서 유명한 median-of-means와 비슷한 생각을 ES에 적용한 셈이다. 평균 추정에서는 이런 추정량의 성능이 잘 알려져 있지만, 저자들에 따르면 ES 추정에 대해 통계적으로 최적인 유한 표본 보장은 이전 문헌에서 충분히 마련되지 않았다.
또한 저자들은 추정량의 안정성과 적대적 강건성에 관한 연구들을 연결한다. 일부 데이터가 잘못 측정되거나 조작되더라도 안정적인 추정 결과를 보장한다는 점은, 데이터가 많아져 모든 관측치의 품질을 확인하기 어려운 상황에서 중요하다. 적대적 강건성은 데이터분포의 전체변동(total variation) 변화에 대한 안정성으로도 이해할 수 있으며, 드문 구조적 변화(structural break)에 대한 안정성 관점에서도 해석할 수 있다.
여기서 median of blocks와 제안 추정량을 혼동하지 않는 것이 중요하다.
- Median of blocks: 블록별 ES 추정값의 중앙값을 최종 결과로 사용.
- Proposed estimator: 전체 표본의 ES 추정값을 우선 사용하고, 블록 분위수로 정한 구간을 벗어날 때만 잘라냄.
전체 데이터의 효율성과 블록 기반 방식의 강건성을 동시에 활용하려는 절충안이다.
1.6. Extensions (원문 p. 11–12)
저자들은 자신들이 제안한 추정량이 통계적으로 최적이지만, 실무에서 유용한 추정 방법을 만들려면 추가로 고려할 문제가 있다고 강조한다.
첫째, 실제 금융에서는 α = 0.01처럼 매우 작은 꼬리 비율을 다루면서 N = 250 정도의 많지 않고 상호 독립적이지도 않은 관측값만 얻을 수 있다. 이 경우 상위 1%에 해당하는 데이터는 약 2.5개, 즉 대략 2~3개뿐이다. 이렇게 극단 구간 데이터가 적으면 순수 비모수 추정량은 충분한 정보를 얻기 어렵다.
둘째, i.i.d. 가정을 완화하는 현실적인 방향으로 mixing 조건을 적용할 수 있다. 저자들은 약하게 종속된 데이터에서도 제안 방법이 가치 있을 것으로 예상하고, §6에서 한 가지 접근을 제시한다.
셋째, 블록 분할 방법은 비모수 부트스트랩 등 재표본추출(resampling)과 연결해서 생각할 수 있다. 다만 일반적인 부트스트랩이 중복 허용 추출을 하는 것과 달리, 이 논문의 블록들은 서로 겹치지 않는다. 실제 응용에서는 블록 크기를 조정하거나 일부 겹치는 구간을 사용하는 방법이 유용할 수도 있다. 그러나 이런 수정이 원래 정리의 이론적 보장을 자동으로 유지하는 것은 아니다.
넷째, 제안 추정량의 구성요소인 plug-in 대신 모수적 추정량 또는 꼬리분포에 관한 구조적 가정을 활용하는 방법도 고려할 수 있다. 특히 N = 250, α = 0.01 같은 상황에서는 극단 꼬리의 표본만으로 ES를 신뢰성 있게 추정하기 어렵기 때문에, 모수 정보를 결합하는 연구가 중요하다.
다섯째, 실제 금융시계열은 독립이 아닐 수 있고 비정상(non-stationary)일 수도 있다. 따라서 실무에서는 추정값 자체의 통계적 성능뿐 아니라 backtesting을 통해 평가하는 문제도 중요하다. 마지막으로 저자들은 이 아이디어가 ES를 넘어 distortion risk measures라는 더 넓은 위험 측도에도 확장될 수 있다고 본다.
이 절이 중요한 이유는 논문이 주장하는 ‘최적’이 아무 조건에서나 실무에서 완벽하다는 뜻이 아님을 보여주기 때문이다.
- i.i.d. 가정이 현실과 다를 수 있다. 금융 수익률·손실에는 시간에 따른 변동성과 종속성이 나타날 수 있다.
- 표본 수 부족은 강건한 추정량만으로 해결하기 어렵다. 추정하려는 꼬리에 데이터가 사실상 없으면 추가 가정이 필요할 수 있다.
- 이론적 최적성과 실제 포트폴리오 위험예측 성능은 연결되어 있지만 같은 질문은 아니다.
따라서 추후에 진행할 프로젝트에서는 논문과 동일한 i.i.d. 실험을 먼저 재현한 뒤, 데이터 변조와 분포를 바꾸는 실험으로 확장하는 것이 자연스럽다.
1.7. Structure of the paper (원문 p. 12)
나머지 논문의 구성은 다음과 같다.
- Section 2: 핵심 정리인 Theorem 1.4와 Theorem 1.8의 증명.
- Section 3: 제시한 오차 한계가 왜 optimal인지에 관한 결과.
- Section 4: Pareto dist에서의 구체적인 계산과 기존 plug-in 추정량에 대한 하한.
- Section 5: 다양한 분포와 조건에서의 수치실험.
- Section 6: i.i.d. 가정을 완화해 종속적인 데이터로 확장하는 방법.
논문이 제기하는 문제는 간단하다. 우리가 모르는 실제 손실분포의 ES를 제한된 데이터로 추정할 때, 기존 plug-in 추정량은 극단적인 관측값과 유한 표본이라는 현실에 취약하다.
논문의 해결 방법은 전체 데이터의 plug-in 추정값을 기본으로 하되, 블록별 ES 추정값의 분위수로 만든 신뢰할 만한 구간으로 결과를 제한하는 것이다. 이 구조가 중요한 이유는 평소에는 전체 데이터를 사용하면서도, 일부 데이터가 추정량을 극단적으로 밀어 올릴 때 그 영향을 제한하기 때문이다.
앞으로 확인할 것은 세 가지다. (1) §2에서 어떻게 확률적 오차 보장을 증명하는지, (2) §3–4에서 왜 이 성능이 최적이라고 말할 수 있는지, (3) §5에서 실제로 기존 방법과 얼마나 차이가 나는지다.
| 기호 | 의미 |
|---|---|
| X | 무작위 금융 손실; 값이 클수록 손실이 큼 |
| α | 위험 꼬리 비율 (예: 0.1은 최악의 10%) |
| VaRᵤ(X) | 손실의 u 분위수 |
| ESα(X) | 실제 ES, 우리가 알고 싶은 참값 |
| F_X | 실제 누적분포함수 |
| F̂_N | 경험적 누적분포함수 |
| N | 전체 표본 개수 |
| T̂_N | 기존 전체 표본 plug-in ES 추정량 |
| m, n | 블록당 표본 개수, 블록 개수 |
| T̂_Ij | j번째 블록의 plug-in ES 추정량 |
| Q̂(β) | 블록별 추정값의 경험적 분위수 |
| Ŝ_N | 논문에서 제안하는 절단형 강건 ES 추정량 |
| β₁, β₂ | 추정량을 제한할 구간을 정하는 분위수 수준 |
| σ | ES 추정 오차에 연결된 점근 표준편차 |
| L | 분위수 함수의 Lipschitz 상수 |
| ε | 정규화된 오차 크기 매개변수 |
| δ | 허용 실패확률; 신뢰수준은 1−δ |
| K | 변조된 관측치 수 |
다음 편에서는 무작정 수식을 옮기기보다는 (1) 필요한 Lemma, (2) 추정 오차를 두 부분으로 나누는 방식, (3) 블록 중앙부의 집중 현상, (4) 강건성 증명을 연결해서 읽을 예정이다.
Bartl, D., & Eckstein, S. (2026). Optimal Nonparametric Estimation of the Expected Shortfall Risk. arXiv:2405.00357v2. https://arxiv.org/abs/2405.00357